Python爬取网易云3200万热评:用数据看清,谁是真正的"真爱粉"!(附代码)
- 2026-09-05 15:55:57
网易云音乐的评论区,藏着当代年轻人的情绪树洞。
但手动翻页看到第100页,手指都要抽筋了!
Python自动化监听 · 网易云音乐评论CSV导出
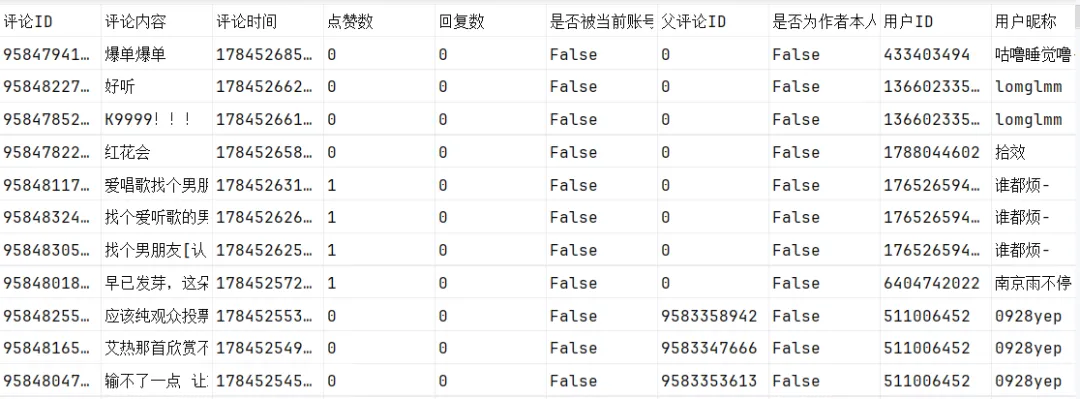
想做歌词情感分析?想看看哪个粉丝是真正的“榜一大哥”?面对动辄上万条的评论,手动复制粘贴显然不现实。今天分享一个基于 DrissionPage 的进阶爬虫项目,通过监听网页接口,精准拦截网易云音乐的评论数据包,一次性将评论内容、点赞数、VIP等级、IP归属地等18个维度的数据“搬”进Excel表格。
第三方库安装教程:
核心依然是 DrissionPage,负责接管浏览器和拦截接口!
pip install DrissionPage送请求与监听接口示例代码
01 导入模块与CSV初始化(18个字段全覆盖)
import csvimport timefrom DrissionPage import ChromiumPageurl = 'https://music.163.com/song?id=3407933090'f = open('网易云音乐评论.csv', mode='w', encoding='utf-8-sig', newline='')csv_writer = csv.DictWriter(f, fieldnames=['评论ID', '评论内容', '评论时间', '点赞数', '回复数','是否被当前账号点赞', '父评论ID', '是否为作者本人','用户ID', '用户昵称', 'VIP类型', 'VIP等级','是否拥有音乐包', '是否拥有RED+', 'IP归属地','头像地址', '头像挂件', '资源ID'])csv_writer.writeheader()
02 启动监听与处理iframe嵌套
dp = ChromiumPage()print('🟢 开始监听评论接口...')# 网易云的核心评论接口dp.listen.start('weapi/comment/resource/comments/get')dp.get(url)# ⚠️ 关键点:网易云音乐的主体内容在 iframe 里iframe = dp.get_frame('#g_iframe')iframe.wait.ele_displayed('css:.u-page', timeout=10)
03 智能翻页与复杂JSON解析
page = 1while True:print(f'📄 正在爬取第 {page} 页')resp = dp.listen.wait(timeout=8)if not resp:print('⚠️ 未监听到评论接口,结束')breakjson_data = resp.response.bodycomments = json_data.get('data', {}).get('comments', [])if not comments:print('⚠️ 本页无评论,结束')breakfor c in comments:# ===== 深度解析嵌套JSON =====user = c.get('user') or {}vip = user.get('vipRights') or {}redplus = vip.get('redplus') or {}music_package = vip.get('musicPackage') or {}pendant = c.get('pendantData') or {}ip_location = c.get('ipLocation') or {}row = {'评论ID': c.get('commentId'),'评论内容': c.get('content'),'评论时间': c.get('time'),'点赞数': c.get('likedCount'),'回复数': c.get('replyCount'),'是否被当前账号点赞': c.get('liked'),'父评论ID': c.get('parentCommentId'),'是否为作者本人': c.get('owner'),'用户ID': user.get('userId'),'用户昵称': user.get('nickname'),'VIP类型': user.get('vipType'),'VIP等级': vip.get('redVipLevel'),'是否拥有音乐包': music_package.get('rights'),'是否拥有RED+': redplus.get('rights'),'IP归属地': ip_location.get('location'),'头像地址': user.get('avatarUrl'),'头像挂件': pendant.get('imageUrl'),'资源ID': c.get('threadId')}csv_writer.writerow(row)# ===== 自动翻页逻辑 =====next_btn = iframe.eles('css:.zbtn')[-1]if 'js-disabled' in next_btn.attr('class'):print('📌 已到最后一页')breaknext_btn.click()time.sleep(1.5)page += 1print('🎉 爬取完成')f.close()
项目核心亮点解析
🕸️ 攻克 iframe 难题:网易云音乐采用了经典的
iframe嵌套结构,常规爬虫无法直接定位元素。本项目使用dp.get_frame('#g_iframe'),精准切入评论区所在的文档流,解决了“找不到元素”的头号难题。💎 深挖 VIP 特权数据:不仅仅是基础文本,代码深入解析了
vipRights对象,成功提取了VIP等级、音乐包权限、RED+身份以及头像挂件地址,这些数据在做用户画像分析时极具价值。🌍 IP归属地追踪:利用接口返回的
ipLocation字段,抓取用户的评论所在地,可用于后续的地域分布热力图绘制(比如看看这首歌在哪些省份最火)。🔄 自动化翻页兜底:通过检测下一页按钮的
class属性(是否包含js-disabled),优雅地判断翻页终止条件,避免了死循环和报错。
💡 脑洞延展:
拿到这份CSV后,你可以:
用
jieba分词统计高频词汇,生成词云图;筛选
likedCount > 10000的数据,找出“镇评神评”;统计
VIP等级分布,看看氪金大佬们都爱听什么歌。
注:本项目仅用于学习交流与技术研究,请勿高频请求对目标服务器造成压力,遵守网易云音乐 Robots 协议及相关法律法规。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- python入门保姆级指南来了|python自学推荐
- 内网环境装 Python 包不再头疼,这招真香~
- Python site 机制入门:为什么 pip 安装的包能被 import
- PyCharm超全快捷键速查,python小白必看
- 汇总|2026年Python技术应用工程师报考全解析:报考条件、考试安排、证书含金量全汇总(大湾区AI创新成果集中亮相 2026 世界人工智能大会)
- 【GESP】2026年06月Python一级 -- 交税
- DataCabin PHP网站/python程序远程数据舱系统 支持程序应用远程统计公告和更新推送
- ANSYS 有限元热-结构耦合:用 Python 把热分析温度结果传递到结构分析
- 建模时最常用的Python操作全在这,每一个都能帮你省半小时!
- 干货分享|Python网络编程零基础入门教程!附经典书籍PDF