用Python批量下载AI绘画作品——顺便把提示词也带回来了
✦ ✦ ✦
摘要:在 liblib.art 上看到一个喜欢的模型,作品展示区有几千张社区生成的图片,一张张手动保存太累了。我用 Python 写了段脚本,一键批量下载所有图片和对应的生成参数——提示词、采样方法、步数、CFG、种子,全部自动归档。本文记录实现思路,纯技术交流。
✦ ✦ ✦
起因
事情是这样的。我在 liblib.art 上闲逛,看到一个模型的效果特别对胃口,点进作品展示区一看——好家伙,社区用户用这个模型生成了不少图片。
我当时的想法是:这些图要是能全部拉下来,加上每张图对应的提示词和参数,不管是用来分析这个模型的风格偏好,还是给后续项目做素材参考,都很有价值。
但真要我一张张点开、右键保存、再复制参数——几千张图,手得废掉。得想个办法让它自己干。
捋一下思路
打开浏览器开发者工具看了看,发现 liblib 的页面是前后端分离的,作品数据走的是 API。那事情就简单了:搞清楚 API 怎么调,剩下的交给代码。
整个流程分三步:
第一步,调 API 把作品列表全拉下来,拿到每张图的 UUID。
第二步,拿 UUID 去详情页把图片和参数提取出来。
第三步,加个断点续传机制,万一中途断了不用从头再来。
拿 UUID
作品展示区的数据是通过一个接口返回的:
POST https://api2.liblib.art/api/www/community/returnPicList
参数很简单,传模型的 UUID、每页条数、页码就行:
{ "uuid": "模型的UUID", "pageSize": 100, "page": 1}
每次返回 100 条,翻页遍历完所有页面,所有作品的 UUID 就到手了。
提取图片和参数
拿到 UUID 之后,访问作品的详情页:
https://www.liblib.art/imageinfo/{uuid}
页面的 HTML 里嵌着一份完整的服务端渲染数据,图片地址和生成参数都在里面。顺着这个路径找就行:
data → props → pageProps → data → imagesV2[0][0]
能拿到的东西还挺全的:
| |
originalImageUrl | |
generateInfo.prompt | |
generateInfo.negativePrompt | |
generateInfo.samplingMethod | |
generateInfo.samplingStep | |
generateInfo.cfgScale | |
generateInfo.seed | |
每张图生成两个文件,图片和参数分开存:
001 - 作品标题.png ← 原图001 - 作品标题.txt ← 提示词 + 参数
断点续传
几千张图,下载过程中可能断网、可能报错、可能想关电脑走人。所以必须支持断点续传。
方案是在输出目录维护一个检查点文件:
{ "uuids": ["...所有UUID"], "completed": ["...已成功的"], "failed": ["...失败的"]}
每成功下载一张就更新一次。下次启动时加个参数,自动跳过已完成的,继续处理失败的。
几个小细节
图片地址
SSR 数据里的 originalImageUrl是原图,不带水印。如果这个字段为空,可以回退到 imageUrl或 coverUrl。
隐藏参数
有些作品设置了隐藏参数,SSR 数据里不包含生成信息。这种情况在 txt 里标注一下就行,不影响图片下载。
请求间隔
API 请求间隔 0.5-1 秒,图片下载间隔 2-4 秒,不给服务器添麻烦。
实际效果
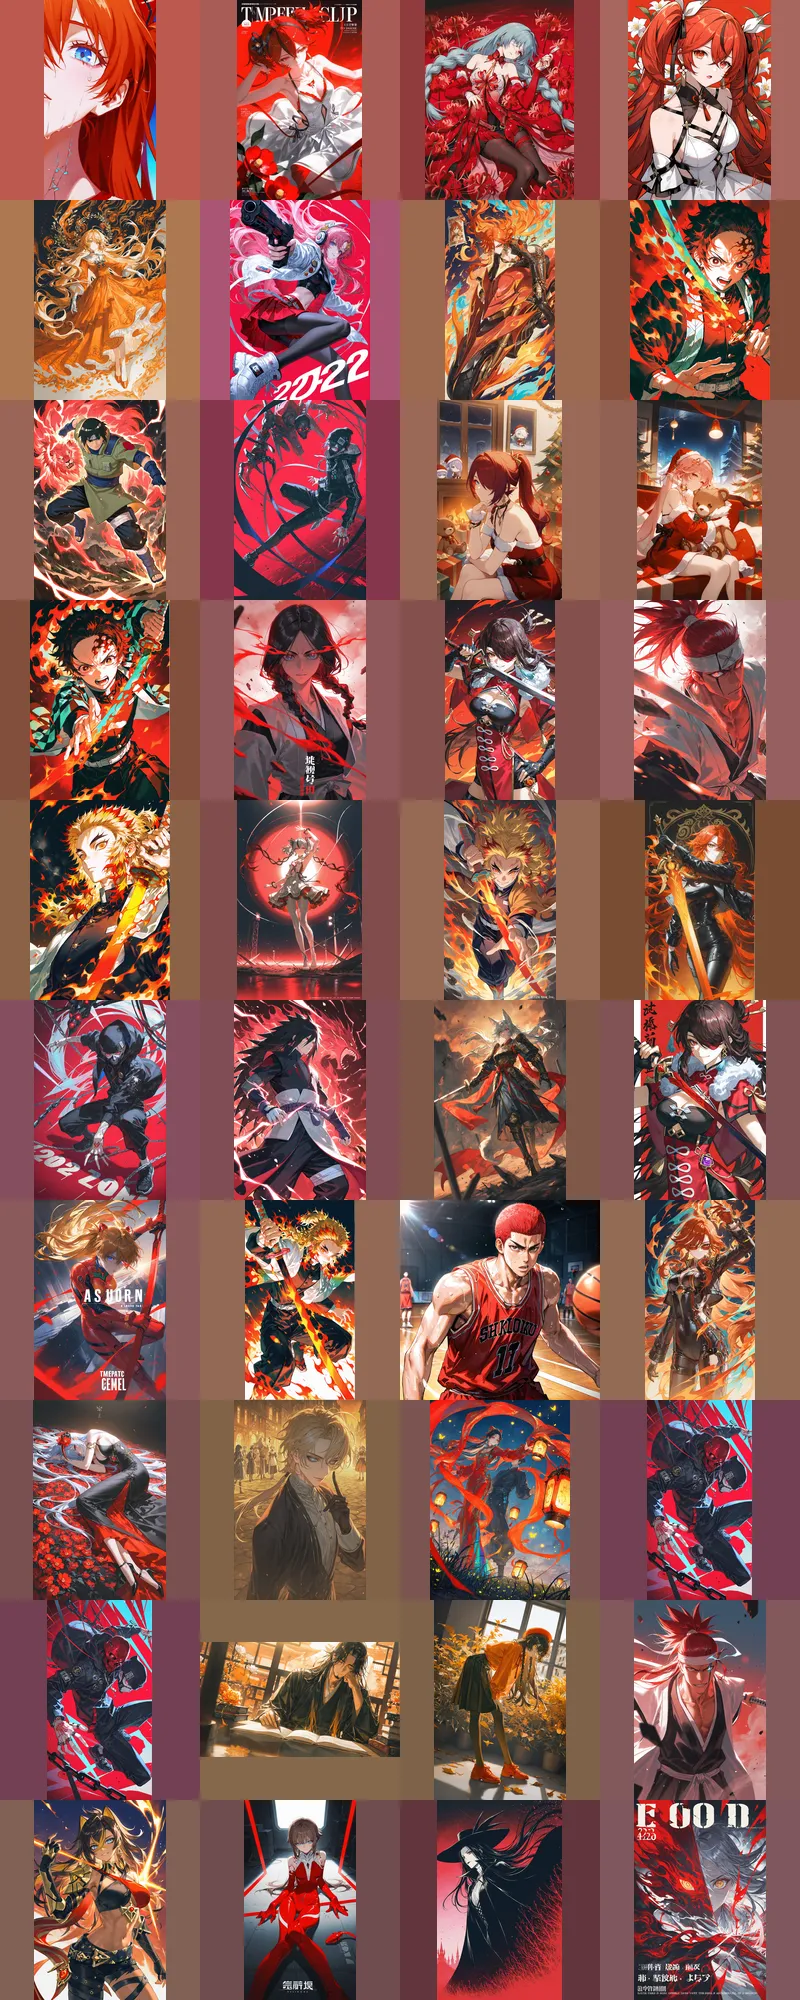
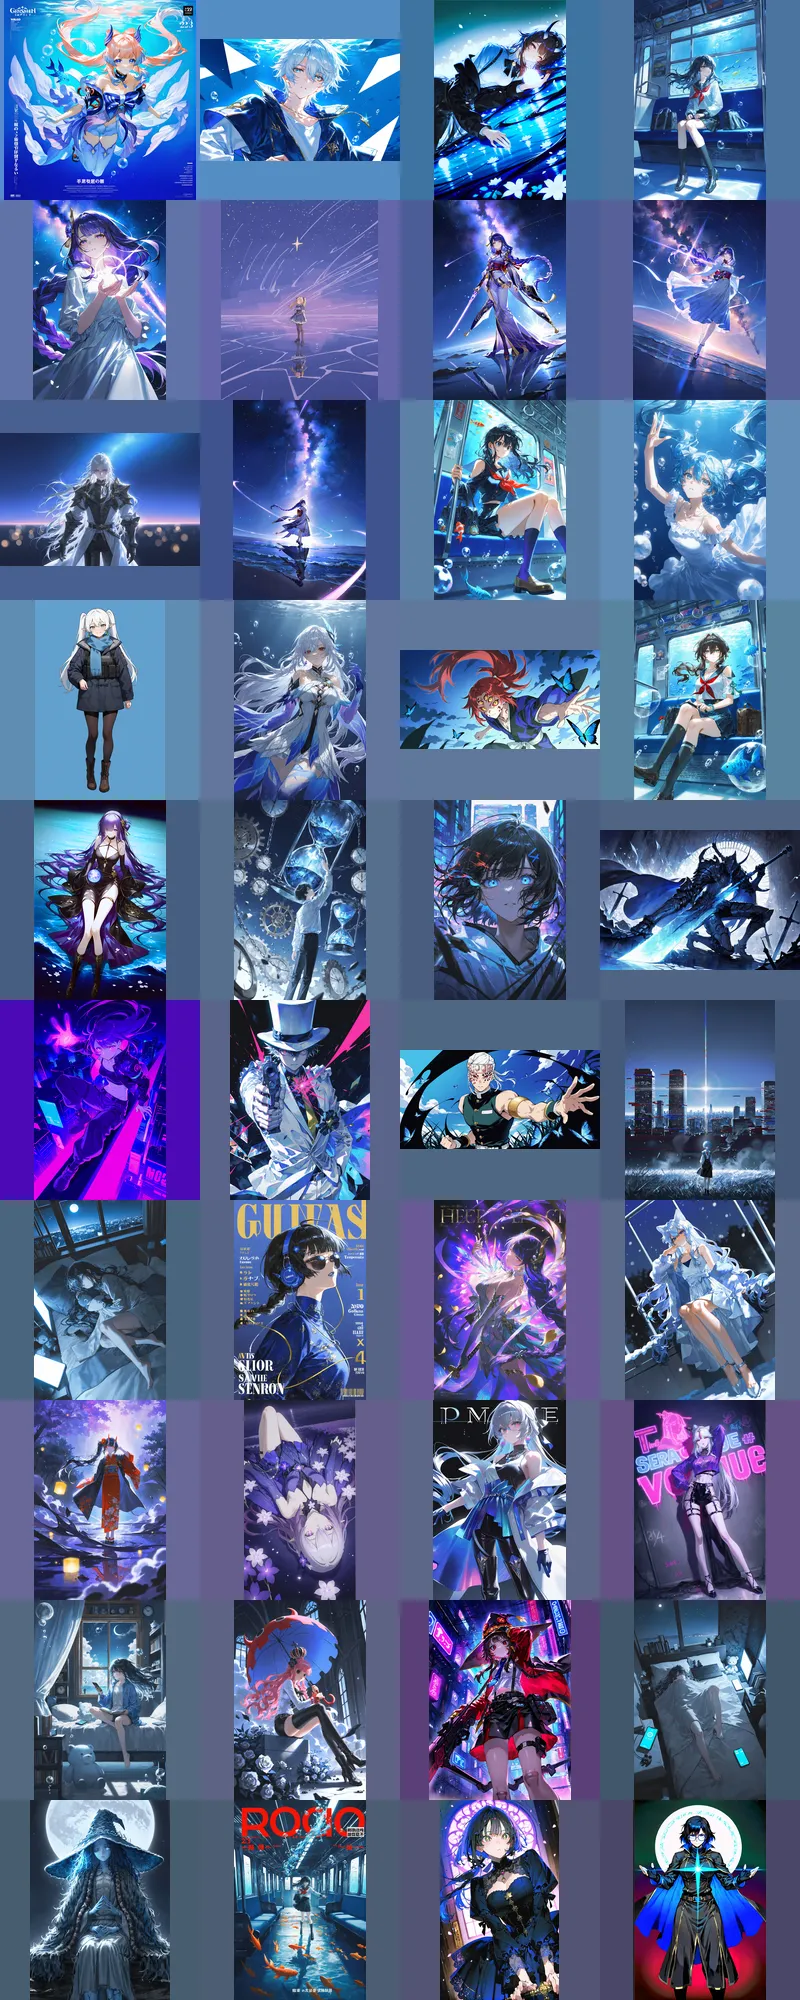
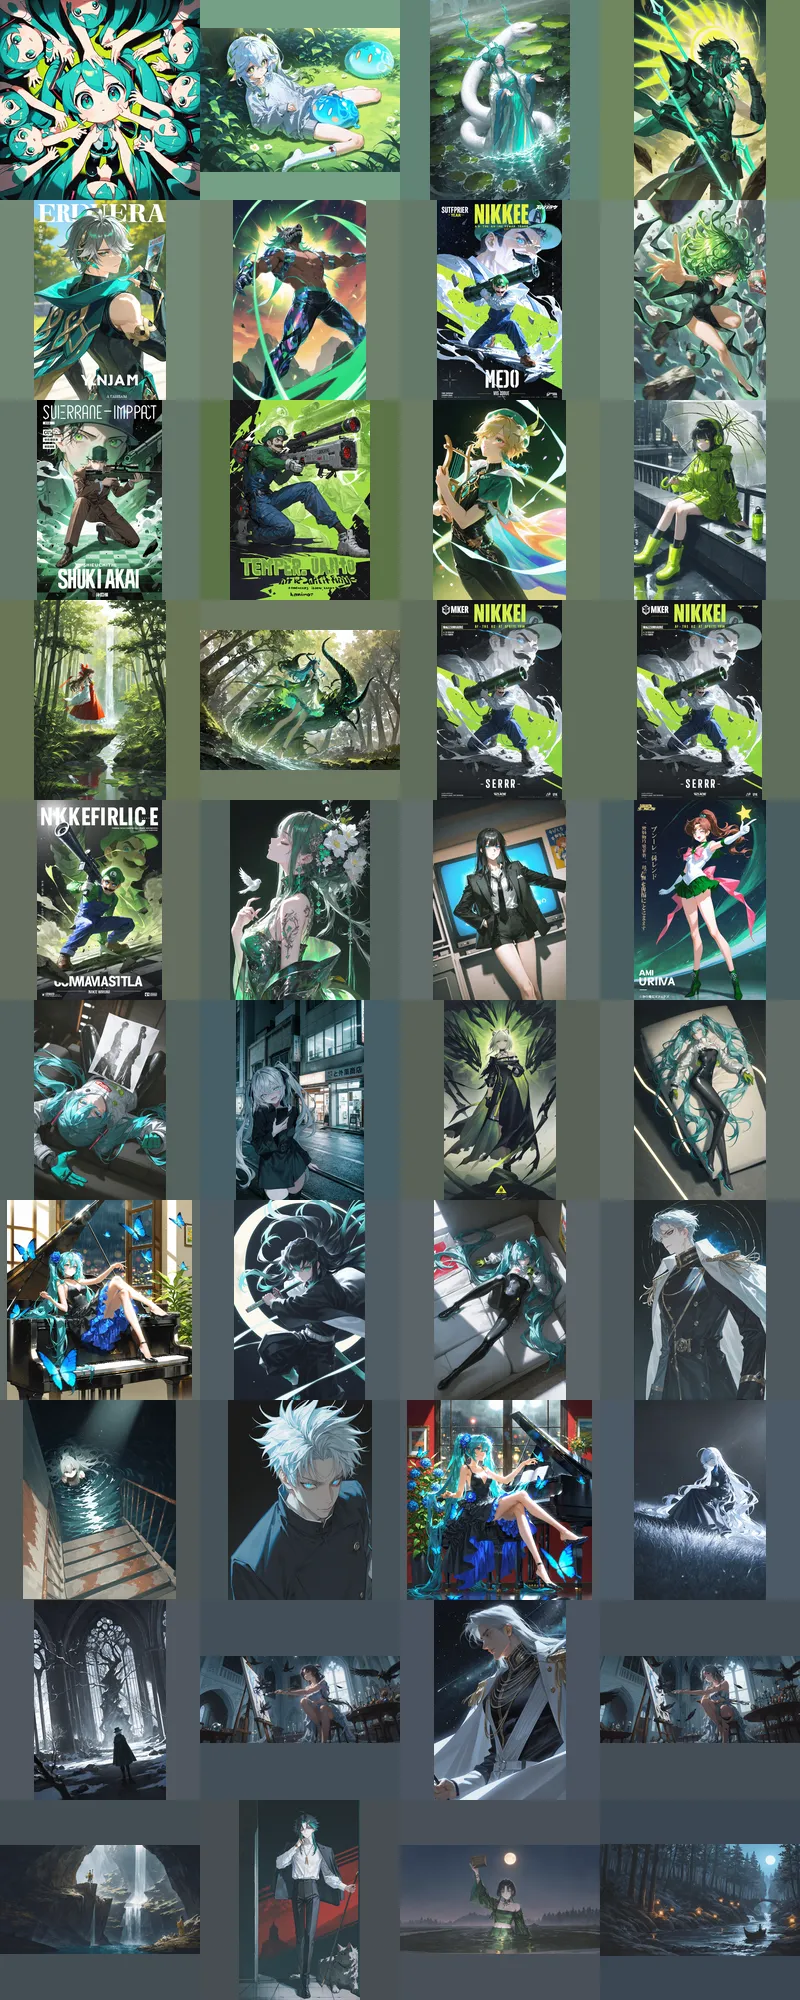
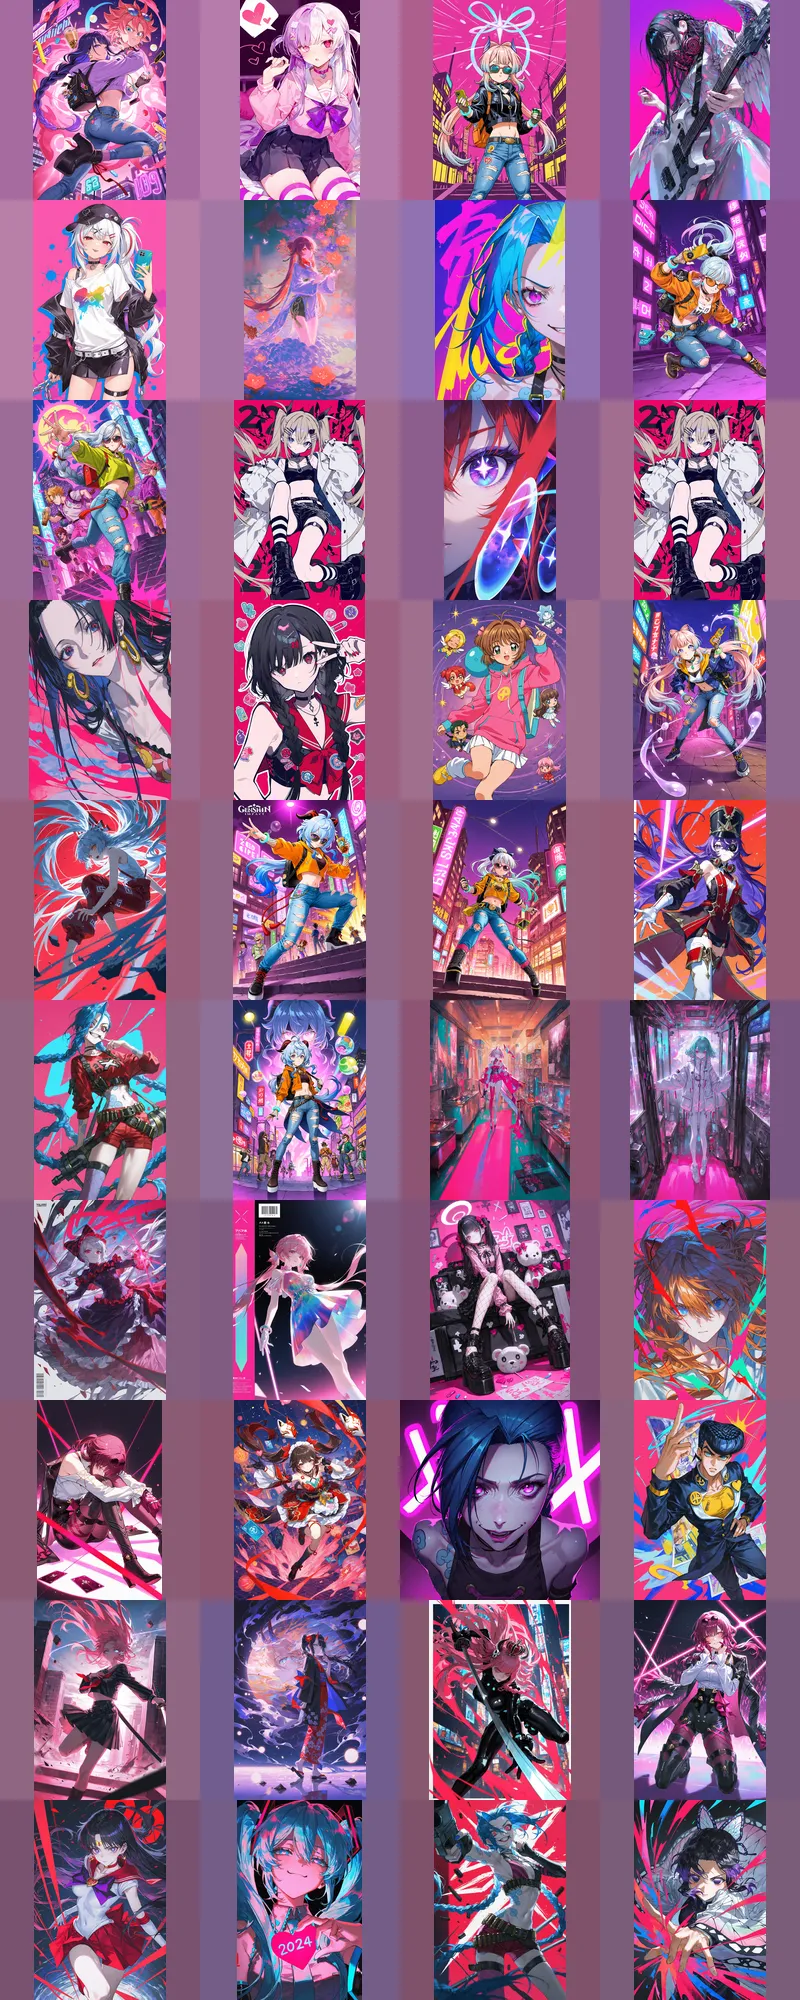
拿一个模型试了试(绪儿大佬的红尘白梦),下载下来的图片拼了几张图,效果还不错:
有了数据能做什么
这批「图片 + 参数」数据拿到手之后,能做的事情还挺多的:
提示词词频统计——看看大家用这个模型时最喜欢写什么关键词参数分布分析——步数、CFG、采样方法,社区用户的偏好一目了然图生图参数还原——看到喜欢的风格,反推它的生成配置数据集构建——为模型训练或风格迁移准备素材
✦ ✦ ✦
仅供学习交流,请遵守 liblib.art 的用户协议。
— 完 —
 10个月宝宝每天需要喝多少奶粉?