你的AI又双叒忘了你教过的话?
3个Python脚本,让它"教一次,记一辈子" 可运行的避坑方案原创 · Agent 自进化手记 · 内含可直接用的脚本清单 · 阅读约 5 分钟你有没有这种体验:辛辛苦苦教 AI 写作——
"别写'她泪流满面',要写'她转身时围巾被车门夹住,他没提醒'。"
它当场改好了,你还夸了一句。
第二天新开一个对话,它又甩给你一句"她泪流满面,心都碎了"。
你盯着屏幕,深吸一口气。这活儿,不叫用 AI——叫给一个天生失忆的实习生当全职复读机。一、为什么总是"教了白教"
主流 AI 的交互模式,本质是一次性对话。
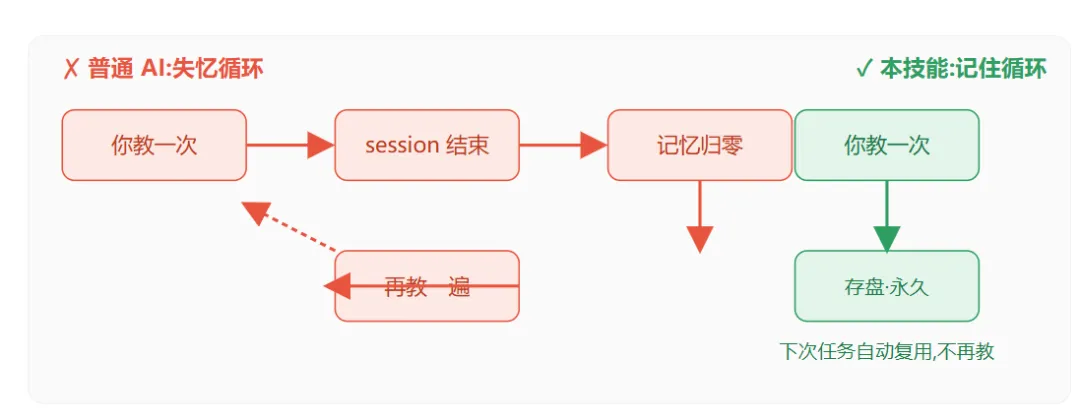
你的赞美、纠正、口味偏好,全活在那一回合的上下文窗口里。session 一关,窗口销毁——你的所有"教",跟着一起归零。
"走样 → 重教 → 再走样"的循环,恰恰是 token 消耗的隐形黑洞。
左:每次重教,无限循环。右:教一次落盘,长期复用。
二、稀缺性:所有人都在"重训",没人做"记住"
这两年 AI 训练范式已进化到"预训练 + 后训练"(SFT / DPO / KTO / GRPO)。
但打开任何教程,都在教你怎么用 GPU 微调模型。微调要显卡、要几百条数据、怕"灾难性遗忘"——单人创作者根本用不起、也不该用。
市面上的 RAG 教程,只讲"把文档塞进向量库"。没人在做一件事:让 Agent 自己的偏好和口味,结构化沉淀、跨 session 自动复用。
反常识冷知识
你教 AI 一次具体的"怎么写",消耗的 token 成本 ≈ 把这条偏好存盘后、连续自动注入 200+ 次的总和。也就是说,教一次之后如果不再教,你实际是在替 AI 重复付费。这套方案的稀缺点:把"教一次、自动记住、立刻生效"做成了可运行、零依赖、零算力的闭环。三个 Python 脚本,读盘即跑,不碰 GPU、不烧钱。
三、横向对比:它到底强在哪
注:微调一个 LoRA 适配器在云 GPU 上约 ¥5–20/次,但需几百条样本才有意义。本方案零成本。
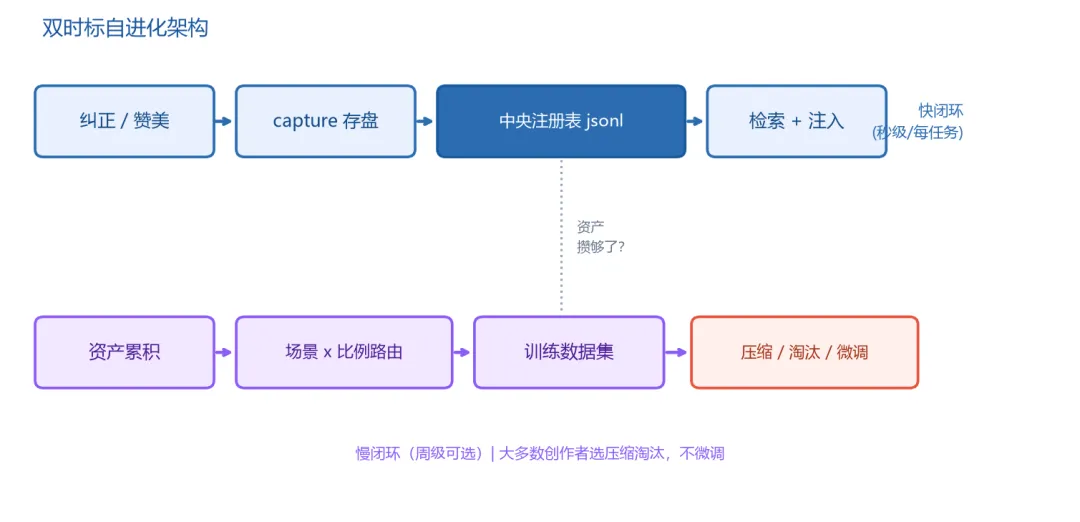
快闭环即时生效、零成本;慢闭环可选——创作者直接选压缩淘汰。
四、怎么用:三步,零训练
1教一次 — 你纠正 AI 时,一条命令把"负样本 + 正样本 + 场景标签"存进注册表。比如:告别场景别写流泪,写动作细节。2自动记 — 新任务启动,脚本按场景拉相关偏好注入 context。你不用再开口。3周期整理 — 资产多了跑 build_manifest.py 出数据集。如果你跟我一样是创作者,直接选压缩/淘汰,不碰微调。
五、token 反而更省?
表面看,注入资产会多花一些 token。但真正的消耗大头不是注入,是探索。
"走样 → 重教 → 再走样",每次纠正都是额外轮次。偏好注入把这条路堵死,所以:不仅更准,还更省。
净成本 = 基础任务 token + 资产加载 token − 被替掉的探索 token。只要加载 < 替掉的探索,就是净省。
六、它做不到什么(诚实的边界)
所有自进化系统都有工程约束,先承认局限,比吹"万能"靠谱一万倍。
⚠ 五个真实局限
上下文预算 — 资产无限涨会撑爆 context。必须定期压缩/蒸馏/淘汰(内置了四级压缩流水线来应对)。资产会陈旧 — 经验会过期(API 变了、用户口味变了)。需要版本标记 + 定期失效机制。冷启动 — 前 N 个任务没有资产可 RAG,得靠基础模型 + 少量种子 SOP 撑住。评估难题 — agent 自己说自己变强了不算数。需要独立 eval set 守门,"先验证后答"。遗忘风险 — 如果未来接了慢闭环做权重更新,只用新资产训练会忘掉旧能力,必须保留 replay buffer。
七、下一步:从"记住偏好"到"真正进化"
现在落地的是快闭环(资产层)。靠文件系统 + RAG 注入,权重零改动,立刻生效。
但它有天花板:资产多到上下文装不下怎么办?答案是——
🚀 突破路径:慢闭环(权重层)
Step 1 — 资产回流:周期性地把注册表里的高质量偏好(DPO 对 / SFT 示范),通过 build_manifest.py 归一化成标准训练数据集。Step 2 — 场景路由:按场景标签 × 信号类型(DPO/KTO/GRPO/SFT)自动分配采样比例,不同场景用不同目标函数训练。Step 3 — 权重更新:调用云 GPU 或 fine-tune API,产出 LoRA 适配器。偏好直接"烧"进权重,不再每次注入。Step 4 — Eval 守门:训练后跑独立评估,不过关不回滚。确保"变强了"是事实,不是感觉。快闭环已解决 90% 的"教了白教"痛点。慢闭环是资产上千条后的豪华升级——到那时,你还有第二个选择:继续压缩淘汰、不上微调,完全够用。
📋 如果你想立刻落地,这是速查清单
☐ 确认你有 Python 3.8+,纯标准库、零 pip install☐ 设环境变量 AGENT_ASSET_HOME,指向注册表目录☐ 每次纠正 AI 后,跑 capture_asset.py 存偏好☐ 每次新任务前,跑 retrieve_assets.py 自动注入☐ 每月跑一次 build_manifest.py 看资产总量,超 500 条就压缩淘汰已开源 GitHub · agent-asset-loop
不神奇,只是把"教 AI"从重复劳动,变成一次投资。你的口味,值得被记住。
如果这篇文章让你觉得"终于有人做了这件事",
点个「在看」或转发给同样被 AI"气到重教"的创作者朋友。本文基于 post-scaling-law 资产闭环实践整理 · 开源地址: github.com/jrf2ssw82y-pixel/agent-asset-loop · 转载请注明出处