在 Python 或 C++ 中使长期运行的 NVIDIA TensorRT 引擎构建过程可观测且可取消
2026年7月22日
- IProgressMonitor(在 NVIDIA TensorRT 中已提供数个版本)支持细粒度、线程安全的进度追踪和引擎构建期间的取消操作,这对于管理漫长的构建时间和避免浪费 GPU 计算资源至关重要。
- 该 API 要求在 Python 和 C++ 中重写三个方法(phase_start、step_complete、phase_finish),以追踪嵌套的构建阶段、更新进度,并在步骤边界处处理取消请求,确保对用户中断或程序化停止信号的响应能力。
- 集成 IProgressMonitor 允许将实时进度报告发送至终端、IDE、HTTP 服务或代理运行时,并将构建逻辑与应用层面的渲染或流式传输解耦,同时需要谨慎处理线程安全、stdout 重定向、取消延迟以及过早阶段终止等边缘情况。
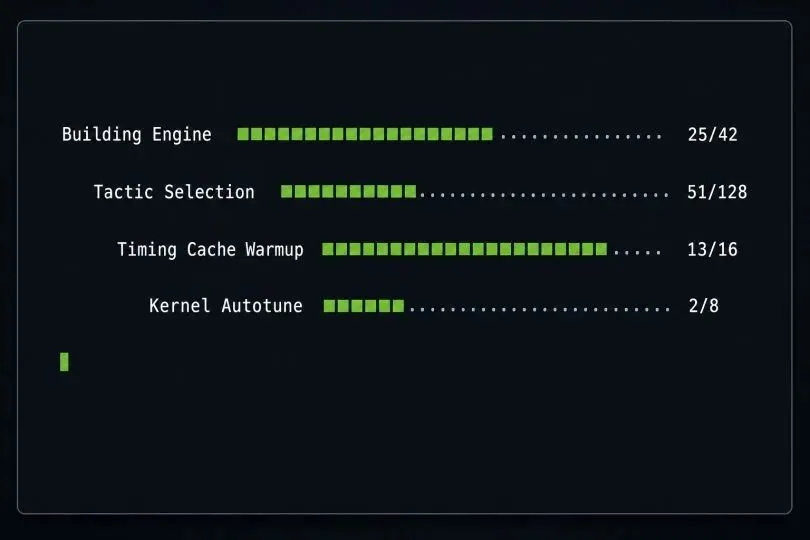
TensorRT 引擎构建可能需要几秒到几十分钟不等。大型强类型模型、深度战术搜索以及全新 GPU SKU 上的冷启动计时缓存,可能导致开发者、最终用户或 AI 代理面对一个冻结的终端,却不知道该等待、重试还是终止进程。大多数 NVIDIA TensorRT 集成在构建期间不提供任何报告,或无法提前中止。在长时间运行的代理工作流中,这会导致 GPU 工时浪费和会话卡死。
_图 1. 由 IProgressMonitor 子类渲染的 TensorRT 引擎构建的实时嵌套进度条_
TensorRT 提供了 IProgressMonitor API 来解决此问题,该接口已在 NvInfer.h 中存在数个版本。本教程将逐步演示 Python 和 C++ 的最小化即插即用实现,添加响应 Ctrl-C 或来自外部事件循环的程序化停止信号的取消路径,并展示如何将生成的进度流暴露给 IDE、服务或代理运行时使用。
本文中的每个代码块均提取自或基于两个 NVIDIA 维护的开源示例:
- Python: samples/python/simple_progress_monitor/ (ResNet-50,强类型网络)
- C++: samples/sampleProgressMonitor/ (MNIST)
IProgressMonitor 提供什么
IProgressMonitor 是一个抽象基类,TensorRT 在引擎构建期间会调用它。您只需子类化并重写三个方法。其结构在 Python 和 C++ 中完全相同,仅拼写不同。
| 概念 | Python 方法 | C++ 方法 | 操作内容 |
| 进入阶段 | phase_start(phase_name, parent_phase, num_steps) | phaseStart(phaseName, parentPhase, nbSteps) | 预留进度行并记录 num_steps 。 |
| 阶段内步骤完成 | step_complete(phase_name, step) -> bool | stepComplete(phaseName, step) -> bool | 推进进度条。返回 False / false 以取消构建。 |
| 退出阶段 | phase_finish(phase_name) | phaseFinish(phaseName) | 销毁该行。 |
_表 1. IProgressMonitor 接口在 Python 和 C++ 中的镜像。这三个方法具有相同的语义,且 step_complete 是唯一返回值会影响构建器行为的回调_
父阶段(parent_phase)非空的阶段嵌套在另一个阶段内部,因此监视器看到的是进度树而非扁平列表。该实现必须是线程安全的,因为 TensorRT 可以从多个内部线程调用同一个监视器实例。
通过将监视器连接到构建器,即在 IBuilderConfig 上设置它。这在两种语言中都只需一次调用:
config.progress_monitor = MyMonitor() # Python
config->setProgressMonitor(&myMonitor); // C++
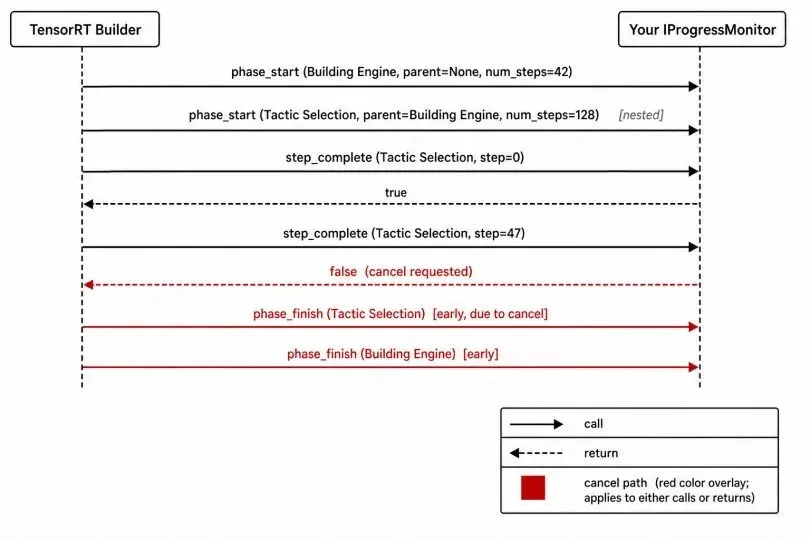
_图 2. TensorRT 在构建期间驱动的回调序列,其中红色高亮显示了取消路径_
从上到下阅读该图表。构建器以 phase_start 打开“构建引擎”阶段,然后在其内部打开“战术选择”阶段,其 parent_phase 指回“构建引擎”。随着构建的进行,构建器调用 step_complete(实线箭头),而你的监视器返回一个布尔值(虚线箭头):true 让构建继续,false 请求取消。在此显示的运行中,监视器在第 47 步返回 false,即红色取消路径,构建器停止发出新步骤并展开栈帧。它在“战术选择”上提前调用 phase_finish,然后在“构建引擎”上调用,按相反顺序关闭所有活动阶段。
本教程构建的内容
本教程展示了如何在 Python 和 C++ 中实现 IProgressMonitor,通过 step_complete 添加取消功能,并将进度更新路由到终端、IDE、服务或代理运行时。
先决条件
- TensorRT(当前开源版本)及其 Python 绑定,或 C++ 示例的构建。
- Python 3.10 或更高版本(Python 路径)。
- TensorRT 示例数据:用于 Python 的 ResNet-50 ONNX 和用于 C++ 的 MNIST ONNX。两者都随 sample-data 归档文件提供,或在官方 NGC 容器下挂载于 /usr/src/tensorrt/data。
- 支持 ANSI 虚拟终端转义序列的终端。任何现代 Linux shell 均符合要求;如果启用了 VT,Windows Terminal 也可用。
1. 在 Python 中对 IProgressMonitor 进行子类化
该类很小。它仅跟踪哪些阶段处于活动状态以及每个阶段包含多少步骤。
import tensorrt as trt
from dataclasses import dataclass, field
from threading import Lock
@dataclass
class _PhaseState:
num_steps: int
current_step: int = 0
parent: str | None = None
class RichProgressMonitor(trt.IProgressMonitor):
def init(self):
super().init()
self._lock = Lock()
self._phases: dict[str, _PhaseState] = {}
self._cancelled = False
self._rendered_lines = 0
def phase_start(self, phase_name, parent_phase, num_steps):
with self._lock:
self._phases[phase_name] = _PhaseState(
num_steps=num_steps, parent=parent_phase
)
self._render()
def step_complete(self, phase_name, step) -> bool:
with self._lock:
if phase_name in self._phases:
self._phases[phase_name].current_step = step
self._render()
return not self._cancelled
def phase_finish(self, phase_name):
with self._lock:
self._phases.pop(phase_name, None)
self._render()
有两点需要注意。首先,Lock(锁)不是可选的。TensorRT会从多个内部线程调用监控器,如果由不拥有状态的线程进行渲染,会导致显示撕裂。其次,step_complete是唯一可以停止构建的回调函数。phase_start返回None,因此你不能在阶段开始之前拒绝它。最早的取消点是该阶段的第一个step_complete。
2. 使用虚拟终端转义序列渲染嵌套进度条
渲染器是随环境变化最大的部分,因此本节给出形状示例,并指向生产级实现的上游样本。模式如下:
def _render(self):
按嵌套深度对阶段排序,以便子阶段绘制在父阶段下方。
rows = sorted(
self._phases.items(),
key=lambda kv: (kv[1].parent or "", kv[0]),
)
光标向上移动的行数应等于上一次渲染打印的行数,
而不是当前行数——阶段在嵌套时添加,在phase_finish时移除,
因此当树结构改变时,两者恰好不同。
if self._rendered_lines:
print(f"\x1b[{self._rendered_lines}A", end="")
for name, st in rows:
step是[0, num_steps)中的基于0的索引;+1将其转换为
完成计数,以便进度条实际上可以达到100%。
done = min(st.current_step + 1, st.num_steps)
pct = done / max(st.num_steps, 1)
bar = "█" * int(40 * pct) + "·" * (40 - int(40 * pct))
indent = " " if st.parent else ""
print(f"\x1b[2K{indent}{name:<28} [{bar}] {done}/{st.num_steps}")
清除阶段完成且数量减少后留下的行。
for _ in range(self._rendered_lines - len(rows)):
print("\x1b[2K")
self._rendered_lines = len(rows)
上游的simple_progress_monitor.py以改进的颜色和宽度处理渲染相同的形状。转义序列\x1b[NA将光标向上移动_N_行,而\x1b[2K清除一行。第一次渲染调用写入空白行;后续调用就地覆盖它们。
当附加此监控器时,请勿将stdout重定向到文件或管道。转义码将被原样写入日志,使其无法阅读。对于非终端接收器,请用结构化发射器替换_render()。
3. 添加取消路径
一旦监控器存在,取消功能只需三行代码即可添加。安装一个翻转标志的 SIGINT 处理器,然后让 step_complete 尊重该标志。
import signal
def install_cancel(monitor: RichProgressMonitor):
def handler(signum, frame):
monitor._cancelled = True
print("\nCancelling TensorRT build at next step boundary...")
signal.signal(signal.SIGINT, handler)
连接监控器并运行构建器:
builder = trt.Builder(TRT_LOGGER)
network = builder.create_network(
1 << int(trt.NetworkDefinitionCreationFlag.STRONGLY_TYPED)
)
parser = trt.OnnxParser(network, TRT_LOGGER)
with open(onnx_path, "rb") as f:
parser.parse(f.read())
config = builder.create_builder_config()
monitor = RichProgressMonitor()
config.progress_monitor = monitor
install_cancel(monitor)
serialized = builder.build_serialized_network(network, config)
if serialized is None:
if monitor._cancelled:
print("Build cancelled cleanly.")
else:
print("Build failed.")
build_serialized_network() 在取消时返回 None。构建器会在下一个步骤边界展开,通常很快,但并非瞬时,特别是在长时间的战术搜索步骤内。
应用程序应向用户展示取消延迟。在展开窗口期间一个简单的“正在取消…”消息能极大改善体验。
同一标志也可以从任何非信号路径设置,例如 IDE 停止按钮、代理超时或 CI 取消 Webhook。设置 monitor._cancelled = True,构建将在下一个步骤边界中止。
4. C++ 中的相同模式
include <NvInfer.h>
include <atomic>
include <mutex>
include <unordered_map>
class RichProgressMonitor : public nvinfer1::IProgressMonitor {
public:
void phaseStart(char const* phaseName,
char const* parentPhase,
int32_t nbSteps) noexcept override {
std::lock_guard<std::mutex> g(mu_);
phases_[phaseName] = {nbSteps, 0, parentPhase ? parentPhase : ""};
render();
}
bool stepComplete(char const* phaseName,
int32_t step) noexcept override {
std::lock_guard<std::mutex> g(mu_);
auto it = phases_.find(phaseName);
if (it != phases_.end())
it->second.current = step;
render();
return !cancelled_.load();
}
void phaseFinish(char const* phaseName) noexcept override {
std::lock_guard<std::mutex> g(mu_);
phases_.erase(phaseName);
render();
}
void requestCancel() noexcept {
cancelled_.store(true);
}
private:
struct Phase {
int32_t nbSteps;
int32_t current;
std::string parent;
};
std::mutex mu_;
std::unordered_map<std::string, Phase> phases_;
std::atomic<bool> cancelled_{false};
void render() noexcept;
};
以相同方式附加:
auto config =
std::unique_ptr<nvinfer1::IBuilderConfig>(
builder->createBuilderConfig());
RichProgressMonitor monitor;
config->setProgressMonitor(&monitor);
用于取消标志的 std::atomic<bool> 很重要,因为 requestCancel() 可能从另一个线程或信号处理器中调用。其余部分与 Python 版本镜像一致。
在真实系统中何处接入
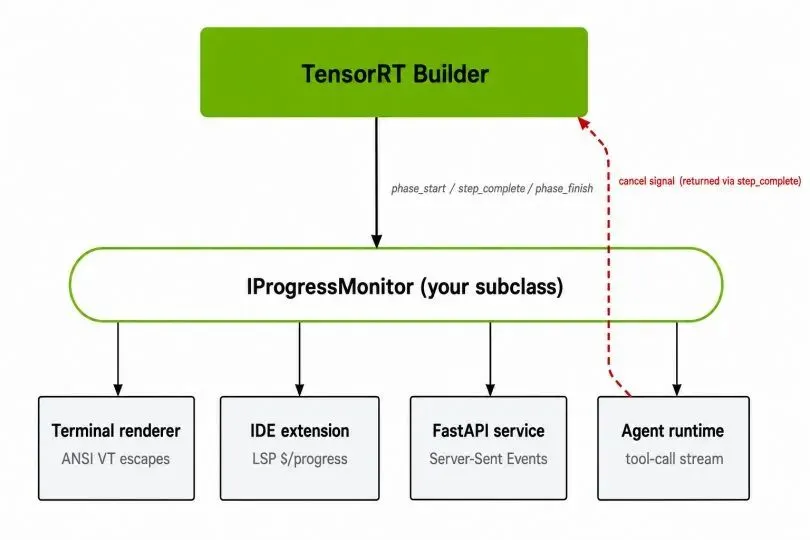
_图 3. IProgressMonitor 是构建器与应用界面之间的单一集成点_
取消箭头是从代理运行时绘制的,为了具体说明,但相同的机制适用于每个接收端。来自终端的 Ctrl-C、IDE 停止按钮、HTTP 取消 Webhook 或代理超时都会翻转相同的 monitor._cancelled 标志,取消将在下一个 step_complete 返回时生效。在真实系统中何处接入
终端是简单的情况。有趣的集成将进度路由到其他地方:
- IDE 扩展: 重写 _render() 以在语言服务器协议中发出 $/progress 通知,或在协议中使用等效的 window/showProgress。每个阶段成为一个进度令牌;step_complete() 成为报告消息;phase_finish() 成为结束。
- FastAPI / HTTP 服务: 在后台线程上运行构建,并让 _render() 将条目推入 asyncio.Queue,请求处理程序通过服务器发送事件(Server-Sent Events)从中排空。客户端获得实时流;取消钩子只是一个 POST /builds/{id}/cancel,它调用 monitor.requestCancel() 。
- Agent 工具调用: 在每个阶段转换时发出一个结构化块( {"phase": ..., "step": ..., "total": ...} )进入工具调用流。代理运行时将其渲染在用户可见的跟踪中,相同的 requestCancel() 钩子是当构建超出预算时代理超时会调用的内容。此模式对代理运行时也很重要。长时间运行的构建需要可观察且可取消,以便代理可以报告进度、强制执行时间预算并干净地停止。
在所有这三种情况下,IProgressMonitor 都是正确的边界。高于它的任何内容(渲染、流式传输、传输)都是应用程序级别的;低于它的任何内容(策略计时、内核选择)都是构建器的事务。
需要处理的边缘情况
这些行为是常见的集成错误来源:
- 不要在附加终端渲染器时重定向 stdout。转义序列会污染日志。对于非交互式接收端,将渲染器交换为结构化发射器。
- phase_start() 无法取消。它返回 None。最早的取消点是该阶段的第一个 step_complete()。如果用户在漫长的 phase_start() 期间取消,构建将继续进行直到第一个步骤边界。
- phase_finish() 可能在报告所有 num_steps 之前触发。这可能发生在错误恢复、构建器内部短路或 step_complete() 返回 False 时。将其视为权威的阶段结束信号;不要假设 current_step == num_steps。
- 取消延迟是有界的,但不为零。构建器在检查返回值之前会完成当前步骤。漫长的战术搜索步骤可能会将此延迟推至几秒到几十秒的范围。
- 需要线程安全。同一个 monitor 实例从多个构建器线程调用;来自 _render() 的未仪器化 dict 或 unordered_map 访问最终会导致崩溃或数据撕裂。
 10个月宝宝每天需要喝多少奶粉?