深入 Linux DMA-BUF(三):Fence 同步机制与 DMA-BUF Heaps 实战
从 dma_fence 到 DMA-BUF Heaps,一文讲透 DMA-BUF 的同步体系与现代内存分配
本文是《深入 Linux DMA-BUF》系列第三篇。前两篇分别介绍了 dma-buf 的整体架构与零拷贝原理、CPU 访问路径与 Cache 一致性。本篇深入两个前两篇未涉及的核心主题:Fence 同步机制(dma_fence + dma_resv)——解决多硬件并发访问时的时序竞争;以及 DMA-BUF Heaps——取代 ION 的现代内存分配框架。基于 Linux mainline / AOSP GKI kernel。
前两篇讲完了 dma-buf 的「空间问题」——如何让多个硬件设备共享同一块物理内存。但共享只是第一步,真正难的是「时间问题」:
Camera 还在往 buffer 里写数据,GPU 就迫不及待开始读——结果画面花屏。GPU 渲染完一帧,Display 读到的还是上一帧——画面撕裂。这类多硬件并发访问导致的时序竞争,是 dma-buf 体系里最难啃的部分。
解决它的机制叫 Fence(栅栏)。本文先彻底讲透 Fence,再介绍 Android 12 之后替代 ION 的现代内存分配框架——DMA-BUF Heaps。
一、为什么需要 Fence?时序问题根因
在硬件 DMA 的世界里,没有「等一下」——各个硬件都是独立异步运行的,它们不知道彼此的工作进度。
没有 Fence 的世界
时间轴 →

Camera DMA:  [写入 buffer 中...░░░░░░░░]
                      ↑
GPU DMA:              [开始读 buffer!] ← 读到半截数据 ❌

Display:                        [合成输出] ← 画面撕裂 ❌
没有同步机制时,GPU 不知道 Camera 写没写完,Display 不知道 GPU 渲染没渲染完,三个硬件各自为战——这是系统性的时序 bug,不是偶发现象。
Fence 的思路:软件插入「红绿灯」
时间轴 →

Camera DMA:  [写入 buffer 中...████████] → Signal Fence 🟢
                                               ↓
GPU DMA:     ░░░░░░░░░░░░等待绿灯░░░░░░░ → [开始读 buffer ✅]
                                                        ↓ Signal Fence 🟢
Display:     ░░░░░░░░░░░░░░░░░░░░░░░░░░░░ → [合成输出 ✅]
Fence 是一个轻量级的「完成信号」对象:
- 生产者(Camera / GPU)写完数据后,发出信号(Signal Fence)
- 消费者(GPU / Display)开始工作前,等待信号(Wait Fence)
| 角色 |
动作 |
内核 API |
| 生产者(写方) |
创建 Fence,数据写完后发信号 |
dma_fence_init() + dma_fence_signal() |
| 消费者(读方) |
等待 Fence 变绿,再开始工作 |
dma_fence_wait() 或 dma_fence_add_callback() |
| Buffer 容器 |
持有 Fence,协调多方访问 |
dma_resv_add_fence() |
二、dma_fence:内核最小同步原语
dma_fence 是 Linux 内核中最基础的 GPU/硬件同步原语,位于 include/linux/dma-fence.h。它本质上是一个一次性完成信号:只能从「未完成」变为「已完成」,不可逆。
核心结构体
/* include/linux/dma-fence.h (Linux mainline / AOSP GKI) */
struct dma_fence {
    const struct dma_fence_ops __rcu *ops; // 驱动提供的操作回调
    u64 context;   // timeline 上下文 ID(区分不同 timeline)
    u64 seqno;     // 序列号(同一 timeline 上单调递增)
    unsigned long flags;  // 状态标志位(SIGNALED、ENABLE_SIGNAL 等)
    struct kref refcount; // 引用计数
    /* ... */
};
两个关键字段的含义:
context:标识「哪条流水线」,每个独立的 GPU queue / DMA channel 有唯一 contextseqno:标识「流水线上第几号任务」,同一 context 内单调递增
这两个字段共同确定一个 Fence 在全局时序中的唯一位置。
dma_fence_ops:驱动如何接入
/* include/linux/dma-fence.h */
struct dma_fence_ops {
    /* 调试:返回驱动名和 timeline 名 */
    const char *(*get_driver_name)(struct dma_fence *fence);
    const char *(*get_timeline_name)(struct dma_fence *fence);

    /* 可选:框架需要软件回调时,驱动使能硬件通知 */
    bool (*enable_signaling)(struct dma_fence *fence);

    /* 可选:快速检查 fence 是否已完成(无锁快路径) */
    bool (*signaled)(struct dma_fence *fence);

    /* 可选:自定义等待实现(默认用调度器 sleep/wake 机制) */
    signed long (*wait)(struct dma_fence *fence, bool intr, signed long timeout);

    /* 可选:引用计数归零时释放资源 */
    void (*release)(struct dma_fence *fence);

    /* 可选:设置 deadline hint,驱动可据此调整 GPU 频率 */
    void (*set_deadline)(struct dma_fence *fence, ktime_t deadline);
};
三种使用方式对比
| 使用方式 |
适合场景 |
优缺点 |
dma_fence_wait() 阻塞等待 |
内核驱动同步等待 GPU 完成 |
简单直接,但会阻塞调用线程 |
dma_fence_add_callback() 回调 |
异步流水线,不阻塞 |
高效,回调在 signal 时执行,需注意回调在中断上下文 |
sync_file 导出到用户态 |
用户态 Vulkan/OpenGL ES 同步 |
通过 fd 传递到用户态,Android Compositor 大量使用 |
Signal 流程:Fence 如何变绿
生产者(GPU 驱动):

dma_fence_signal(fence)
    │
    ├─ 原子设置 DMA_FENCE_FLAG_SIGNALED_BIT     ← 状态变为「已完成」
    ├─ 记录时间戳 fence->timestamp
    │
    └─ 遍历 cb_list,执行所有注册的回调函数
            ├─ 唤醒 dma_fence_wait() 中阻塞的线程
            ├─ 触发 Compositor 的渲染调度
            └─ 级联触发下一个 Fence 的生产者
⚠️ 重要:dma_fence_signal() 执行注册的回调时,可能在中断上下文或持锁状态下运行。因此回调函数必须是原子操作,不能 sleep,不能申请 mutex。
三、dma_resv:buffer 的 Fence 管理中心
一个 dma-buf 可能同时被多个硬件读写,光有单个 Fence 不够——需要一个容器来管理「这个 buffer 上所有在飞的 Fence」。这就是 dma_resv(Reservation Object)。
核心结构体
/* include/linux/dma-resv.h (Linux mainline / AOSP GKI) */
struct dma_resv {
    struct ww_mutex lock;           // 伤口等待互斥锁(防止死锁)
    struct dma_resv_list __rcu *fences; // Fence 数组(含 usage 标记)
};
ww_mutex(Wound-Wait Mutex)是专为 GPU 场景设计的防死锁互斥锁——当多个进程需要同时锁定多个 buffer 时(典型场景:帧合成需要锁所有图层的 buffer),普通 mutex 会死锁,而 ww_mutex 通过「年轻者让路」策略自动解死锁。
Fence 的 usage 类型
/* include/linux/dma-resv.h */
enum dma_resv_usage {
    DMA_RESV_USAGE_KERNEL,   // 内核内部使用(最高优先级)
    DMA_RESV_USAGE_WRITE,    // 独占写访问(只能有一个)
    DMA_RESV_USAGE_READ,     // 共享读访问(可以多个并行)
    DMA_RESV_USAGE_BOOKKEEP, // 仅追踪,不参与等待
};
| usage |
含义 |
典型使用者 |
WRITE |
当前有设备正在写这个 buffer |
Camera 采集、GPU 渲染输出 |
READ |
当前有设备正在读这个 buffer |
Display 扫描显示、GPU 纹理采样 |
KERNEL |
内核侧排他访问(如迁移、调试) |
内存迁移驱动 |
关键 API 使用流程
/* 典型场景:GPU 写 buffer,然后 Display 读 */

/* === GPU 驱动侧(生产者)=== */

// 1. 锁定 buffer 的 reservation 对象
dma_resv_lock(dmabuf->resv, &ctx);   // ctx 是 ww_acquire_ctx,防死锁

// 2. 预留 Fence 空间(提交前必须先预留,提交后不能失败)
dma_resv_reserve_fences(dmabuf->resv, 1);

// 3. 提交 GPU 任务,任务完成后 GPU 驱动会 signal 这个 fence
struct dma_fence *gpu_fence = submit_gpu_job(cmd_buffer);

// 4. 将 fence 注册到 buffer 的 resv(WRITE:独占写)
dma_resv_add_fence(dmabuf->resv, gpu_fence, DMA_RESV_USAGE_WRITE);

dma_resv_unlock(dmabuf->resv);

/* === Display 驱动侧(消费者)=== */

// 5. 等待 buffer 上所有 WRITE fence 完成,才开始扫描显示
dma_resv_wait_timeout(dmabuf->resv,
                      DMA_RESV_USAGE_WRITE, // 等所有 WRITE fence
                      true,                  // 可中断
                      msecs_to_jiffies(100));// 超时 100ms
// 6. 开始 Display DMA 扫描 ✅
完整 Fence 同步时序图
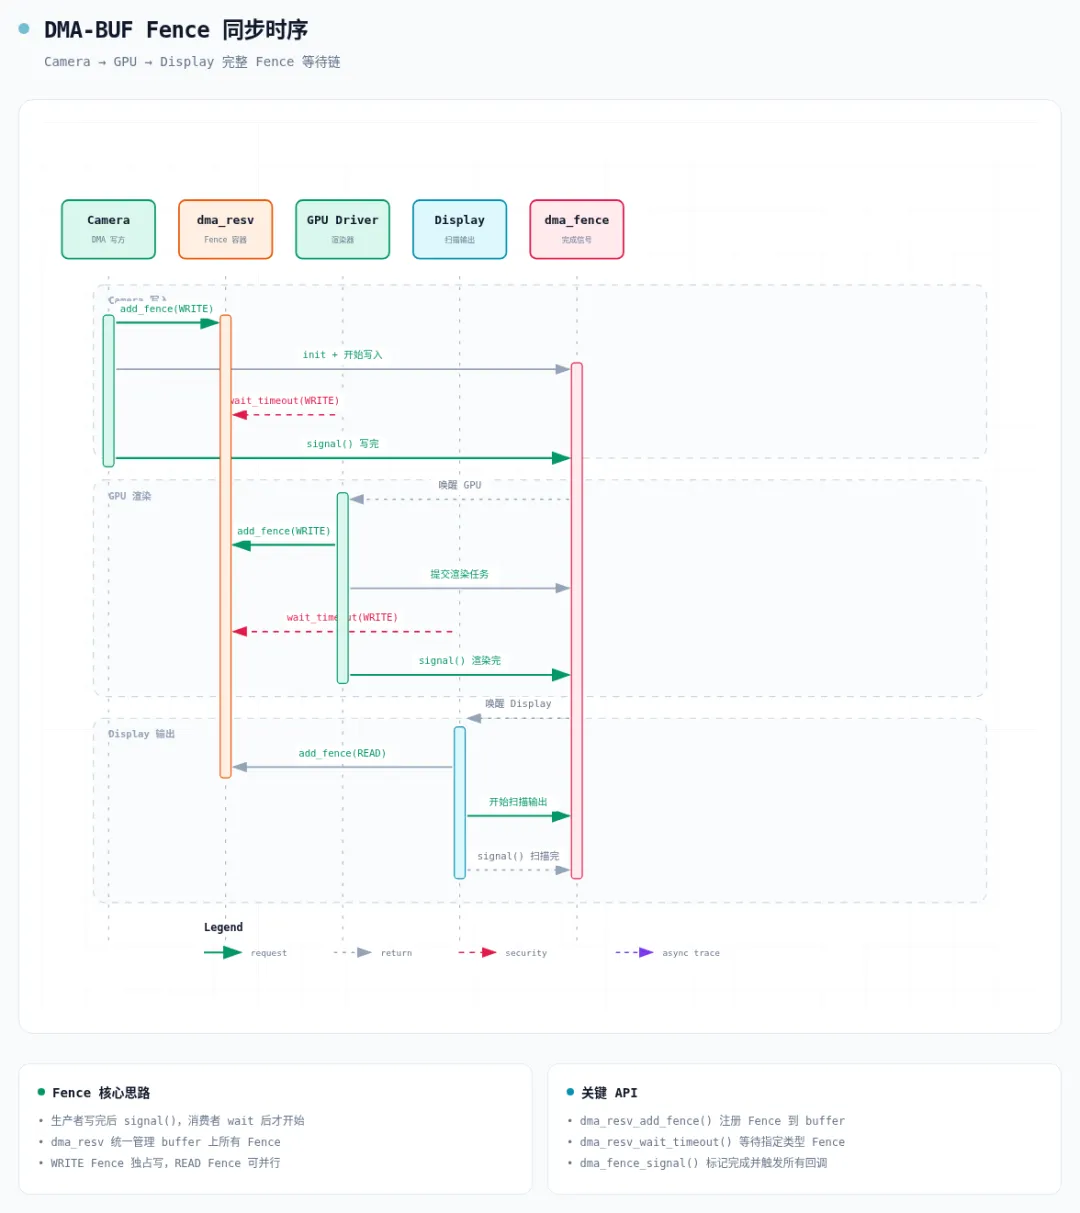
Camera Driver          dma_resv(buffer)        GPU Driver
     │                       │                       │
     │ lock(resv)             │                       │
     │ add_fence(cam_fence,   │                       │
     │   WRITE)               │                       │
     │─────────────────────►  │                       │
     │ unlock(resv)           │                       │
     │                        │                       │
  [Camera DMA 写入中...]       │                       │
     │                        │   wait_timeout(WRITE) │
     │                        │ ◄─────────────────────│
     │                        │   (GPU 等 Camera 完成)│
     │                        │                       │
  [Camera 写完]               │                       │
dma_fence_signal(cam_fence)   │                       │
     │──────────────────────► │ ─────────────────────►│
     │                        │  (唤醒 GPU,开始渲染)  │
     │                        │                       │
     │                        │ ◄── add_fence(gpu_fence, WRITE)
     │                        │                       │
     │                        │                [GPU 渲染中...]
     │                        │                       │
     │          Display wait_timeout(WRITE)            │
     │◄─────────────────────── │                       │
     │         (Display 等 GPU 完成)                   │
     │                        │                   [GPU 完成]
     │                        │          dma_fence_signal(gpu_fence)
     │                        │ ◄─────────────────────│
     │ ─────────────────────► │
     │  (Display 开始扫描显示 ✅)
四、DMA-BUF Heaps:替代 ION 的现代分配器
前三章解决了「buffer 如何共享」和「如何同步」的问题。但还有一个基础问题:buffer 从哪分配?
Android 长期使用 ION(Ion Memory Allocator)来分配 dma-buf。但 ION 有严重的问题:每个厂商都在维护一套不兼容的私有 heap,导致 AOSP 无法统一测试和维护。
Android 12 / Linux 5.6 引入 DMA-BUF Heaps,彻底替代 ION:
ION 时代(Android 11 以前):           DMA-BUF Heaps 时代(Android 12+):

/dev/ion                                /dev/dma_heap/system
    │                                   /dev/dma_heap/system-uncached
    ├── ION_HEAP_TYPE_SYSTEM             /dev/dma_heap/vendor-custom-heap(可扩展)
    ├── ION_HEAP_TYPE_CARVEOUT               │
    └── 各厂商私有 heap(不兼容)            └── 统一的 UAPI + 驱动模型 ✅
用户态分配接口
DMA-BUF Heaps 将分配接口暴露为 /dev/dma_heap/<heap_name>,用户态只需 open + ioctl:
#include <linux/dma-heap.h>

/* 1. 打开 heap 设备节点 */
int heap_fd = open("/dev/dma_heap/system", O_RDONLY);

/* 2. 构造分配请求 */
struct dma_heap_allocation_data data = {
    .len       = 4 * 1024 * 1024,  // 4MB
    .fd_flags  = O_CLOEXEC,
    .heap_flags = 0,
};

/* 3. ioctl 分配 → 返回 dma-buf fd */
ioctl(heap_fd, DMA_HEAP_IOCTL_ALLOC, &data);
int dmabuf_fd = data.fd;  // 这就是标准 dma-buf fd ✅

/* 4. 后续正常使用:传给 GPU/Camera,或 mmap CPU 访问 */
close(heap_fd);
⚠️ 分配出来的 dmabuf_fd 就是第一、二篇讲的标准 dma-buf fd,可以直接走 mmap、DMA_BUF_IOCTL_SYNC、dma_buf_attach 等所有标准接口。
内核侧 Heap 实现结构
以 system_heap(drivers/dma-buf/heaps/system_heap.c)为例,一个 Heap 的实现只需三步:
/* ① 实现 allocate 回调 */
static struct dma_buf *system_heap_allocate(struct dma_heap *heap,
                                             unsigned long len,
                                             u32 fd_flags, u64 heap_flags)
{
    /* 1. 用 alloc_largest_available() 分页(优先大页,减少碎片)*/
    /* 2. 组装 sg_table */
    /* 3. dma_buf_export() 导出为标准 dma-buf */
    DEFINE_DMA_BUF_EXPORT_INFO(exp_info);
    exp_info.exp_name = dma_heap_get_name(heap);
    exp_info.ops      = &system_heap_buf_ops;
    exp_info.size     = len;
    exp_info.priv     = buffer;
    return dma_buf_export(&exp_info);  // 返回标准 dma_buf ✅
}

/* ② 注册 heap_ops */
static const struct dma_heap_ops system_heap_ops = {
    .allocate = system_heap_allocate,
};

/* ③ 模块初始化时注册到框架 */
static int __init system_heap_create(void)
{
    struct dma_heap_export_info exp_info = {
        .name = "system",       // 对应 /dev/dma_heap/system
        .ops  = &system_heap_ops,
    };
    dma_heap_add(&exp_info);    // 注册,自动创建设备节点
    return 0;
}
module_init(system_heap_create);
三种内置 Heap 对比
| Heap 名称 |
设备节点 |
内存属性 |
适合场景 |
system |
/dev/dma_heap/system |
Cached(有 CPU Cache) |
默认选择,性能最佳 |
system-uncached |
/dev/dma_heap/system-uncached |
Uncached(无 CPU Cache) |
CPU 和设备频繁交替访问,省去 Cache 同步开销 |
linux,cma |
/dev/dma_heap/linux,cma |
CMA 连续内存 |
需要物理连续内存的设备(如某些 Camera ISP) |
选哪个? 大多数场景选 system;如果你的 buffer 需要频繁 CPU 读写 + 硬件 DMA 读写交替,且所在 SoC 没有 CCI,考虑 system-uncached 彻底规避 Cache 同步问题(代价是 CPU 访问速度下降)。
DMA-BUF Heaps 完整调用链
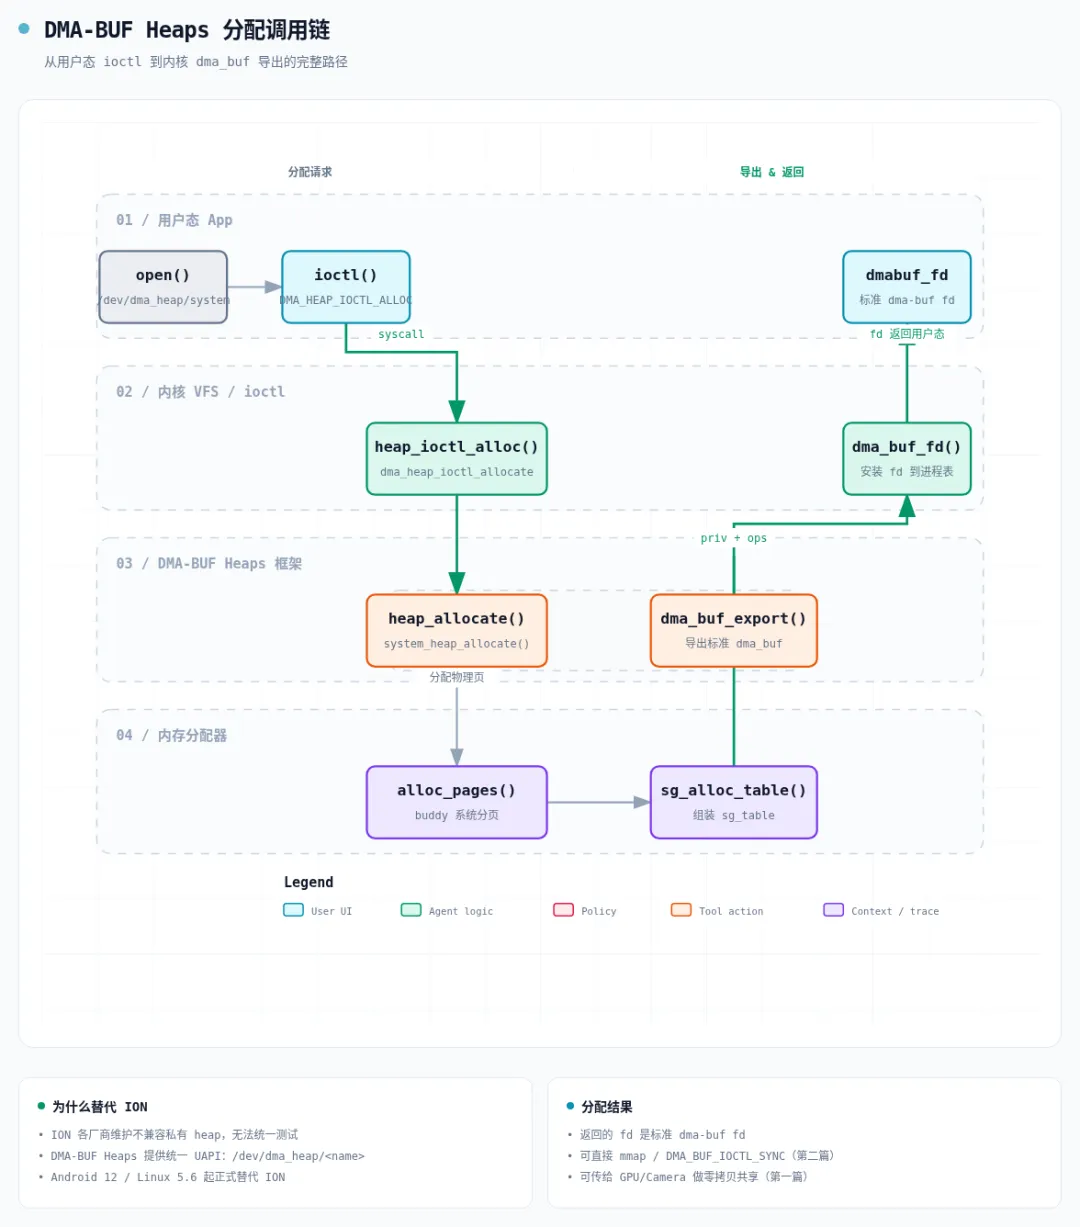
用户态 App
    │
    ├─ open("/dev/dma_heap/system")         ← 打开 heap 节点
    ├─ ioctl(DMA_HEAP_IOCTL_ALLOC, &data)  ← 触发内核分配
    │     │
    │     └─ 内核:dma_heap_ioctl_allocate()
    │              └─ heap->ops->allocate() ← system_heap_allocate()
    │                   ├─ alloc_pages()    ← 从 buddy 分配物理页
    │                   ├─ sg_alloc_table() ← 组装 sg_table
    │                   └─ dma_buf_export() ← 导出为标准 dma_buf
    │                        └─ dma_buf_fd() ← 返回 fd
    │
    ├─ dmabuf_fd = data.fd                  ← 得到标准 dma-buf fd
    │
    ├─ 传给 GPU / Camera(Importer)        ← 零拷贝共享
    └─ 或 mmap(dmabuf_fd) + IOCTL_SYNC     ← CPU 访问(第二篇的内容)
总结
读完本文,你应该能回答这些问题:
- ✅ 为什么零拷贝共享还需要 Fence?Fence 解决了什么问题?
- ✅
dma_fence_signal() 执行了哪些操作?回调在什么上下文执行? - ✅
dma_resv 如何管理一个 buffer 上的多个 Fence?ww_mutex 解决了什么? - ✅
DMA_RESV_USAGE_WRITE 和 READ 有什么区别? - ✅ DMA-BUF Heaps 为什么替代 ION?如何用一行 ioctl 分配 dma-buf?
- ✅
system 和 system-uncached heap 如何选择?
系列总结:dma-buf 体系的三个核心问题现在都有了答案——空间(如何共享同一块物理内存)靠 fd + sg_table;时间(如何协调多硬件的访问时序)靠 Fence + dma_resv;来源(内存从哪分配)靠 DMA-BUF Heaps。三者合一,才是完整的 Linux 零拷贝内存共享体系。
附录:本文涉及的关键内核接口
| 接口 |
所在文件 |
说明 |
struct dma_fence |
include/linux/dma-fence.h |
基础同步原语 |
struct dma_fence_ops |
include/linux/dma-fence.h |
驱动 Fence 回调接口 |
dma_fence_init() |
drivers/dma-buf/dma-fence.c |
初始化 Fence |
dma_fence_signal() |
drivers/dma-buf/dma-fence.c |
标记 Fence 完成,触发回调 |
dma_fence_wait() |
include/linux/dma-fence.h |
阻塞等待 Fence 完成 |
dma_fence_add_callback() |
drivers/dma-buf/dma-fence.c |
注册异步回调 |
struct dma_resv |
include/linux/dma-resv.h |
buffer 级 Fence 容器 |
dma_resv_lock() |
include/linux/dma-resv.h |
锁定 resv(ww_mutex) |
dma_resv_add_fence() |
drivers/dma-buf/dma-resv.c |
向 resv 添加 Fence |
dma_resv_wait_timeout() |
drivers/dma-buf/dma-resv.c |
等待 resv 上指定类型的 Fence |
struct dma_heap_ops |
include/linux/dma-heap.h |
Heap 分配器回调接口 |
dma_heap_add() |
drivers/dma-buf/dma-heap.c |
注册新 Heap |
DMA_HEAP_IOCTL_ALLOC |
include/uapi/linux/dma-heap.h |
用户态分配 ioctl |
 10个月宝宝每天需要喝多少奶粉?