








当前位置:首页>Linux>Linux操作系统-shell编程之Grep与正则表达式

Linux操作系统-shell编程之Grep与正则表达式

  • 2026-10-11 06:08:09
Linux操作系统-shell编程之Grep与正则表达式

🌹点击上方关注小老弟云运维,学习更多运维知识

一、文本过滤神器GREP

GREP:Global search regular expression(RE),是一种强大的文本搜索工具,它能使用正则表达式搜索文本,并把匹配的行打印出来。 GREP语法格式: grep     -[acinv]    ‘word’     Filename GREP参数详解: -a :以文本文件方式搜索; -c :计算找到的符合行的次数; -i :忽略大小写; -n:顺便输出行号; -v:反向选择,即显示不包含匹配文本的所有行; -h:查询多文件时不显示文件名; -l :查询多文件时只输出包含匹配字符的文件名; -s:不显示不存在或无匹配文本的错误信息; -E:允许使用egrep扩展模式匹配; -r:递归搜索; -o: 匹配搜索的字符串。

二、正则表达式

正则表达式:处理字符串的方法,它是以行为单位来进行字符串处理的行为,正则表达式透过一些特殊字符的辅助,可以让使用者轻易达到搜索、删除、替换某特定字串的处理程序。 正则表达式分为基础正则表达式及扩展正则表达式,如下将介绍用法:

1、基础正则表达式

#################常用符号#################.     表示任意单个字符。*     表示前面的字符连续出现任意次,包括0次。.*    表示任意长度的任意字符,与通配符中的*的意思相同。\     表示转义符,当与正则表达式中的符号结合时表示符号本身。[  ]  表示匹配指定范围内的任意单个字符。[^  ] 表示匹配指定范围外的任意单个字符。#################单个字符匹配#################[[:alpha:]]或[a-zA-Z]     表示任意大小写字母。[[:lower:]]或[a-z]        表示任意小写字母。[[:upper:]]或[A-Z]        表示任意大写字母。[[:digit:]]或[0-9]        表示0到9之间的任意单个数字(包括0和9)。[[:alnum:]]或[a-zA-Z0-9]  表示任意数字或字母。[[:space:]]               表示任意空白字符,包括"空格"、"tab键"等。[[:punct:]]               表示任意标点符号。[^[:alpha:]]或[^a-zA-Z]   表示单个非字母字符。[^[:lower:]]或[^a-z]      表示单个非小写字母字符。[^[:upper:]]或[^A-Z]      表示单个非大写字母字符。[^[:digit:]]或[^0-9]      表示单个非数字字符。[^[:alnum:]]或[^a-zA-Z0-9]表示单个非数字非字母字符。[^[:space:]]              表示单个非空白字符。[^[:punct:]]              表示单个非标点符号字符。#简短格式并非所有正则表达式解析器都可以识别。\d   表示任意单个0到9的数字。\D   表示任意单个非数字字符。\t   表示匹配单个横向制表符(相当于一个tab键)。\s   表示匹配单个空白字符,包括"空格","tab制表符"等。\S   表示匹配单个非空白字符。#################次数匹配#################\?       表示匹配其前面的字符0或1次\+       表示匹配其前面的字符至少1次,或者连续多次,连续次数上不封顶。\{n\}    表示前面的字符连续出现n次,将会被匹配到。\{x,y\}  表示之前的字符至少连续出现x次,最多连续出现y次,都能被匹配到,换句话说,只要之前的字符连续出现的次数在x与y之间,即可被匹配到。\{,n\}   表示之前的字符连续出现至多n次,最少0次,都会陪匹配到。\{n,\}   表示之前的字符连续出现至少n次,才会被匹配到。#################位置边界匹配#################^:       表示锚定行首,此字符后面的任意内容必须出现在行首,才能匹配。:      表示匹配空行,这里所描述的空行表示"回车",而"空格"或"tab"等都不能算作空行。^abc:       表示锚定行尾,此字符前面的任意内容必须出现在行尾,才能匹配。^:   表示abc独占一行时,会被匹配到。\<或者\b :匹配单词边界,表示锚定词首,其后面的字符必须作为单词首部出现。\>或者\b :匹配单词边界,表示锚定词尾,其前面的字符必须作为单词尾部出现。\B:      匹配非单词边界,与\b正好相反。####################分组与后向引用####################( )     表示分组,我们可以将其中的内容当做一个整体,分组可以嵌套。(ab)    表示将ab当做一个整体去处理。\1      表示引用整个表达式中第1个分组中的正则匹配到的结果。\2      表示引用整个表达式中第2个分组中的正则匹配到的结果。

三、grep与正则表达式结合应用举例

准备一个测试文件regular_expression.txt,内容如下: gooooooood good gud goooood gxyzxyzxyzd hello world! this is a beautiful world 123456789 abc123 abc

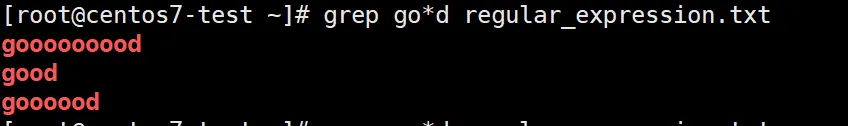
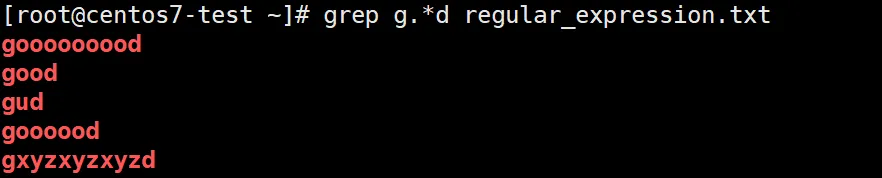
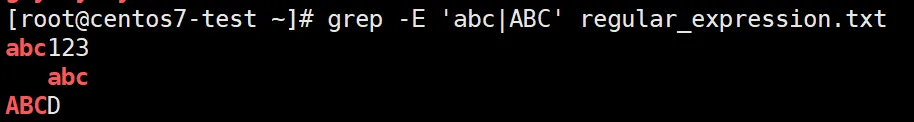
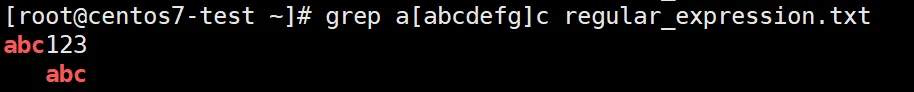
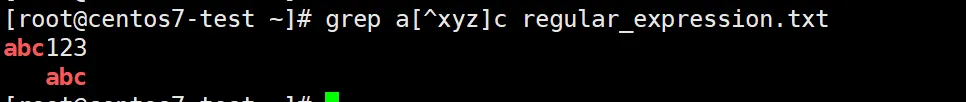
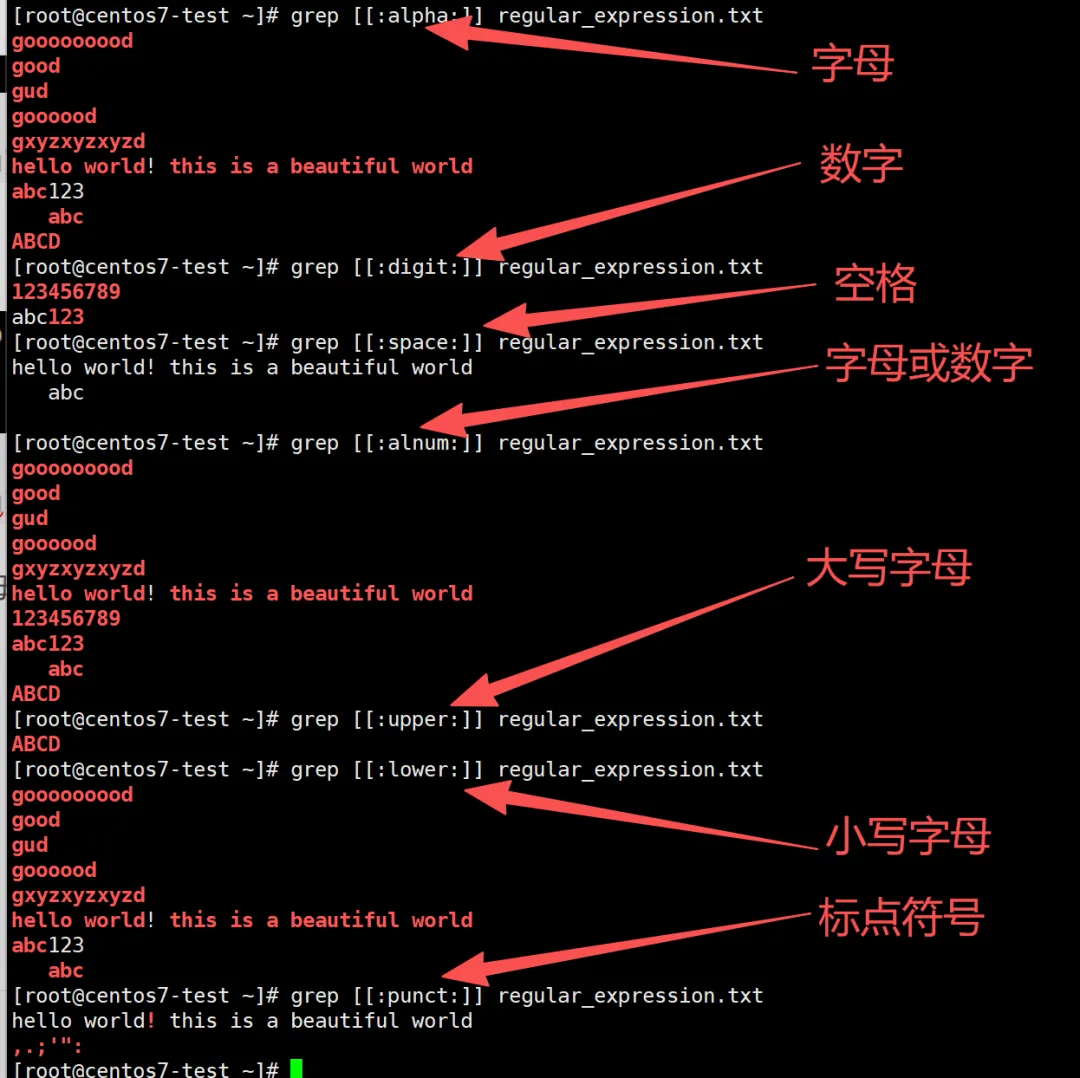
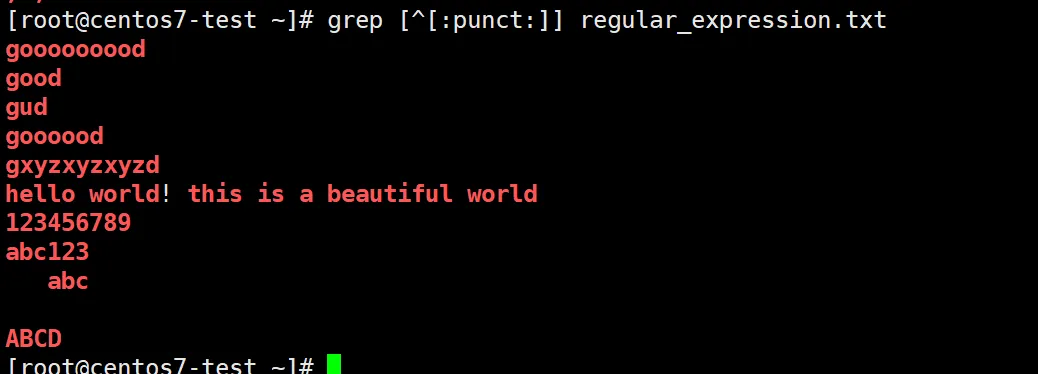
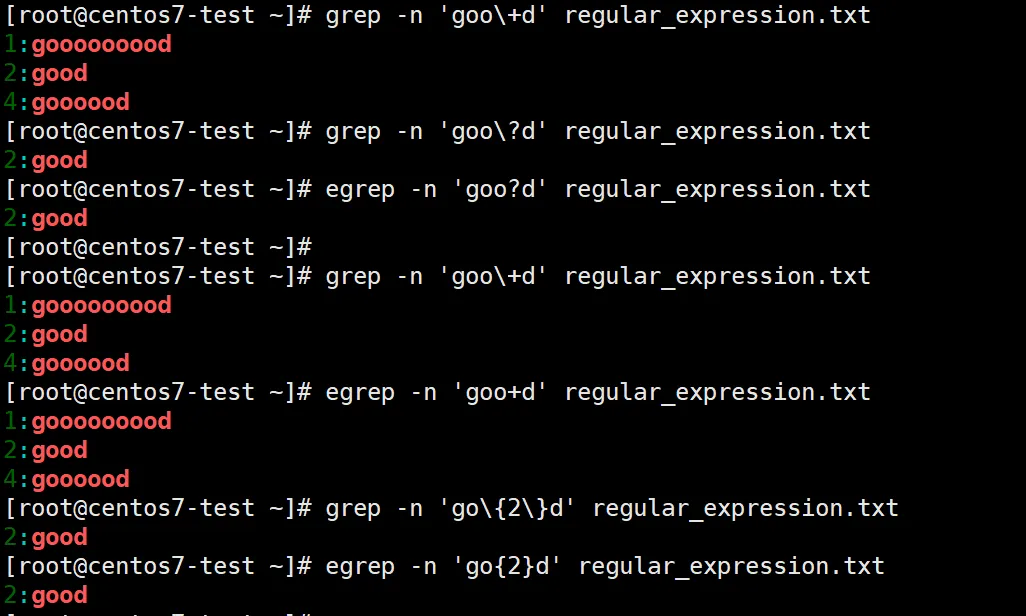
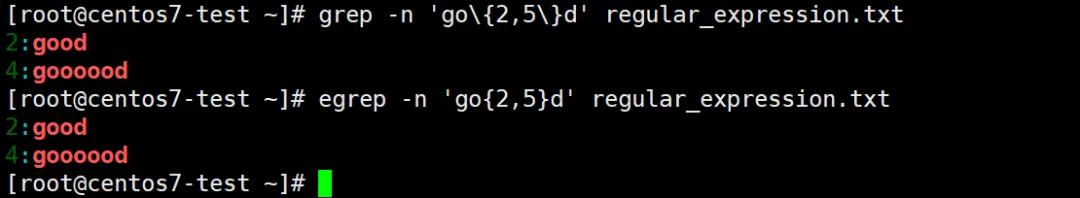
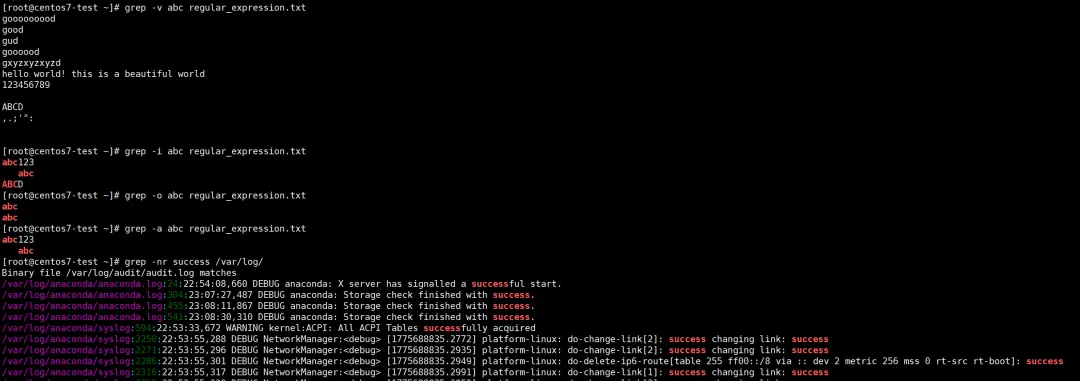
ABCD ,.;'": 1、匹配g和d之间有一个字符的行; grep g.d regular_expression.txt 2、匹配模式go*d的行; 3、匹配g和d之间包含任意字符串的行 4、过滤包含字符串abc或ABC的行 5、过滤a和c之间包含字符串“abcdefg”中一个字符的行。 6、过滤a和c之间不包含字符串“xyz”中任意一个字符的行。 7、分别过滤文件中包含字母、数字、空格、字母或数字、大写字母、小写字母、标点符号的行 8、过滤文件中不包含标点符号的行。 9、次数匹配(基础正则与扩展正则对比) 10、位置匹配 1)过滤以字符串abc开头的行 2)过滤以789结尾的行 3)过滤空行 4)过滤包含以w开头以d结尾的词的行 11、分组与后向引用 1)过滤g和d之间包含模式‘xyz’的行 2、过滤出机器的ip地址 3、使用后向引用将日期反向显示(年-月-日转换显示为日-月-年) 12、grep其他常用选项举例 -i :忽略大小写; -v:反向选择,即显示不包含匹配文本的所有行; -r:递归搜索,使用grep -nr ‘关键字’ /data/to/path可以递归搜索出目录下所有包含关键字的文件名,所在行数,即改行的内容,非常常用。 -o: 匹配搜索的字符串 -a :以文本文件方式搜索; -c :计算找到的符合行的次数;

最新文章

随机文章