写在前面的话
不怕别人知道。之前,做头条运营时,有一段时间,我特别害怕别人知道。一是不好意思,怕别人知道我干这种不务正业的事,二是怕同行知道了,都去做。后面我发现知道的人越多越好,对我来说反而是一种推广,如果别人压根就没听说过,我还要解释半天,估计别人还是不相信,以为我是骗子。至于同行,想做的,来来来,咱们交流交流,但一些关键节点是不会说的,那是我花时间研究出来的,不可能让别人免费白嫖。就像最近获得菲尔兹奖的王虹,她研究挂谷猜想取得了突破。但在发表论文之前,她会把自己的成果轻易地告诉别人吗?显然不会,因为他研究了十几年才研究出点成果。但别人问她在干啥,她会告诉别人自己在研究挂谷猜想,和别人交流,也许能激发她的思路,别人估计也没她那个毅力和脑子研究出来,所以,她不怕别人知道。同样,我也想让更多人知道我在做的事,说不定能碰出什么火花呢?
[156+100]-------->底部有张生活照片(头条号运营:大家想全托管上号的联系我哦,每天让你得个地铁钱,微信号: qhz_toutiao)
【关键词】python、ragflow、引用文件、前端编译
一、搜索引用文件展示(三级)
描述:现在搜索引用文件展示不出来,需要参考官网搞一下。
开工:
第一步:官网数据(四级)
20250620周六时间段:20:22-21:00
现在官网数据如下:
data: {
"code": 0,
"message": "",
"data": {
"answer": "根据提供的文档信息,生成SSH密钥的步骤如下:\n\n```bash\nssh-keygen -t rsa -b 4096 -C \"243127387@qq.com\"\n```\n [ID:0]\n\n说明:\n1. 使用`-t rsa`指定密钥类型为RSA\n2. 使用`-b 4096`指定密钥长度为4096位\n3. 使用`-C`添加注释(这里用的是示例邮箱243127387@qq.com)\n\n执行命令后,按照提示操作:\n- 选择密钥保存位置(默认是~/.ssh/id_rsa)\n- 设置密钥密码(可选)",
"reference": {
"total": 1,
"chunks": [{
"id": "05130bb5066937ee",
"content": "a.检查 SSH 密钥配置(四级)首先,确保你在本地生成并配置了 SSH 密钥,并且正确添加到阿里云效账号。a.1生成 SSH 密钥(如果还没有的话)如果你还没有 SSH 密钥,可以使用下面的命令生成:ssh-keygen -t rsa -b 4096 -C \"243127387@qq.com\"然后按照提示保存密钥文件。",
"document_id": "948bc4ec4dbc11f09db642010a8e0005",
"document_name": "git相关-上传ragflow.docx",
"dataset_id": "e73948c0445911f0bbbc42010a8a0003",
"image_id": "",
"positions": [
[2, 1, 1, 1, 1]
],
"url": null,
"similarity": 18.740826629827506,
"vector_similarity": 0.657597764274924,
"term_similarity": 0.7764961436357573,
"doc_type": ""
}],
"doc_aggs": [{
"doc_name": "git相关-上传ragflow.docx",
"doc_id": "948bc4ec4dbc11f09db642010a8e0005",
"count": 1
}]
}
}
}
注:接下来,测试服上传同样文件进行解析和搜索。
第二步:上传文件(四级)
20250620周五时间段:20:25-21:00
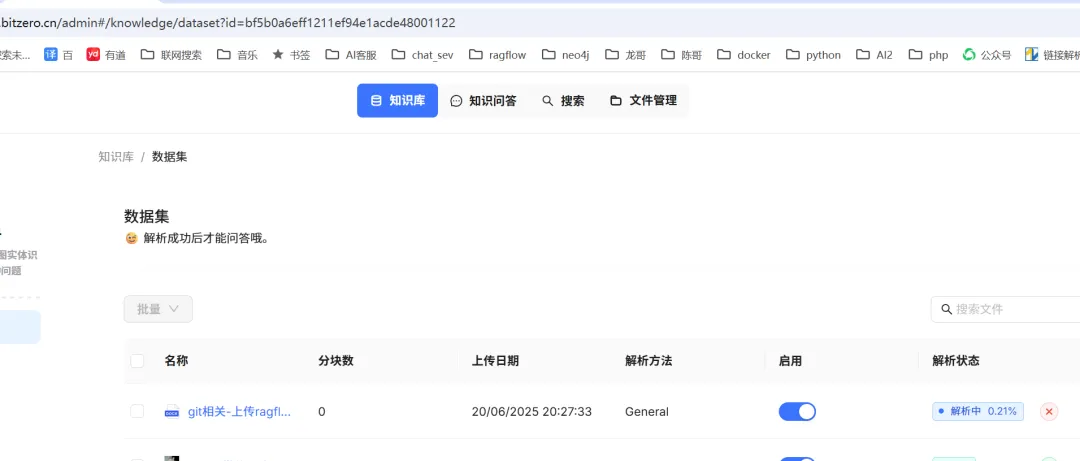
上传如下:
图2a-1
注:估计解析还得一会,先回去。还没解析成功,把官网最新的代码下载下来。
第三步:下载最新官网代码(四级)
20250620周五时间段:23:49-01:00
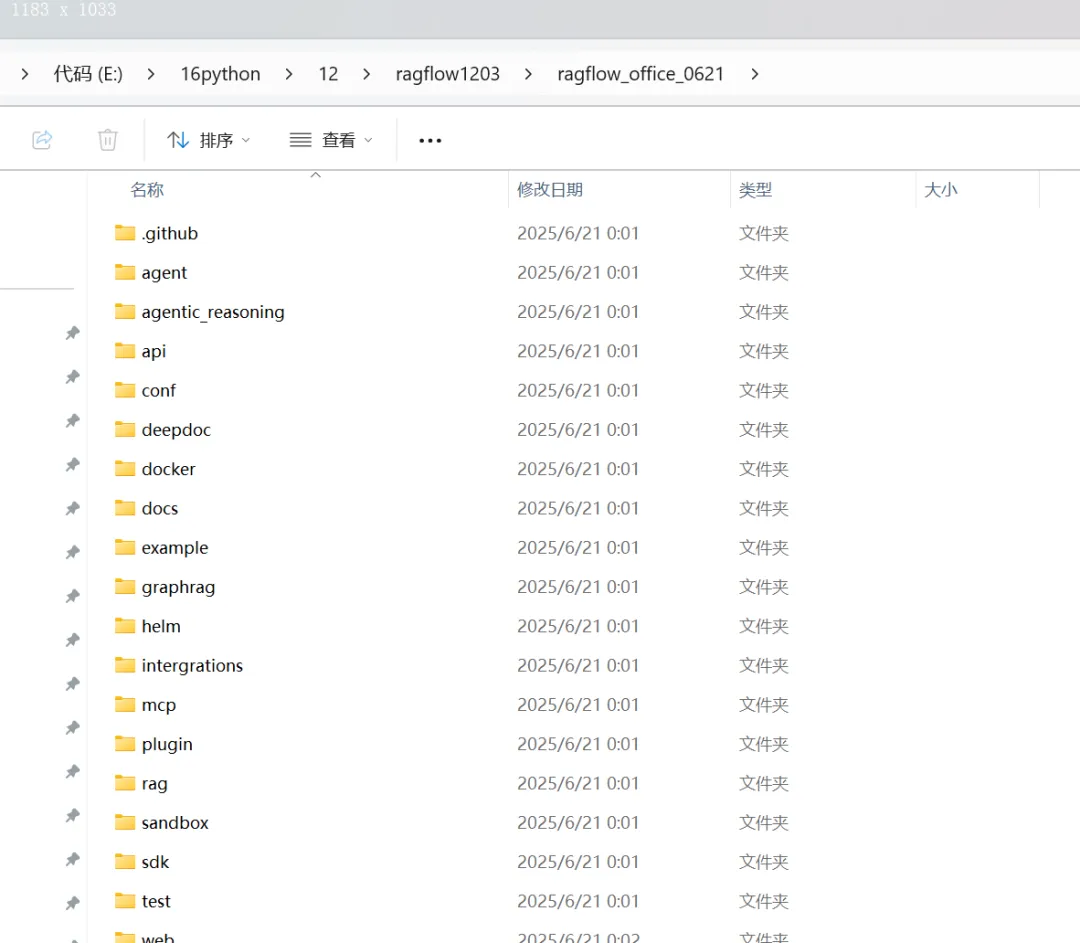
下载好了,解压后如下:
图2a-2
注:打开研究下ask接口。
第四步:研究ask接口(四级)
20250621周六时间段:00:04-02:00
ask方法如下:
def ask(question, kb_ids, tenant_id, chat_llm_name=None):
    kbs = KnowledgebaseService.get_by_ids(kb_ids)
    embedding_list = list(set([kb.embd_id for kb in kbs]))

    is_knowledge_graph = all([kb.parser_id == ParserType.KG for kb in kbs])
    retriever = settings.retrievaler if not is_knowledge_graph else settings.kg_retrievaler

    embd_mdl = LLMBundle(tenant_id, LLMType.EMBEDDING, embedding_list[0])
    chat_mdl = LLMBundle(tenant_id, LLMType.CHAT, chat_llm_name)
    max_tokens = chat_mdl.max_length
    tenant_ids = list(set([kb.tenant_id for kb in kbs]))
    kbinfos = retriever.retrieval(question, embd_mdl, tenant_ids, kb_ids, 1, 12, 0.1, 0.3, aggs=False, rank_feature=label_question(question, kbs))
    knowledges = kb_prompt(kbinfos, max_tokens)
    prompt = """
    Role: You're a smart assistant. Your name is Miss R.
    Task: Summarize the information from knowledge bases and answer user's question.
    Requirements and restriction:
      - DO NOT make things up, especially for numbers.
      - If the information from knowledge is irrelevant with user's question, JUST SAY: Sorry, no relevant information provided.
      - Answer with markdown format text.
      - Answer in language of user's question.
      - DO NOT make things up, especially for numbers.

    ### Information from knowledge bases
    %s

    The above is information from knowledge bases.

    """ % "\n".join(knowledges)
    msg = [{"role": "user", "content": question}]

    def decorate_answer(answer):
        nonlocal knowledges, kbinfos, prompt
        answer, idx = retriever.insert_citations(answer, [ck["content_ltks"] for ck in kbinfos["chunks"]], [ck["vector"] for ck in kbinfos["chunks"]], embd_mdl, tkweight=0.7, vtweight=0.3)
        idx = set([kbinfos["chunks"][int(i)]["doc_id"] for i in idx])
        recall_docs = [d for d in kbinfos["doc_aggs"] if d["doc_id"] in idx]
        if not recall_docs:
            recall_docs = kbinfos["doc_aggs"]
        kbinfos["doc_aggs"] = recall_docs
        refs = deepcopy(kbinfos)
        for c in refs["chunks"]:
            if c.get("vector"):
                del c["vector"]

        if answer.lower().find("invalid key") >= 0 or answer.lower().find("invalid api") >= 0:
            answer += " Please set LLM API-Key in 'User Setting -> Model Providers -> API-Key'"
        refs["chunks"] = chunks_format(refs)
        return {"answer": answer, "reference": refs}

    answer = ""
    for ans in chat_mdl.chat_streamly(prompt, msg, {"temperature": 0.1}):
        answer = ans
        yield {"answer": answer, "reference": {}}
    yield decorate_answer(answer)
注:接下来,想着本地手搓一个最新版的,使其跑起来,打日志,看它是怎么调用的,怎么能召回文档。
第五步:先看一个替换流程(四级)
二、本地跑最新版代码(三级)
描述:本地跑个最新的代码,看看搜索是怎么搞出来的。
开工:
第一步:按文档来(四级)
20250621周六时间段:01:02-02:00
https://ragflow.io/docs/dev/
a.开始
RAGFlow 是一个基于深度文档理解的开源 RAG(检索增强生成)引擎。与 LLM 集成后,它能够提供真实的问答功能,并以来自各种复杂格式数据的可靠引用为支撑。
本快速入门指南描述了以下一般流程:
启动本地 RAGFlow 服务器,
创建知识库,
干预文件解析,
根据您的数据集建立 AI 聊天。
注:
我们正式支持 x86 CPU 和 Nvidia GPU,本文档提供了在 x86 平台上使用 Docker 部署 RAGFlow 的说明。虽然我们也在 ARM64 平台上测试了 RAGFlow,但我们不维护 ARM 平台的 RAGFlow Docker 镜像。
如果您使用的是 ARM 平台,请按照本指南构建 RAGFlow Docker 镜像。
三、前端文件替换流程(三级)
描述:现在zero4上前端index.html文件需要替换,理一下流程。
开工:
第一步:web/dist下的index.html改为app.html
命令如下:
cd web/dist
mv index.html app.html
第二步:把web/dist复制至web/dist/admin下
命令如下:
cd ragflow
mv web/dist/ web/admin/dist
第三步:webclient下的index.html改为chat.html
命令如下:
cd ragflow
mv webclient/dist/index.html web/dist/chat.html
第四步:把webclient/dist复制至web/dist下
命令如下:
cd ragflow
cp -Rf webclient/dist/. web/dist
第五步:把web下的dist整体覆盖容器内web/dist
命令如下:
cd web
tar -cvf - ./dist | docker exec -i ragflow-server tar -xvf - -C /ragflow/web/
注:接下来,看一下前端编译。
四、前端bash编译(三级)
描述:现在前端编译,我觉得有问题,需要1个多小时,需要处理一下。
开工:
第一步:研究脚本(四级)
20250621周六时间段:21:54-22:00
相关前端脚本如下:
build_web() {
  local web=$1

  cd "$APP_HOME/$web"

  # 获取 src 目录最新文件的修改时间(Unix 时间戳)
  src_latest_time=$(find src -type f -printf "%TY-%Tm-%Td %TH:%TM:%TS %p\n" | sort -nr | head -1 | cut -d. -f1)
  echo src_latest_time=$src_latest_time

  # 获取 docker 容器内 dist 目录最新文件的修改时间(Unix 时间戳)
  find_cmd="find /ragflow/$web/dist -type f -printf \"%TY-%Tm-%Td %TH:%TM:%TS %p\n\" | sort -nr | head -1 | cut -d. -f1"
  dist_latest_time=$(docker exec ragflow-server sh -c "$find_cmd")
  echo dist_latest_time=$dist_latest_time


  # 直接使用字符串比较(YYYY-MM-DD HH:MM:SS 格式可字典序比较)
  if [[ "$src_latest_time" > "$dist_latest_time" ]]; then
      echo "find new $web files"

    # Check if svgo is installed globally, if not install it
    npm list -g svgo || npm install -g svgo

    # Check if node_modules exists, if not install dependencies
    [ -d "node_modules" ] || npm install

    # 检查 umi 是否已安装
    if ! npm list umi --depth=0 > /dev/null 2>&1; then
      echo "umi 未安装,正在安装..."
      npm install umi --save-dev
    fi

    echo "正在编译前端..."
    NODE_OPTIONS="--max-old-space-size=4096" \
    UMI_UI=none \
    COMPRESS=none \
    npm run build -- --max-workers=12 || {
        echo "npm run build 执行失败" >&2
        exit 1  # 中途退出,返回非0状态码表示失败
    }
  fi
}
五、头条战果汇报
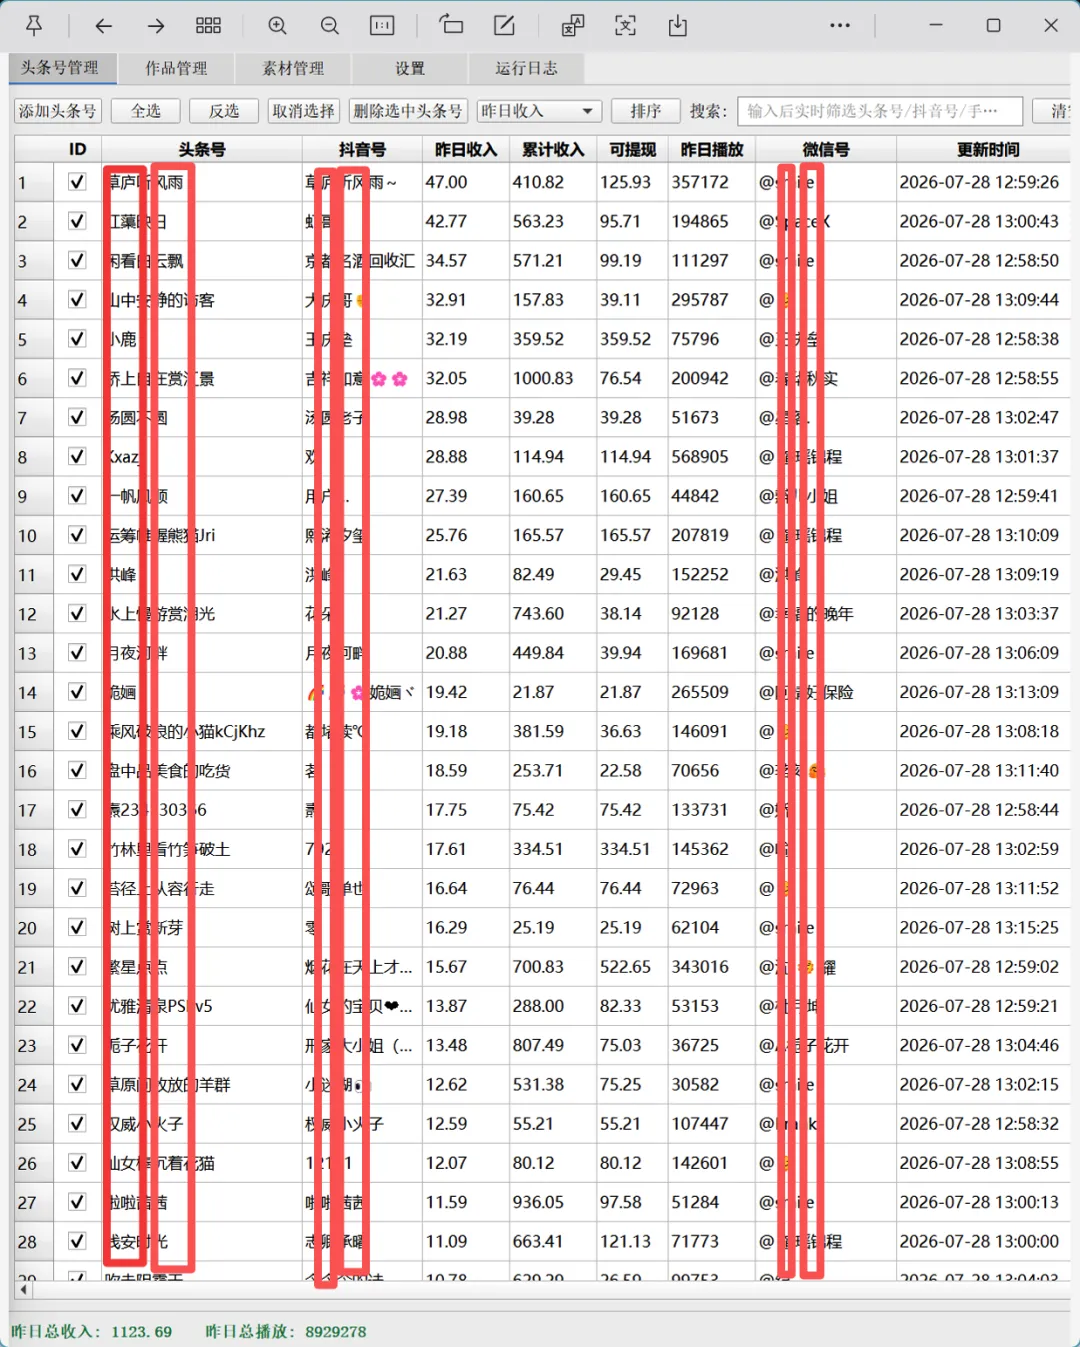
昨日数据来啦,昨日总收入:1123.69块,昨日总播放:892.92万次,软件截图如下:
图2e-1
注:想要全托管运营头条号的联系我,你出账号,我来运营,保你天天有钱花,咨询电话: 17701328814(微信同号),也可以加群先了解一下。
图2e-2
注:个人微信如下,欢迎骚扰。
图2e-3
六、生活照片
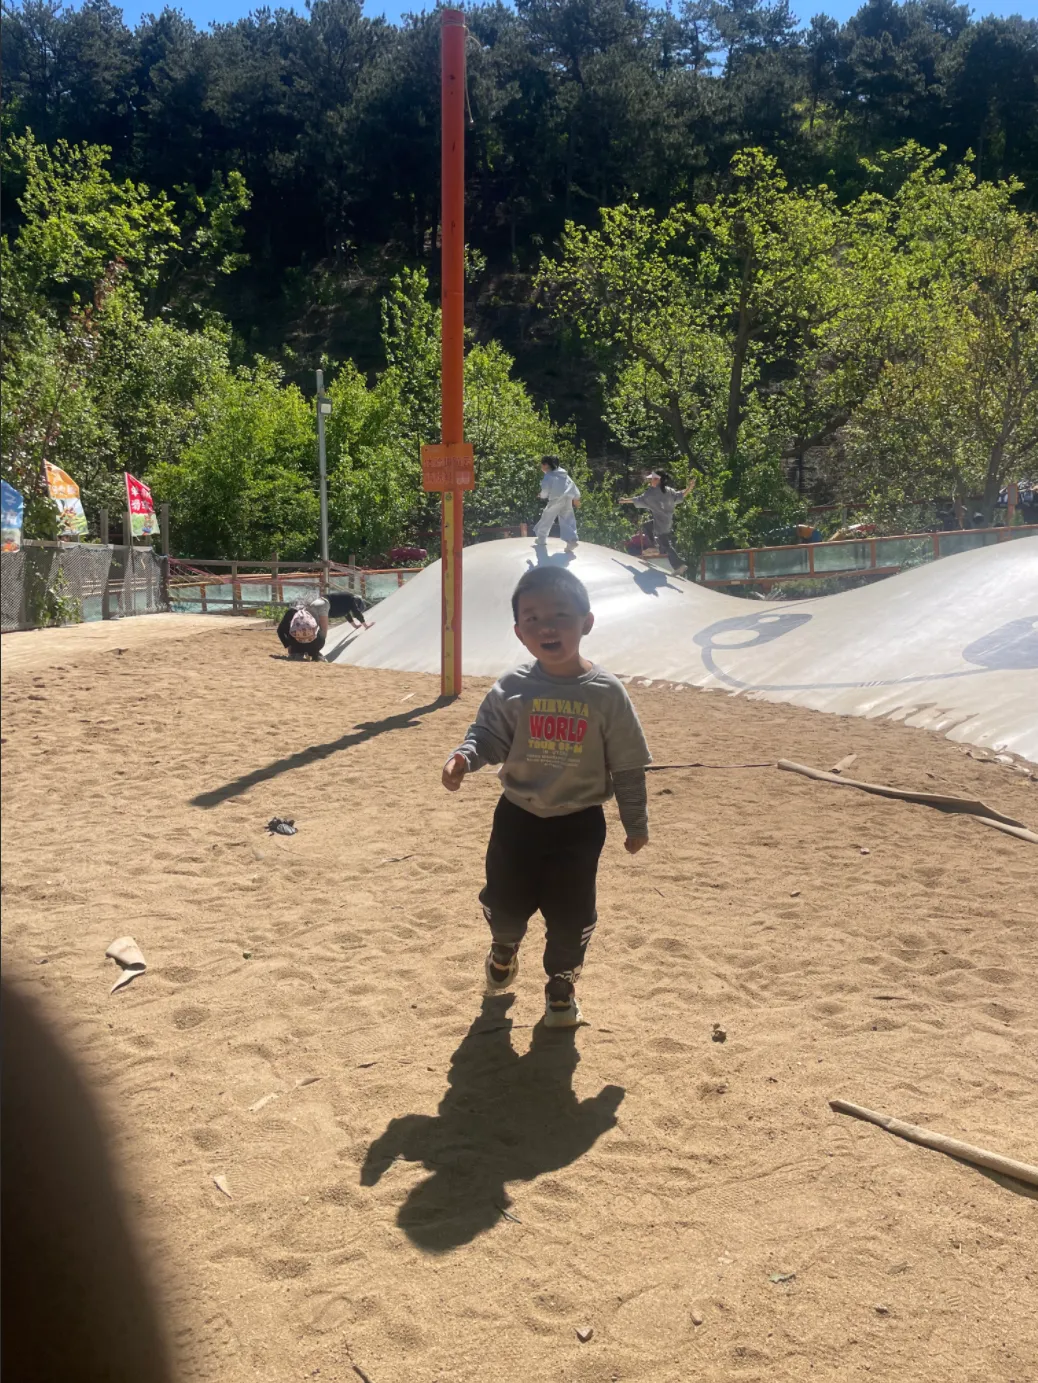
拍摄于2026年5月4日,10:03:47,带二宝去天津玩拍的,还是不愿意去旅游,到哪都是人,累的够呛,当时二宝三岁七个月。工作中很多事,靠自己努力,现在是自由工作者,好不容易得出的成果,不可能轻易示人,尤其是对我完成工作没有一点帮助的人。但同时我也是个没原则的人,有时一动情一股脑全倒给别人了,之前一位领导说,啥事都别给海振说,他是一个最不能保守秘密的人。其实我就是心好,这点随我妈,看不得别人受苦,自己本就是泥菩萨,还想拯救大众,我也是个奇葩。前一段回去,看到一个叔现在靠乞讨为生,老妈忍不住给了100,我也给了一盒烟,一瓶水。媳妇说,你可怜这个,可怜那个,能不能可怜可怜我,我跟着你这么多年,我得到啥了。哎,媳妇说的也对,慢慢改吧,家和万事兴。
图2f-1
《本文完》
 10个月宝宝每天需要喝多少奶粉?