Python爬取智联招聘职位:监听接口+新Tab精准采集,拿全薪资与HR活跃状态
- 2026-10-11 05:57:08
Python爬取智联招聘职位:监听接口+新Tab精准采集,拿全薪资与HR活跃状态做Python爬虫的朋友,大多都写过招聘网站的数据采集。无论是做薪酬分析、人才流动研究,还是求职市场洞察,智联招聘的职位数据都是绕不开的一站。 但智联招聘的搜索页有一个“坑”: 点击搜索后,页面会在新 Tab 中打开。 如果你还傻傻地在原页面监听接口,或者直接用 requests 模拟翻页,结果只有一个——数据抓不到,或者被反爬拦截。 今天这篇,我只公开核心思路和关键字段的提取逻辑,至于新 Tab 绑定监听、翻页稳定性控制、职位标签清洗规则,属于付费级细节。想直接拿完整源码的,文末有入口。 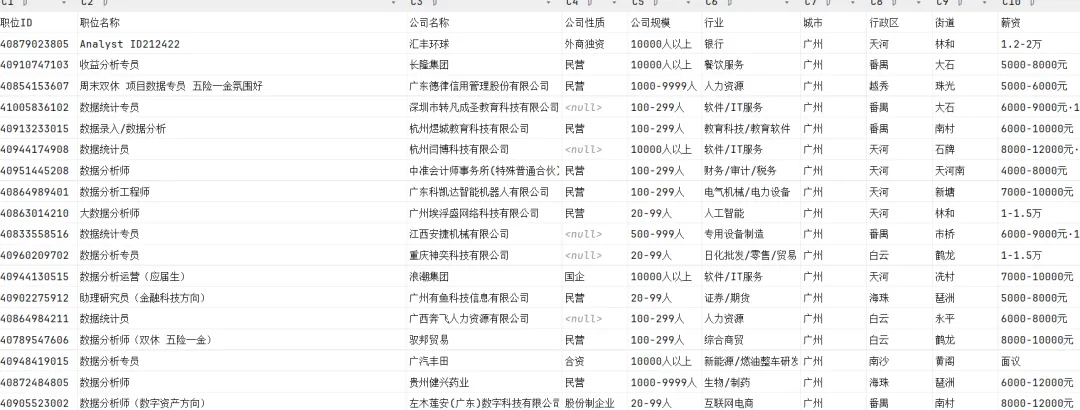
字段分析价值薪资(salary60)市场薪酬基准招聘人数岗位紧急程度发布时间招聘活跃度HR活跃状态HR响应概率职位标签JD关键词画像行政区 / 街道城市用工分布 👉 这些数据,招聘平台不给你批量导出,但爬虫可以。 智联招聘搜索流程: 首页输入关键词 → 点击搜索 → 新 Tab 打开列表页 ✅错误做法:在原页面 dp.listen.start() ✅正确做法: tab = dp.ele('css:.search-wrapper__button').click.for_new_tab()tab.listen.start('/c/i/search/positions') 👉监听必须绑定到新 Tab,否则接口永远监听不到。 智联的“下一页”按钮: 永远存在 最后一页只是“点不动” ✅解法: next_btn = tab.ele('text=下一页', timeout=5)if next_btn: next_btn.click() 👉不判断 class,直接尝试点击 + try/catch是最稳的方案。 接口返回: "showSkillTags":[{"tag":"五险一金"},{"tag":"年底双薪"}] ✅难点:标签数量不定,结构嵌套 ✅解法:数组遍历 + 逗号拼接(完整清洗函数暂不公开) 字段:hrStateInfo “刚刚活跃” “今日活跃” “本周活跃” 👉这是判断投递成功率的重要信号,很多爬虫直接忽略了。 ✅ 搜索框定位:css:.search-wrapper__input ✅ 搜索按钮:css:.search-wrapper__button ✅ 职位名称:name ✅ 公司名称:companyName ✅ 薪资字段:salary60 ✅ 职位详情 URL:positionUrl ✅ 接口路径:/c/i/search/positions 👉 以上这些,自己试 20 分钟就能写出来 ❌ for_new_tab() 后的Tab 生命周期管理(防止内存泄漏) ❌ 连续空页的三级熔断机制(不是简单 >=3) ❌ 职位标签的去重与归一化规则 ❌ HR活跃状态的权重打分算法 ❌ CSV 写入失败的异常回滚逻辑 👉 这些加起来,才是脚本能长期稳定运行的原因。 求职者:筛选“高薪 + HR活跃”的优质岗位 HR / 猎头:分析竞对公司招聘强度 数据分析师:做城市薪酬地图、行业人才流动模型 高校就业办:跟踪毕业生就业市场变化 爬虫不难,难的是在招聘网站这种强反爬环境下,稳定拿到干净数据。 如果你: 不想自己踩坑 需要可直接运行的完整源码 想要我私藏的翻页稳定性参数 👉 关注+点赞+推荐 评论区回复关键词:智联招聘 公众号里面还有: [Python爬取义乌购商品:监听接口+CSS精准定位,拿全批发价与真实成交量] [Python爬取安居客房源:城市房价数据采集实战] [Python爬取新浪新闻:接口监听与舆情分析]
已关注
关注
重播 分享 赞
一、为什么智联招聘值得爬?
二、核心难点
1️⃣ 新 Tab 监听(90%的人会踩坑)
2️⃣ 翻页的稳定性问题
3️⃣ 职位标签的数组清洗
4️⃣ HR活跃状态的隐性价值
三、我能告诉你的
四、我故意不告诉你的
五、这套数据能干什么?
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 为什么你总记不住Linux命令选项?可能是方法从一开始就错了
- 想在Linux下定时完成任务必备技能
- 时钟配置不对,驱动再好也白费:Linux 时钟框架入门
- Linux 查看系统时间hwclock
- 直接抄!8 个 Shell 脚本,把 Linux 服务器 SSH 防线焊死
- mkdir 命令完全指南:Linux目录管理的基石
- Linux30天入门计划|Day11:systemctl服务管理,控制服务启停与开机自启
- Windows 也能像 Linux一行命令装好所有软件
- C语言 goto 还能用吗?为什么 Linux 内核仍然大量使用它
- Linux 7.1:称之为“LLM 末日”,内核直接删除了138,000 行代码