第十一章 Python之多线程
本文从零开始,用最通俗的语言讲透 Python 多线程的所有核心知识点。每个概念都配有可直接运行的代码示例。
一、什么是多线程?
1.1 生活化理解
想象你在做饭:
- 单线程:你一个人,先煮饭(等30分钟),再炒菜,再烧水。全程串行,大量时间在"等"。
- 多线程:你同时开着电饭煲煮饭、锅里炒菜、壶里烧水。三件事交替进行,效率翻倍。
💡 核心概念:线程(Thread)是操作系统能够进行运算调度的最小单位。多线程就是让一个程序同时做多件事。
1.2 什么时候该用多线程?
二、第一个多线程程序
import threading
import time

def task(name):
    print(f"[{name}] 开始工作")
    time.sleep(2)  # 模拟耗时操作
    print(f"[{name}] 完成!")

# 创建两个线程
t1 = threading.Thread(target=task, args=("线程A",))
t2 = threading.Thread(target=task, args=("线程B",))

# 启动线程
t1.start()
t2.start()

# 等待所有线程完成
t1.join()
t2.join()

print("所有任务完成!")
运行结果:
[线程A] 开始工作
[线程B] 开始工作
(等待2秒)
[线程A] 完成!
[线程B] 完成!
所有任务完成!
🔑 关键点:两个线程几乎同时开始,总耗时约 2 秒而非 4 秒。这就是多线程的威力。
2.1 对比:不用多线程
import time

def task(name):
    print(f"[{name}] 开始工作")
    time.sleep(2)
    print(f"[{name}] 完成!")

task("任务A")  # 等2秒
task("任务B")  # 再等2秒
# 总耗时:4秒
三、创建线程的三种方式
方式一:传入函数(最常用)
import threading

def work():
    print(f"当前线程:{threading.current_thread().name}")

t = threading.Thread(target=work, name="MyThread")
t.start()
方式二:传入 lambda
import threading

t = threading.Thread(target=lambda: print("Hello from lambda thread"))
t.start()
t.join()
方式三:继承 Thread 类(面向对象)
import threading

class MyThread(threading.Thread):
    def __init__(self, name, count):
        super().__init__()
        self.name = name
        self.count = count

    def run(self):# 重写 run 方法
        for i in range(self.count):
            print(f"[{self.name}] 第 {i+1} 次执行")

t = MyThread("工作线程", 3)
t.start()
t.join()
⚠️ 注意:调用 t.start() 启动线程,不要直接调用 t.run()(那只是普通函数调用,不会创建新线程)。
四、线程的生命周期
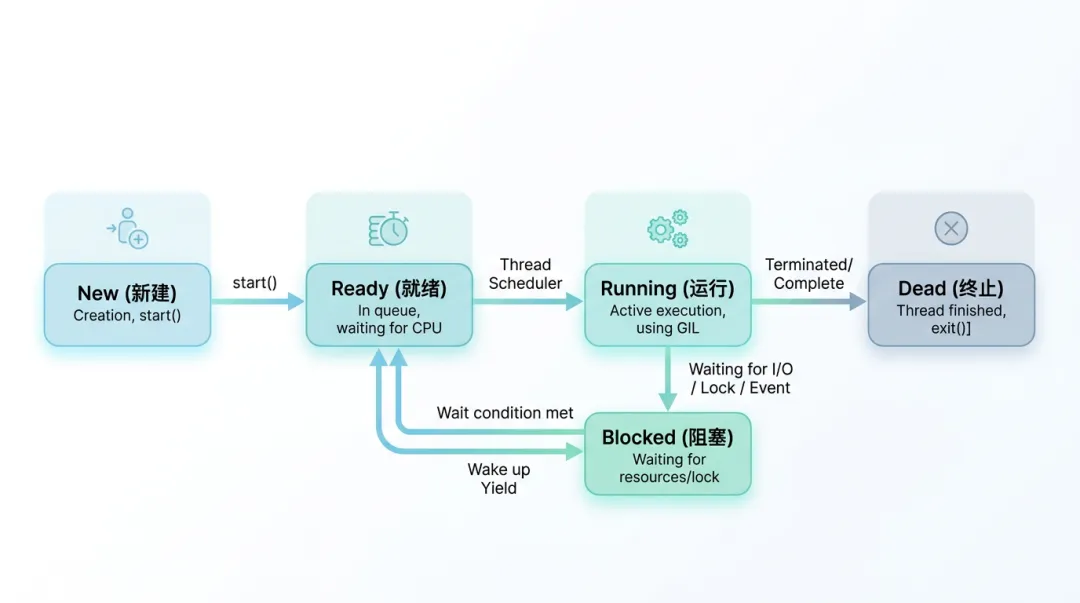 线程生命周期
线程从创建到销毁,经历以下状态:
| | |
|---|
| 新建(New) | | Thread() |
| 就绪(Ready) | | start() |
| 运行(Running) | | |
| 阻塞(Blocked) | | sleep() |
| 终止(Dead) | | |
常用线程方法
import threading
import time

def worker():
    time.sleep(1)

t = threading.Thread(target=worker)

print(t.is_alive())  # False(未启动)
t.start()
print(t.is_alive())  # True(运行中)
t.join()             # 阻塞主线程,等待 t 完成
print(t.is_alive())  # False(已结束)

# 获取当前活跃线程数
print(f"活跃线程数:{threading.active_count()}")
# 获取所有线程列表
print(f"所有线程:{threading.enumerate()}")
五、线程同步:Lock 和 RLock
5.1 为什么需要同步?—— 竞态条件
import threading

count = 0# 共享变量

def add():
    global count
    for _ in range(1000000):
        count += 1# ⚠️ 这不是原子操作!

t1 = threading.Thread(target=add)
t2 = threading.Thread(target=add)
t1.start()
t2.start()
t1.join()
t2.join()

print(f"期望值:2000000,实际值:{count}")
# 实际值往往小于 2000000!
💥 问题根因:count += 1 实际是三步:读取 → 加1 → 写回。两个线程可能同时读到相同的旧值。
5.2 使用 Lock 解决
import threading

count = 0
lock = threading.Lock()  # 创建互斥锁

def add():
    global count
    for _ in range(1000000):
        with lock:  # 自动 acquire() 和 release()
            count += 1

t1 = threading.Thread(target=add)
t2 = threading.Thread(target=add)
t1.start()
t2.start()
t1.join()
t2.join()

print(f"结果:{count}")  # 稳定输出 2000000 ✅
5.3 RLock(可重入锁)
import threading

rlock = threading.RLock()

def outer():
    with rlock:
        print("外层获得锁")
        inner()  # 同一线程可以再次获得锁

def inner():
    with rlock:
        print("内层获得锁")

outer()  # 如果用 Lock 会死锁,RLock 不会
🔑 Lock vs RLock:
RLock:同一线程可多次获取,内部计数,全部释放才真正解锁
六、线程通信:Event、Condition、Queue
6.1 Event(事件通知)
一个线程发信号,其他线程等待。
import threading
import time

event = threading.Event()

def waiter():
    print("等待信号...")
    event.wait()  # 阻塞,直到 event 被 set
    print("收到信号,继续执行!")

def setter():
    time.sleep(2)
    print("发送信号!")
    event.set()  # 唤醒所有等待的线程

threading.Thread(target=waiter).start()
threading.Thread(target=setter).start()
6.2 Condition(条件变量)
更精细的控制:等待某个条件满足。
import threading
import time

condition = threading.Condition()
data_ready = False

def consumer():
    global data_ready
    with condition:
        whilenot data_ready:
            condition.wait()  # 释放锁并等待
        print("消费者:拿到数据了!")
        data_ready = False

def producer():
    global data_ready
    time.sleep(1)
    with condition:
        data_ready = True
        condition.notify()  # 唤醒一个等待者
        print("生产者:数据准备好了!")

threading.Thread(target=consumer).start()
threading.Thread(target=producer).start()
6.3 Queue(线程安全队列)⭐推荐
最常用、最安全的线程间通信方式。
import threading
import queue
import time

q = queue.Queue(maxsize=5)  # 最多存5个元素

def producer():
    for i in range(10):
        q.put(f"产品-{i}")  # 队列满时自动阻塞
        print(f"生产:产品-{i}")

def consumer():
    while True:
        item = q.get()  # 队列空时自动阻塞
        print(f"消费:{item}")
        q.task_done()  # 标记完成

threading.Thread(target=producer).start()
threading.Thread(target=consumer, daemon=True).start()

q.join()  # 等待所有任务完成
print("全部处理完毕!")
七、守护线程(Daemon)
💡 守护线程:当所有非守护线程结束时,守护线程会被强制终止,不管它有没有执行完。
import threading
import time

def background_task():
    while True:
        print("后台监控中...")
        time.sleep(1)

# 设置为守护线程
t = threading.Thread(target=background_task, daemon=True)
t.start()

time.sleep(3)
print("主线程结束,守护线程自动终止")
# 程序在此退出,不会无限循环
⚠️ 注意:daemon=True 必须在 start() 之前设置。
八、线程局部数据(Thread-Local)
每个线程拥有独立的变量副本,互不干扰。
import threading

local_data = threading.local()

def process(name):
    local_data.value = name  # 每个线程设置自己的 value
    print(f"[{name}] 设置 value = {name}")
    print(f"[{name}] 读取 value = {local_data.value}")  # 读到的是自己的

t1 = threading.Thread(target=process, args=("Alice",))
t2 = threading.Thread(target=process, args=("Bob",))
t1.start()
t2.start()
t1.join()
t2.join()
输出:
[Alice] 设置 value = Alice
[Bob] 设置 value = Bob
[Alice] 读取 value = Alice
[Bob] 读取 value = Bob
🔑 典型用途:Web 框架中为每个请求线程保存用户会话信息(如 Flask 的 g 对象)。
九、线程池(ThreadPoolExecutor)
手动管理线程很麻烦,线程池帮你自动管理。
场景:你一个人在家,有6个快递要寄出,但每次只能跑一趟驿站。如果自己去,要跑6趟,很累。
用线程池:相当于叫了3个快递员(max_workers=3)同时帮你跑,6个快递分两批就送完了。
python
from concurrent.futures import ThreadPoolExecutor, as_completed
import time
import random

# 模拟寄快递:每个快递需要不同时间打包
def send_package(package_id):
    cost = random.randint(1, 4)  # 打包耗时 1~4 秒
    print(f"📦 开始处理包裹 {package_id}(预计 {cost} 秒)")
    time.sleep(cost)
    result = f"包裹 {package_id} 已寄出"
    return result

# 有 6 个包裹要寄
packages = [101, 102, 103, 104, 105, 106]

# 创建线程池:3 个快递员同时干活
with ThreadPoolExecutor(max_workers=3) as executor:
    # 把所有包裹交给快递员
    futures = {executor.submit(send_package, pkg): pkg for pkg in packages}

    # 谁先完成就先取谁的结果
    for future in as_completed(futures):
        pkg = futures[future]
        try:
            result = future.result()
            print(f"✅ {result}")
        except Exception as e:
            print(f"❌ 包裹 {pkg} 出问题了: {e}")
输出效果(大致是这样):
📦 开始处理包裹 101(预计 3 秒)
📦 开始处理包裹 102(预计 1 秒)
📦 开始处理包裹 103(预计 4 秒)
✅ 包裹 102 已寄出        ← 102 最快完成
📦 开始处理包裹 104(预计 2 秒)
✅ 包裹 101 已寄出
📦 开始处理包裹 105(预计 3 秒)
✅ 包裹 104 已寄出
📦 开始处理包裹 106(预计 2 秒)
✅ 包裹 106 已寄出
✅ 包裹 105 已寄出
✅ 包裹 103 已寄出
线程池的好处(对比自己手动搞线程)
| | |
|---|
| 创建线程 | 每个任务都要 Thread(target=...),代码啰嗦 | |
| 控制并发数 | | max_workers |
| 获取返回值 | | future.result() |
| 异常处理 | | try-except |
| 等待所有任务完成 | | with |
| 资源管理 | | with |
一句话总结
线程池 = 一个“任务调度员”,你只管交任务,它自动分配线程、控制并发、收集结果、清理资源。
9.1 更简洁的写法:map
from concurrent.futures import ThreadPoolExecutor

def square(n):
    return n * n

with ThreadPoolExecutor(max_workers=4) as executor:
    results = list(executor.map(square, [1, 2, 3, 4, 5]))
    print(results)  # [1, 4, 9, 16, 25]
9.2 线程池参数建议
十、GIL:Python 多线程的"天花板"
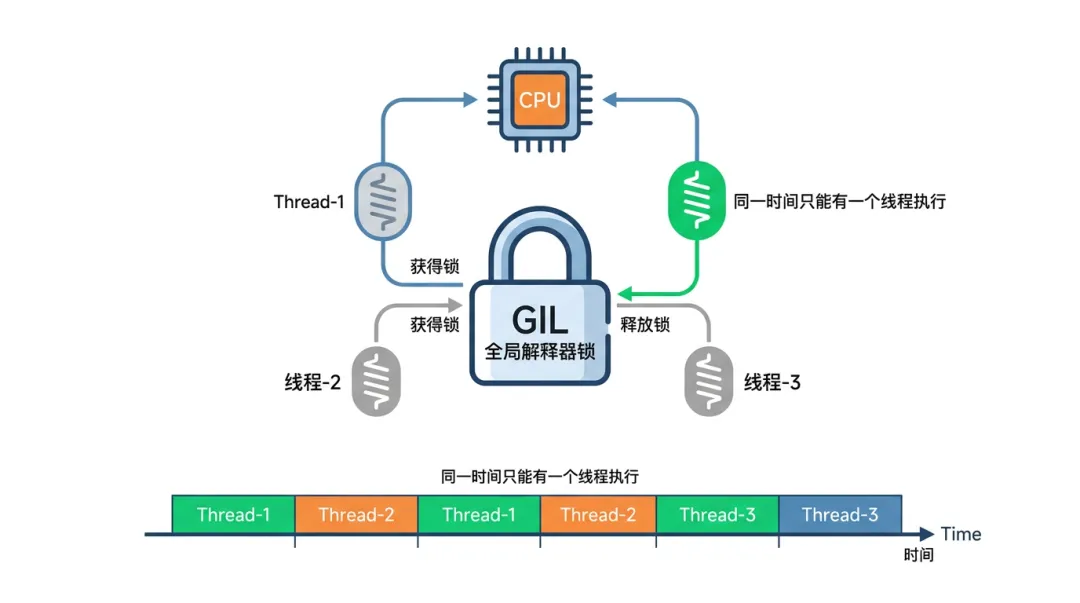 GIL工作原理
10.1 什么是 GIL?
GIL(Global Interpreter Lock,全局解释器锁):CPython 解释器中的一把全局锁,同一时刻只允许一个线程执行 Python 字节码。
10.2 实际影响
import threading
import time

# CPU密集型任务
def cpu_task():
    count = 0
    for _ in range(50_000_000):
        count += 1

# 单线程
start = time.time()
cpu_task()
cpu_task()
print(f"单线程:{time.time() - start:.2f}秒")

# 多线程(并不会更快!)
start = time.time()
t1 = threading.Thread(target=cpu_task)
t2 = threading.Thread(target=cpu_task)
t1.start()
t2.start()
t1.join()
t2.join()
print(f"多线程:{time.time() - start:.2f}秒")
# 多线程甚至可能更慢(线程切换开销)
10.3 那多线程还有用吗?
有用! GIL 在 IO 等待时会释放:
💡 结论:Python 多线程适合 IO密集型 任务,CPU密集型请用 多进程(multiprocessing)。
十一、多线程 vs 多进程 vs 协程
# 多进程示例(CPU密集型正确选择)
from multiprocessing import Pool

def heavy_calc(n):
    return sum(i * i for i in range(n))

with Pool(4) as p:
    results = p.map(heavy_calc, [10_000_000] * 4)
    print(results)
十二、常见陷阱与最佳实践
❌ 陷阱一:忘记 join 导致主线程提前退出
# 错误
t = threading.Thread(target=long_task)
t.start()
print("完成!")  # 可能在 t 还没结束时就打印了

# 正确
t.start()
t.join()  # 等待线程结束
print("完成!")
❌ 陷阱二:在循环中创建线程却不管理
# 错误:创建了1000个线程,可能耗尽资源
for i in range(1000):
    threading.Thread(target=task, args=(i,)).start()

# 正确:使用线程池
from concurrent.futures import ThreadPoolExecutor
with ThreadPoolExecutor(max_workers=10) as executor:
    executor.map(task, range(1000))
❌ 陷阱三:死锁
import threading
import time

lock_a = threading.Lock()
lock_b = threading.Lock()

def thread1():
    with lock_a:
        time.sleep(0.1)
    with lock_b:  # 等待 lock_b
        pass

def thread2():
    with lock_b:
        time.sleep(0.1)
    with lock_a:  # 等待 lock_a → 死锁!
        pass
✅ 避免死锁:所有线程按相同顺序获取锁。
✅ 最佳实践清单
| |
|---|
| 优先使用 with lock: 而非手动 acquire/release |
| |
| |
| |
| |
| |
| |
| 生产环境考虑用 concurrent.futures 替代裸线程 |
总结
Python 多线程知识图谱:

threading 模块
├── Thread(创建线程)
├── Lock / RLock(互斥同步)
├── Event / Condition(条件通信)
├── Semaphore(限流)
├── Barrier(栅栏同步)
├── local(线程局部数据)
└── Timer(定时器)

concurrent.futures
├── ThreadPoolExecutor(线程池)
├── Future(异步结果)
└── as_completed(完成回调)

queue 模块
├── Queue(FIFO)
├── LifoQueue(LIFO/栈)
└── PriorityQueue(优先级)
🎯 一句话总结:Python 多线程是处理 IO 密集型并发任务的利器,核心就是——创建线程、同步共享、安全通信。掌握 Lock + Queue + ThreadPoolExecutor 这三件套,就能应对 90% 的实际场景。
文章完 | 所有代码均可在 Python 3.8+ 环境直接运行
 10个月宝宝每天需要喝多少奶粉?