Linux CPU 性能优化:从应用到内核的五个关键方向
CPU 往往是系统最宝贵的资源之一。很多性能问题并不是 CPU 不够快,而是 CPU 没有被高效地利用。真正的 CPU 性能优化,需要从应用程序、编译器、内核调度器、CPU 亲和性以及内存分配器等多个层面综合考虑。
本文介绍 Linux CPU 调优中最重要的五个方面。

1. Application 调优——收益最大的优化
无论硬件多么先进,算法和代码质量始终决定了性能上限。(属于常见优化)
应用层优化通常包括:
●选择更优的数据结构和算法
●减少锁竞争(Lock Contention)
●使用无锁(Lock-free)或 RCU 等技术
●减少系统调用(System Call)
●批量处理(Batch Processing)
●Cache Friendly 数据布局
●减少不必要的数据拷贝(Zero Copy,比如sendfile, mmap)
例如:
O(n²) -> O(n log n)
这种优化带来的收益,远远超过任何 CPU 参数调整。
另外,还应借助性能分析工具定位热点,例如:
●perf
●bpftrace
●flamegraph
●gprof
遵循 Profile First,Optimize Later 的原则,而不是盲目优化。
2. GCC 编译器优化
现代 GCC 已经能够生成非常高效的机器代码。(属于常见优化)
常见优化选项包括:
-O2(最常用了)
默认推荐,兼顾性能和代码体积。
-O3
开启更多循环优化、自动向量化等,适用于计算密集型程序。
-march=native
3. Linux Scheduler 调优
Linux 调度器决定了线程运行在哪个 CPU 上,以及什么时候运行。
现代 Linux 默认采用:
Completely Fair Scheduler(CFS)
可以通过nice调整process priority, 间接影响运行的time长度 (比较常见)
对于普通应用,调度器已经能够很好地完成:
●Load Balance
●NUMA Balance
●CPU Migration
●Fair Scheduling
但是在高性能场景中,频繁迁移线程可能导致:
●CPU Cache Miss
●TLB Miss
●NUMA Remote Access
因此需要减少线程迁移。
常见调优包括:
关闭自动 NUMA:
kernel.numa_balancing=0
调整调度粒度:
sched_min_granularity_ns
sched_wakeup_granularity_ns
实时任务可以使用:(相对很少见)
SCHED_FIFO
SCHED_RR
而普通服务一般保持:
SCHED_OTHER (CFS)
对于高吞吐系统,减少 Context Switch 和 CPU Migration 往往能明显提升性能。

4. CPU Binding vs CPU Set
很多人容易混淆 CPU Affinity(绑定)和 CPU Set。
CPU Binding(CPU Affinity)
CPU Affinity 是针对单个进程或线程指定可以运行的 CPU。 (其实用的也没那么多)
例如:
taskset -c 0-3 ./server
或者:
sched_setaffinity()
优点:
●减少 Cache Miss
●减少 CPU Migration
●提高 L1/L2 Cache 命中率
适合:
●数据库
●高性能网络
●高频交易
CPU Set(cpuset)
cpuset 是 Linux cgroup 提供的一种资源隔离机制。 (其实用的也没那么多)
例如:
cpuset.cpus=0-7
cpuset.mems=0
它不仅限制 CPU,还限制:
●Memory Node
●NUMA Node
通常用于:
●Kubernetes Guaranteed Pod
●Docker
●NUMA 隔离
因此:
CPU Binding 更关注线程级别的调度优化。
CPU Set 更关注系统资源隔离。
两者可以结合使用。
5. Memory Allocator 优化
很多 CPU 时间实际上消耗在 malloc/free 上。(这个调优比较常见, jemalloc用的很多)
Linux 默认使用:
ptmalloc
glibc 默认实现。
优点:
●通用
●稳定
缺点:
●多线程锁竞争较明显
●Fragmentation 较高
tcmalloc
由 Google 开发。
特点:
●Thread Cache
●极低锁竞争
●小对象分配速度快
非常适合:
●RPC
●Web Server
●Redis 类服务
jemalloc
由 Facebook 等广泛使用。(这个综合性能最好了,其实很长用)
特点:
●Fragmentation 极低
●Arena 设计
●NUMA 支持较好
很多数据库默认采用 jemalloc,例如:
●ClickHouse
●Redis(可选)
●TiDB(部分组件)
切换allocator很简单(很常见)
不需要重新编译代码。比如使用jemalloc
LD_PRELOAD=/usr/lib/x86_64-linux-gnu/libjemalloc.so.2 ./myapp
malloc()
│
▼
glibc malloc
│
▼
被 LD_PRELOAD 拦截
│
▼
jemalloc malloc()
对于大量小对象分配,切换 allocator 往往能带来 10%~30% 的性能提升,并降低 CPU 使用率。
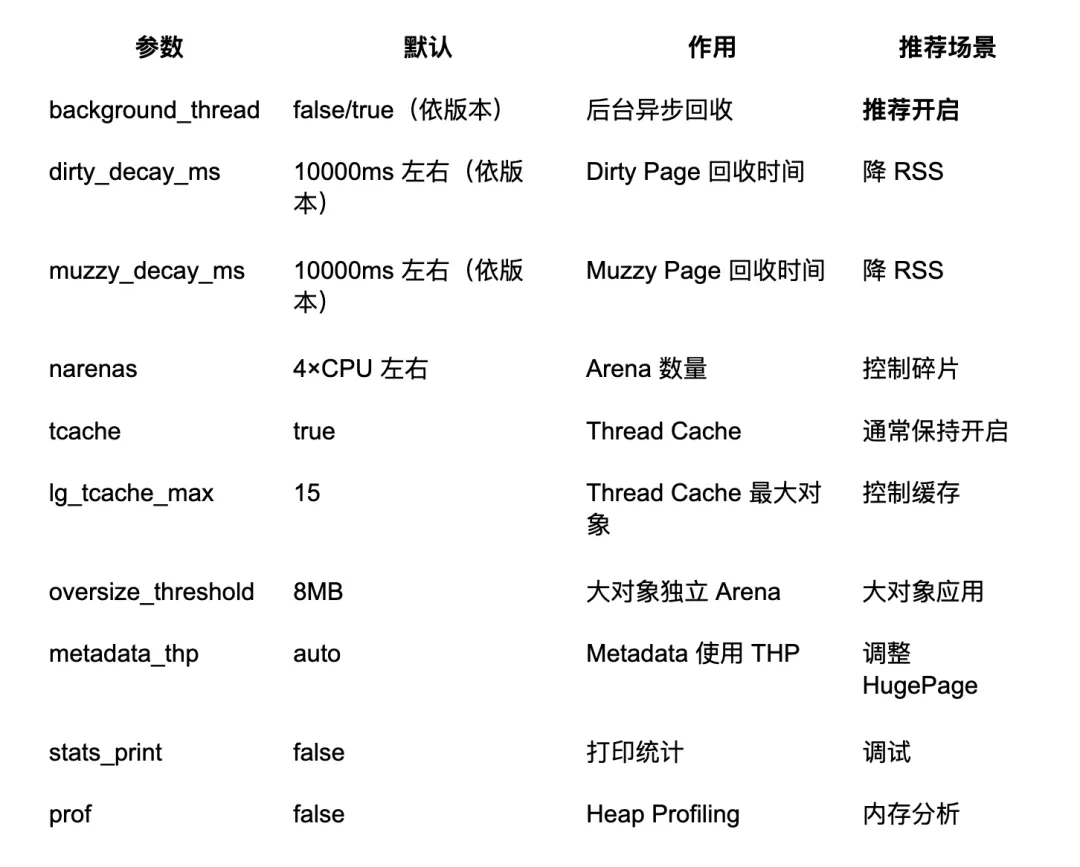
具体allocator还能调优(不常见)
比如jemalloc, 通过MALLOC_CONF
export MALLOC_CONF="background_thread:true,dirty_decay_ms:1000,muzzy_decay_ms:1000"
./myapp
总结
Linux CPU 调优并不是简单地提高 CPU 使用率,而是尽可能减少无效计算、调度开销和资源竞争。通常可以按照以下优先级进行优化:
1.Application:优化算法、数据结构、锁竞争,是收益最大的方向。
2.Compiler:合理使用 GCC 优化选项(如 -O3、-march=native、LTO、PGO),充分发挥硬件能力。
3.Scheduler:理解 Linux 调度机制,减少线程迁移和上下文切换,提高缓存命中率。
4.CPU Affinity / cpuset:根据业务特点进行线程绑定和资源隔离,改善 Cache 与 NUMA 局部性。
5.Memory Allocator:针对多线程、高并发或大内存场景选择合适的内存分配器,降低锁竞争和内存碎片。
需要强调的是,性能优化应以数据为依据。在修改任何参数或替换组件之前,应使用 perf、bpftrace、Flame Graph 等工具定位瓶颈,并通过基准测试验证优化效果。只有建立在性能分析基础上的调优,才能真正提升系统吞吐量、降低延迟,并充分释放 CPU 的计算能力。
 10个月宝宝每天需要喝多少奶粉?