期刊图片复现|Python绘制泰勒图
- 2026-10-11 06:11:45
期刊图片复现|Python绘制泰勒图
论文:Global Evaluation of Runoff Simulation From Climate, Hydrological and Land Surface Models 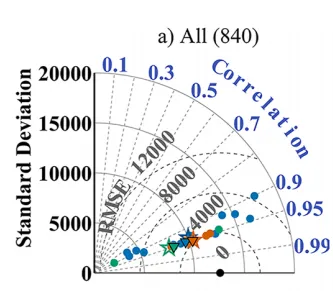
论文原图 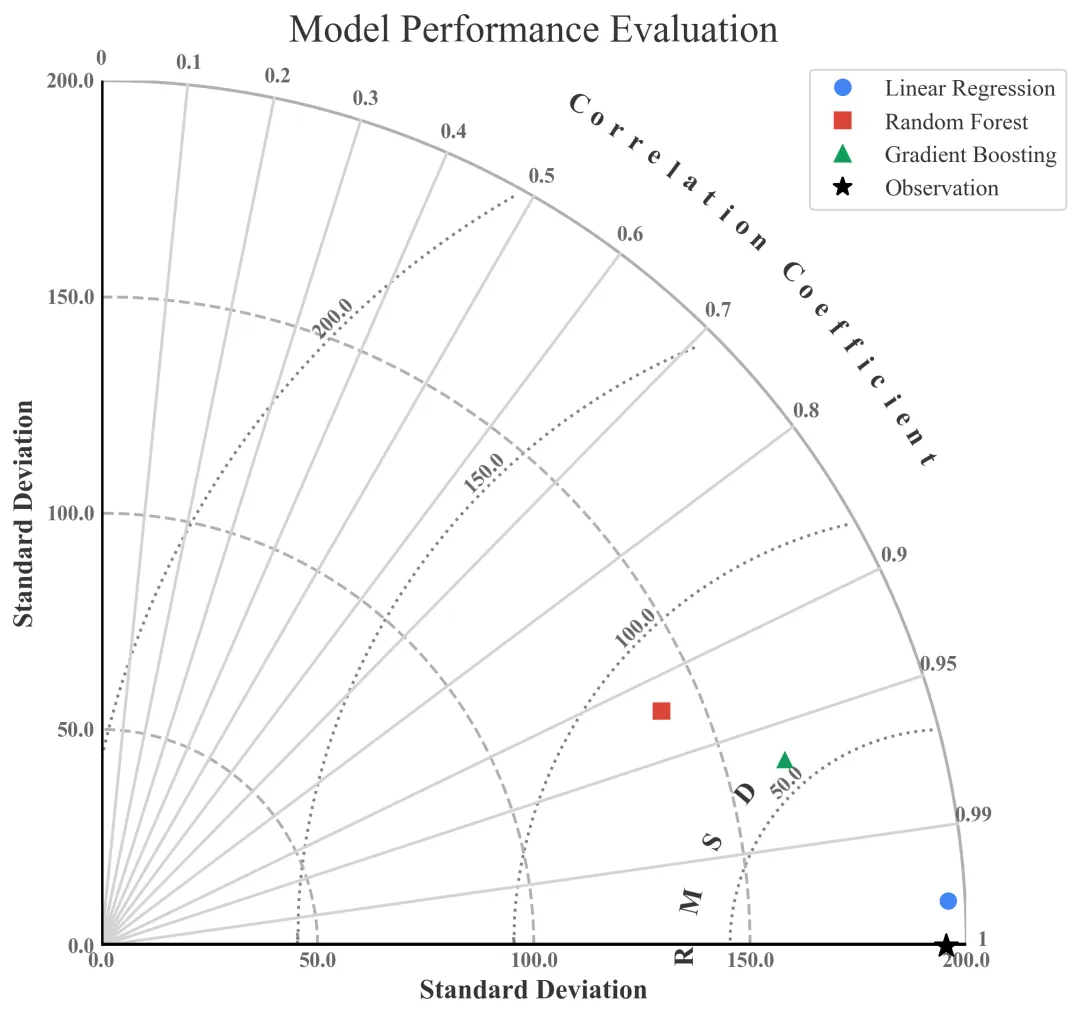
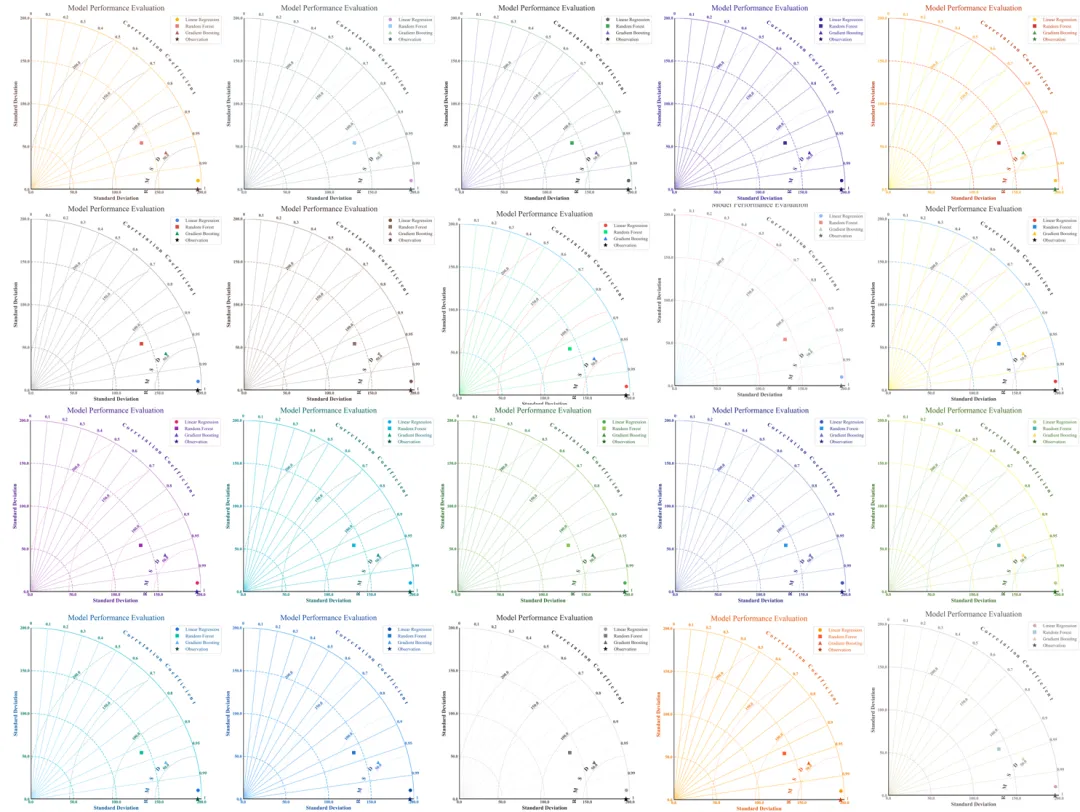
多种配色 
导入库与全局样式配置,是代码实现的基础同时也是绘图前的准备工作。 
颜色库 
绘图函数 
数据的读取与处理,主要修改这里 
模型的构建 
执行绘图 
期刊图片复现|Python绘制二维偏依赖PDP图 期刊复现|python绘制基于SHAP分析和GAM模型拟合的单特征依赖图 期刊图片复现|python绘制带有渐变颜色shap特征重要性组合图(条形图+蜂巢图) 期刊复现|用Python绘制SHAP特征重要性总览图、依赖图、双特征交互效应SHAP图,解锁XGBoost模型的终极奥秘 期刊图片复现|Python绘制shap重要性蜂巢图+单特征依赖图+交互效应强度气泡图+交互效应依赖图(回归+二分类+分类) 
需要的请后台私信我获取详细信息,注意只会分享练习数据和代码文件,不会提供答疑服务,代码文件中已经包含了每行代码的完整注释!!!
代码绘制成果展示
标准差:从左下角原点 (0,0) 出发的径向距离。X轴和Y轴的刻度都代表标准差。图中的虚线圆弧是标准差的等值线。模型的标准差与观测数据的标准差越接近,说明模型能更好地再现真实数据的波动范围
相关系数:从原点出发的射线与X轴正方向的夹角。角度越小,越靠近X轴,相关系数越高。相关系数越接近1,说明模型的预测趋势与真实情况越一致
中心化均方根误差:图中任意一点到X轴上“观测点”(五角星)的直线距离。图中的点状虚线圆弧是RMSD的等值线。距离观测点越近,说明模型的综合性能越好
观测点:五角星
线性回归:圆形
随机森林:方形
梯度提升:三角形
代码解释
第一部分
# =========================================================================================# ====================================== 1. 库的导入 =========================================# =========================================================================================import numpy as npimport matplotlib.pyplot as pltimport skill_metrics as smimport matplotlib.lines as mlinesimport pandas as pdfrom sklearn.model_selection import train_test_split, GridSearchCVfrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import LinearRegressionfrom sklearn.ensemble import RandomForestRegressor, GradientBoostingRegressorimport matplotlibmatplotlib.rcParams['pdf.fonttype'] = 42matplotlib.rcParams['ps.fonttype'] = 42plt.rcParams['font.family'] = 'serif'plt.rcParams['font.serif'] = ['Times New Roman']plt.rcParams['axes.unicode_minus'] = False
第二部分
# =========================================================================================# ====================================== 2. 颜色库 =========================================# =========================================================================================selected_palette = 20 #选择配色方案color_palettes = {1: {"Linear Regression": "#4285F4", #"Random Forest": "#DB4437","Gradient Boosting": "#0F9D58","Observation": "#000000","point_std_color": "#B0B0B0","point_cor_color": "#D3D3D3","point_rms_color": "#808080","plot_bgcolor": "#FFFFFF","label_color": "#333333","tick_color": "#666666"},}selected_colors = color_palettes[selected_palette ] # 从颜色库中获取指定索引的配色方案
第三部分
# =========================================================================================# ======================================3.绘图函数=========================================# =========================================================================================def plot_taylor_diagram(model_stats, sdev_obs, colors):fig = plt.figure(figsize=(10, 8))fig.patch.set_facecolor("#FFFFFF")ax = plt.gca()ax.set_facecolor("#FFFFFF")sm.taylor_diagram(np.array([sdev_obs]),np.array([0.0]),np.array([1.0]),colSTD=colors.get('point_std_color', '#606060'),colCOR=colors.get('point_cor_color', '#808080'),colRMS=colors.get('point_rms_color', '#404040'),styleSTD='--',styleCOR='-',styleRMS=':',alpha=1)for label in ax.get_xticklabels() + ax.get_yticklabels():label.set_fontsize(11)label.set_fontweight('bold')label.set_color(colors.get('tick_color', '#666666'))for name, group in model_stats.items():sdev, ccoef = group["stats"]style = group["style"]x = sdev * ccoefy = sdev * np.sin(np.arccos(ccoef))plt.scatter(x, y,s=style.get('s', 80),c=style.get('color', 'black'),marker=style.get('marker', 'o'),edgecolors=style.get('edgecolors', 'none'),linewidths=1.5,zorder=10)plt.scatter(sdev_obs, 0, s=150, c=colors['Observation'], marker='*', zorder=10, clip_on=False, label='Observation')plt.title('Model Performance Evaluation', fontsize=20, pad=20, color=colors.get('label_color', '#333333'))legend_handles = [mlines.Line2D([], [], color=colors['Linear Regression'], marker='o', linestyle='None', markersize=8, label='Linear Regression'),mlines.Line2D([], [], color=colors['Random Forest'], marker='s', linestyle='None', markersize=8, label='Random Forest'),mlines.Line2D([], [], color=colors['Gradient Boosting'], marker='^', linestyle='None', markersize=8, label='Gradient Boosting'),mlines.Line2D([], [], color=colors['Observation'], marker='*', linestyle='None', markersize=10, label='Observation')]legend = fig.legend(handles=legend_handles, loc='upper right', bbox_to_anchor=(0.9, 0.9), numpoints=1, fontsize=12)for text in legend.get_texts():text.set_color(colors.get('label_color', '#333333'))ax.tick_params(axis='x', length=0)ax.tick_params(axis='y', length=0)for label in ax.get_xticklabels() + ax.get_yticklabels():label.set_color(colors.get('tick_color', '#666666'))plt.savefig(fr'taylor_diagram_{selected_palette }.png', dpi=300, bbox_inches='tight')plt.savefig(fr'taylor_diagram_{selected_palette }.pdf', bbox_inches='tight')
第四部分
# =========================================================================================# ======================================4.数据的读取与处理=========================================# =========================================================================================file_path = r"simulated_data.xlsx" # 定义Excel文件所在的路径data_df = pd.read_excel(file_path) #读取数据X = data_df.iloc[:, :-1].values #提取特征数据y = data_df.iloc[:, -1].values #提取目标变量数据#划分训练集和验证集X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.3, random_state=42)#标准化处理scaler = StandardScaler()X_train_scaled = scaler.fit_transform(X_train)X_val_scaled = scaler.transform(X_val)
第五部分
# =========================================================================================# ======================================5.模型的构建=========================================# =========================================================================================# 设置要进行网格搜索的模型和参数范围param_grids = {"Random Forest": {'model': RandomForestRegressor(random_state=42),'params': {'n_estimators': [50, 100],'max_depth': [10, 20]}},"Gradient Boosting": {'model': GradientBoostingRegressor(random_state=42),'params': {'n_estimators': [50, 100],'learning_rate': [0.05, 0.1]}}}#存储最佳模型best_models = {"Linear Regression": LinearRegression()}#执行网格搜索for name, grid_info in param_grids.items(): #遍历每个模型配置print(f"\n--- 正在为模型 '{name}' 进行网格搜索 ---")grid_search = GridSearchCV(estimator=grid_info['model'],param_grid=grid_info['params'],cv=3,n_jobs=-1,scoring='neg_mean_squared_error')#执行网格搜索grid_search.fit(X_train_scaled, y_train)print(f"'{name}' 找到的最佳超参数: {grid_search.best_params_}")#保存最佳模型best_models[name] = grid_search.best_estimator_
第六部分
# =========================================================================================# ======================================6.绘图=========================================# =========================================================================================#用于存储每个模型的性能统计数据model_performance_stats = {}#计算标准差observation_sdev = np.std(y_val)# 评估每个模型for name, model in best_models.items(): # 遍历存储了最佳模型的字典print(f"\n正在评估模型: {name}...")# 线性回归模型需要单独训练if name == "Linear Regression": # 判断是否为线性回归模型model.fit(X_train_scaled, y_train) # 如果是,则在标准化的训练数据上进行训练# 进行预测predictions = model.predict(X_val_scaled) # 使用训练好的模型对标准化的验证集进行预测# 计算泰勒图所需的两个指标:标准差和相关系数pred_sdev = np.std(predictions) # 计算模型预测值的标准差corr = np.corrcoef(y_val, predictions)[0, 1] # 计算预测值与真实值之间的相关系数# 计算预测值和观测值的离差(减去各自的均值)pred_anomalies = predictions - np.mean(predictions)obs_anomalies = y_val - np.mean(y_val)#计算中心化均方根误差rmsd = np.sqrt(np.mean((pred_anomalies - obs_anomalies) ** 2))# 打印出模型的各项性能指标print(f"标准差: {pred_sdev:.3f}")print(f"相关系数: {corr:.3f}")print(f"中心化均方根误差: {rmsd:.3f}")# 存储统计数据model_performance_stats[name] = { # 将计算出的统计数据存入字典"stats": (np.array([pred_sdev]), np.array([corr])), # 存储标准差和相关系数}# 为每个模型设定绘图样式model_performance_stats["Linear Regression"]["style"] = {'color': selected_colors["Linear Regression"],'marker': 'o','s': 80}model_performance_stats["Random Forest"]["style"] = {'color': selected_colors["Random Forest"],'marker': 's','s': 80}model_performance_stats["Gradient Boosting"]["style"] = {'color': selected_colors["Gradient Boosting"],'marker': '^','s': 80}print("\n所有模型评估完毕,开始绘图...")#调用绘图函数plot_taylor_diagram(model_performance_stats, observation_sdev, selected_colors)
如何应用?
1.选择配色方案:
selected_palette = 202.选择使用的数据:
file_path = r"data.xlsx" 3.提取目标数据和特征数据:
X = data_df.iloc[:, :-1].valuesy = data_df.iloc[:, -1].values
推荐
获取方式
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
