Linux Memory 观测工具
当系统出现 内存不足(OOM)、Swap 增长、Page Fault 激增、NUMA 不均衡、Slab 泄漏 或 应用内存持续上涨 时,第一步通常不是修改参数,而是观察(Observe)。
Linux 提供了丰富的内存观测工具,覆盖系统、进程、NUMA、Slab、Page Fault 等多个层面。本文介绍性能分析中最常用的几种工具,以及它们适合解决的问题。
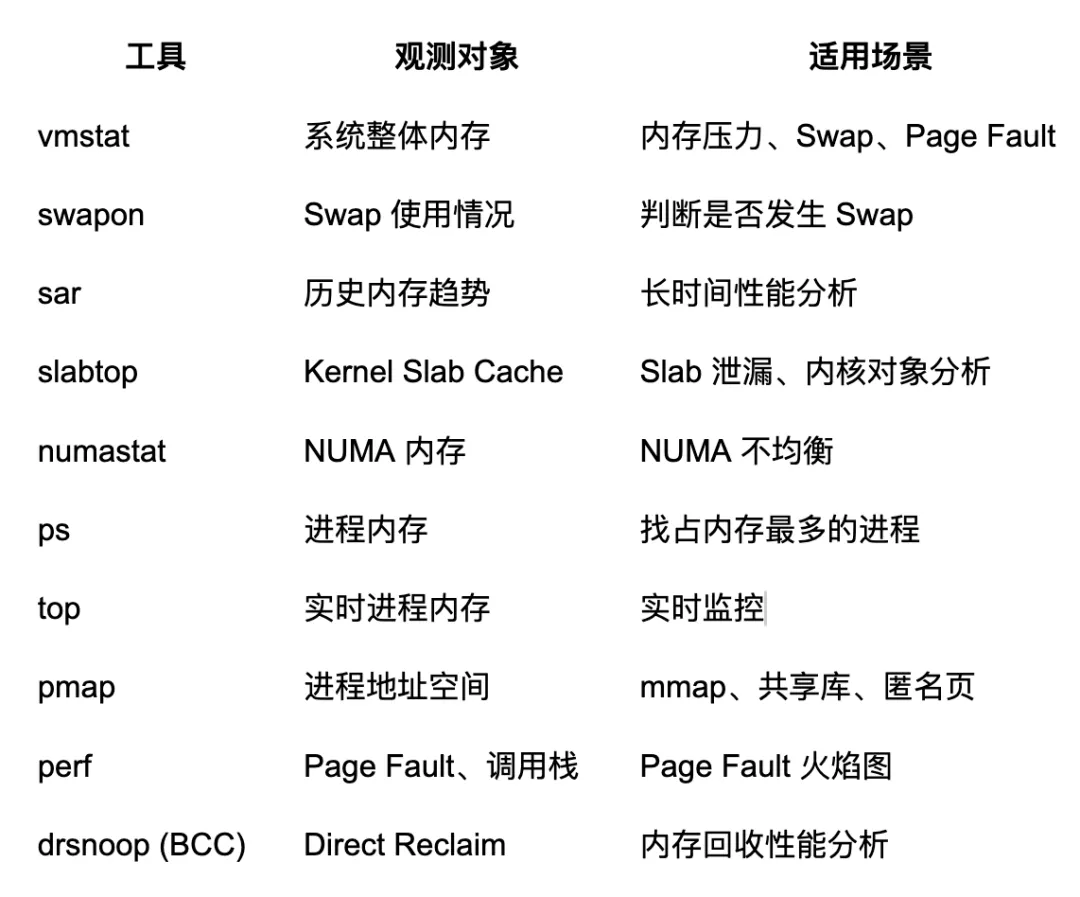
Linux Memory 观测工具
可以按照观测对象分为几类:
这些工具几乎覆盖了 Linux Memory Performance Analysis 的整个生命周期。

1. vmstat —— 系统级内存概览
vmstat(Virtual Memory Statistics)是分析 Linux 内存问题时最先使用的工具之一。
vmstat 1
示例:
procs --------memory--------- ---swap-- -----io---- -system-- ------cpu-----
rbswpdfreebuffcachesisobiboincs us sy id wa
100 520000 320000 21000000001 1200 300052 930
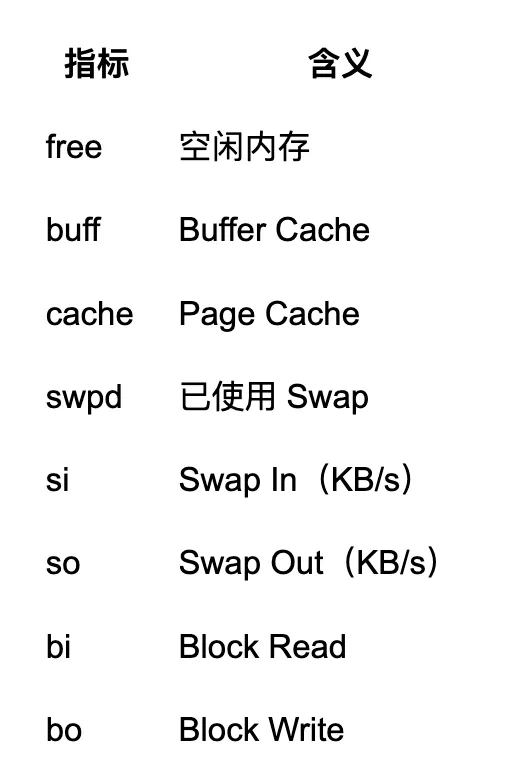
重点关注以下指标:
经验判断:
●si/so 持续大于 0,说明系统正在频繁 Swap。
●free 很低并不一定表示内存不足,需要结合 cache 一起分析。
●cache 很高通常属于正常现象,因为 Linux 会充分利用空闲内存作为 Page Cache。
特别说明: page Cache 里面包括active 和inactive, 只有inactive可以被释放。
sudo sync
echo 1 | sudo tee /proc/sys/vm/drop_caches
其中:
●sync:先将脏页(Dirty Pages)写回磁盘,避免数据丢失。
●echo 1:释放 Page Cache (inactive)。

2. swapon —— 查看 Swap 使用情况
查看当前 Swap:
swapon --show
或:
cat /proc/swaps
示例:
NAMETYPE SIZE USED PRIO
/dev/sda2 partition 8G 512M -2
重点关注:
●Swap 总大小
●已使用 Swap
●是否启用了多个 Swap Device
如果 Swap 持续增长,需要进一步分析:
●是否发生内存泄漏?
●是否物理内存不足?
●是否 Page Cache 占用过高?
说明: 其实生产环境,考虑到性能稳定,都会关闭swap (swapoff)
3. sar —— 历史内存统计
sar 属于 sysstat 工具集,适用于分析历史性能数据。
查看内存:
sar -r 1
查看 Swap:
sar -S 1
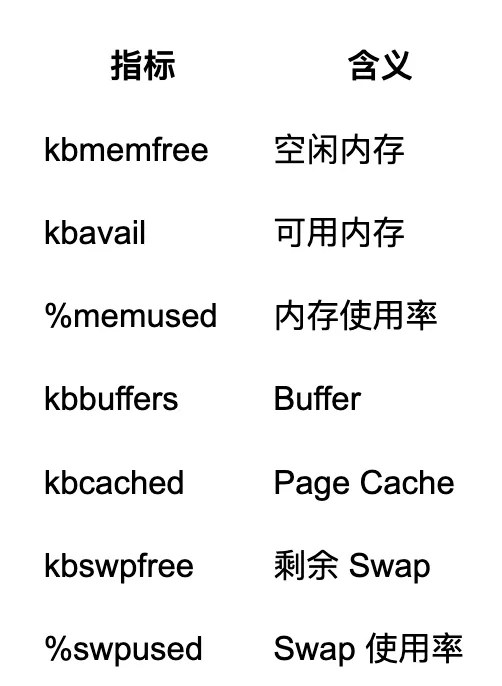
常见指标:
sar -B 可以看page-fault,page-scan
Linux 6.8.0-136-generic (ubuntu2204) 08/07/26 _aarch64_(4 CPU)
07:33:21pgpgin/s pgpgout/sfault/smajflt/spgfree/s pgscank/s pgscand/s pgsteal/s%vmeff
08:41:320.021697.451221.320.001400.320.000.000.000.00
08:50:020.001.533.340.007.300.000.000.000.00
相比 vmstat,sar 更适合观察内存变化趋势和进行容量规划。

4. slabtop —— Slab Cache 分析
Linux 内核使用 Slab 分配器管理大量小对象(可以看做是内核里面的对象池),如:
●inode
●dentry
●task_struct
●file
●kmalloc
查看 Slab:
slabtop
示例:
OBJS ACTIVE USE OBJ SIZE SLABS OBJ/SLAB CACHE SIZE NAME
重点关注:
●NAME:缓存类型
●OBJ SIZE:对象大小
●USE:使用率
●CACHE SIZE:总占用内存
如果某类 Slab Cache 持续增长且无法回收,可能存在内核内存泄漏。
说明:一般常用slabtop -sc, 进行排序,查看哪些slab占用较多内存
可以进行一定程度的释放
echo 2 | sudo tee /proc/sys/vm/drop_caches
释放:
●dentry cache(目录项缓存)
●inode cache(inode 缓存)

5. numastat —— NUMA 内存统计
NUMA 系统建议优先访问本地内存。
查看:
numastat
示例:
Node0Node1
numa_hit1000000 900000
numa_miss120300
local_node1200000 800000
other_node5000 10000
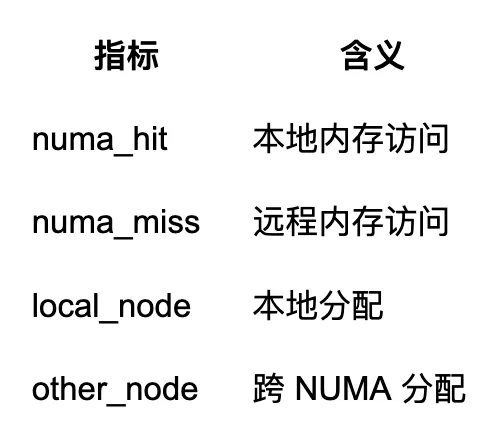
关键指标:
如果 numa_miss 较高,可能导致更高的内存访问延迟。这里可以通过numa bind进行优化

6. ps —— 查看进程内存
查看占用内存最多的进程:
ps aux --sort=-rss
或:
ps -eo pid,comm,rss,vsz,%mem
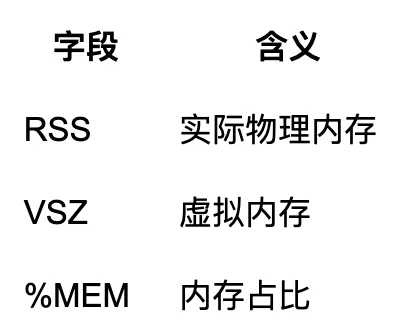
常见指标:
通常排查内存泄漏时,会先通过 ps 找到占用内存异常增长的进程。核心看RSS

7. top —— 实时监控内存
启动:
top
关注:
●%MEM
●RES(Resident Set Size)
●VIRT(Virtual Memory)
●SHR(Shared Memory)
顶部还会显示系统整体内存:
MiB Mem :
包括:
●Total
●Free
●Used
●Buff/Cache
适合实时观察进程内存变化。
8. pmap —— 查看进程地址空间
查看某个进程:
pmap -x
示例:
AddressKbytes RSS Dirty Mode Mapping
可以看到:
●Heap
●Stack
●mmap 区域
●Shared Library
●Anonymous Memory
适用于分析:
●mmap 文件映射
●Java Heap
●数据库 Buffer Pool
●Huge Page 使用情况
类似的可以
cat /proc/#pid/maps

9. perf —— 分析 Page Fault 与火焰图
perf 不仅可以分析 CPU,还可以统计内存事件。
统计 Page Fault:
perf stat -e page-faults ./app
实时采样:
perf record -e page-faults -g ./app
生成调用栈:
perf script
结合 FlameGraph:
perf script | stackcollapse-perf.pl | flamegraph.pl > pagefault.svg
通过火焰图,可以快速定位:
●哪些函数频繁触发 Minor Page Fault
●哪些代码导致 Major Page Fault
●是否存在异常的内存访问模式
对于数据库、JVM、大型 C/C++ 应用来说,这是定位 Page Fault 热点的重要方法。

10. drsnoop(BCC)—— 观察 Direct Reclaim
当系统内存不足时,进程可能会进入 Direct Reclaim,直接参与内存回收,阻塞用户进程,这通常意味着更高的请求延迟。
drsnoop 是 BCC(eBPF)工具集中的一个工具,用于实时跟踪 Direct Reclaim 事件。
运行:
sudo drsnoop
典型输出:
TIMEPID COMMLAT(ms)
12:01:03 4321 mysqld15.8
12:01:04 8765 java48.2
可观察的信息包括:
●发生 Direct Reclaim 的进程
●回收耗时
●回收频率
如果大量请求都进入 Direct Reclaim,通常说明:
●系统内存压力过大
●Page Cache 回收过于频繁
●内存配置不足
●容器 Memory Limit 设置过小
相比传统工具,drsnoop 能够直接观察内核内存回收路径,是排查高延迟和内存抖动的利器。
总结
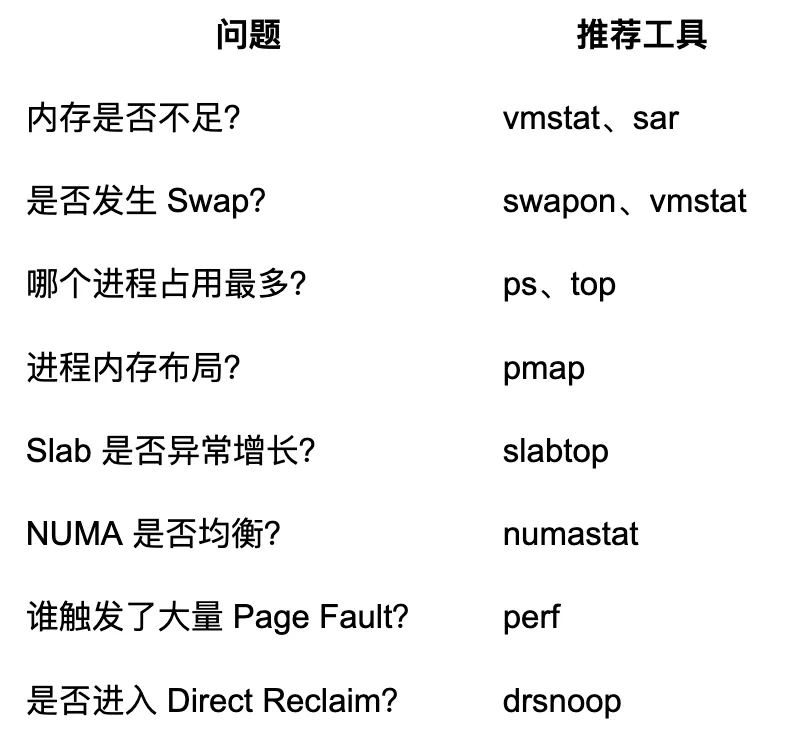
Linux 内存问题通常需要多个工具配合分析:
对于大多数线上故障,可以遵循一个简单的排查流程:
vmstat / sar → ps / top → pmap → slabtop → numastat → perf → drsnoop
从系统整体到具体进程,再深入内核事件,逐步缩小问题范围,通常能够快速定位绝大多数 Linux 内存性能问题。
 10个月宝宝每天需要喝多少奶粉?