打破“做 AI 必须用 Python”的思维定式。对于绝大多数 .NET 技术栈的企业和开发者来说,AI 落地的最大障碍从来不是算法不够先进,而是工程化成本太高:搭建 Python 推理服务、跨语言联调适配、环境依赖治理、双栈运维排障……大量精力消耗在技术栈的缝补上,真正投入业务价值的部分反而被稀释。
ML.NET 给出了另一条路径:让 AI 能力原生融入 .NET 生态,无需额外运行时、无需跨服务调用、无需维护两套技术栈,在现有系统里就能低成本嵌入智能能力。本文从生产落地视角,完整拆解 ML.NET 的架构设计、核心技术、工程实践与避坑指南,帮你走出一条不用 Python 的 .NET AI 落地之路。
一、重新认识 ML.NET:它不是 Python 的替代品,是 .NET 的落地方案
很多人对 ML.NET 的认知存在偏差:要么觉得它是“玩具级框架”,功能比不上 Python 生态;要么强行要求它用纯 C# 完成从训练到部署的全流程,最后因为算法丰富度不足而放弃。
本质上,ML.NET 的核心定位从来不是“用 C# 做算法研究”,而是“用 C# 把 AI 部署到生产环境”。它不与 Python 生态对立,反而可以完美互补:算法团队用 Python 做模型训练与迭代,工程团队用 ML.NET 做生产级部署与业务集成,两边各司其职,通过 ONNX 标准格式无缝衔接。
传统 Python 跨服务方案的五大痛点
在 ML.NET 普及之前,.NET 系统接入 AI 能力的主流方式是单独部署 Python 推理服务,通过 HTTP/gRPC 跨服务调用。这种模式在复杂场景下会暴露出诸多工程化问题:
| | |
|---|
| | |
| | |
| Python 运行时、依赖库、Web 框架,环境配置复杂 | |
| .NET + Python 双栈维护,团队协作成本高 | |
| | |
| | |
| | |
对于工业控制、企业内部系统、边缘设备这类场景,ML.NET 原生方案的工程化优势非常明显:它把 AI 从一个“需要专门团队维护的独立服务”,变成了“和普通业务代码一样的常规功能模块”。
二、.NET 原生 AI 的标准架构设计
生产级的 ML.NET 应用不能是“加载模型、调用 Predict”的 Demo 式写法,必须遵循分层解耦的架构原则,和现有 .NET 系统深度融合,同时保证可扩展、可维护、可观测。
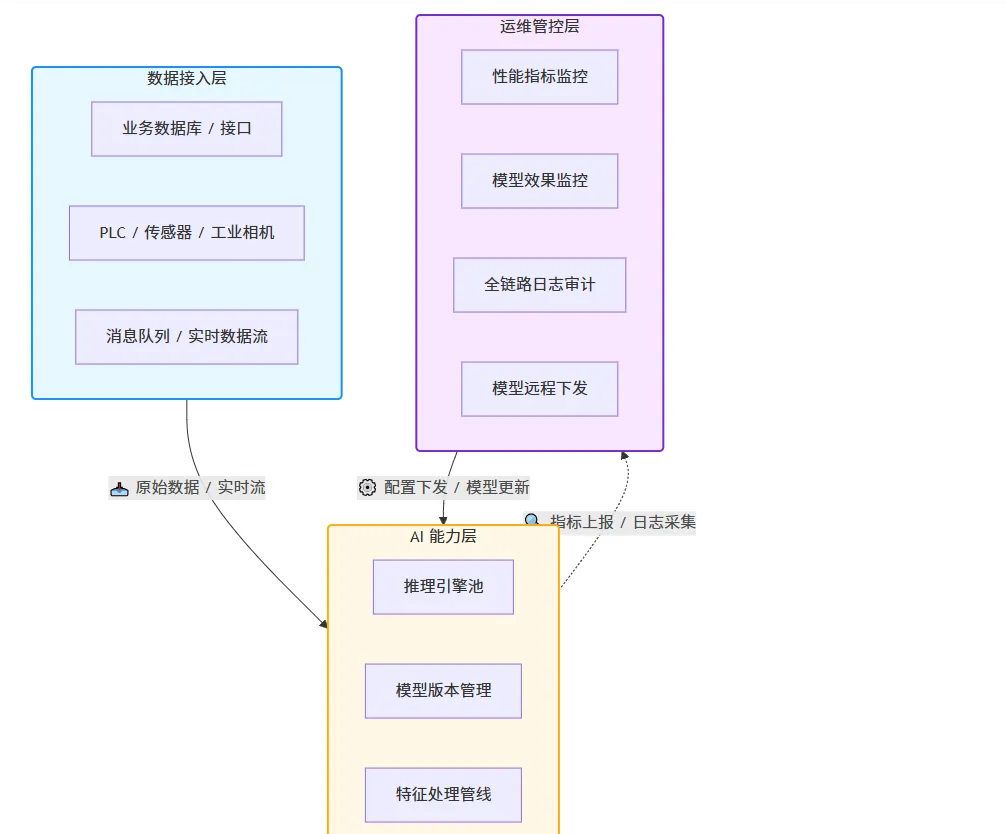
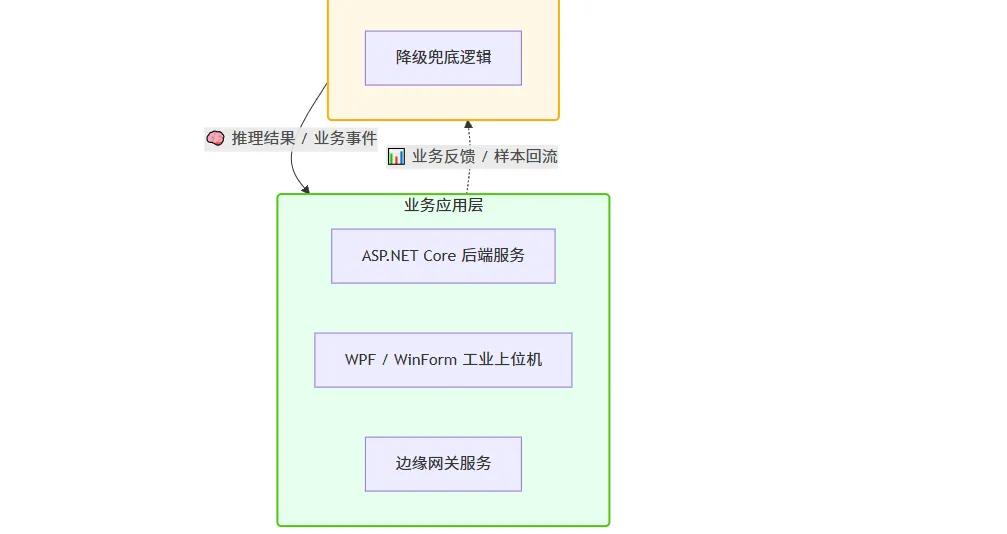
整体分层架构
各层核心职责:
- 数据接入层:负责原始数据的读取与标准化,对接业务系统、工业设备、数据流,屏蔽数据源差异。
- AI 能力层:系统核心,负责模型加载、特征转换、推理执行、结果输出,同时内置版本管理与降级逻辑。
- 业务应用层:AI 能力的出口,将推理结果转化为业务动作,比如告警、控制、推荐、预警等。
- 运维管控层:保障系统稳定运行,覆盖性能监控、效果监控、日志审计、模型更新全生命周期。
两种主流部署形态
根据业务场景不同,ML.NET 有两种成熟的部署模式,分别对应不同的需求:
1. 内嵌式部署
将推理引擎直接嵌入业务进程,和主程序运行在同一个进程内,是工业上位机、桌面客户端、边缘网关的首选方案。
- 核心优势:延迟最低、可靠性最高、断网完全可用、部署最简单。
- 技术要点:采用线程绑定的推理实例,做好资源隔离,避免 AI 计算抢占主线程资源。
2. 服务化部署
基于 ASP.NET Core 封装成独立的 AI 推理服务,通过接口供多个业务系统调用,适合企业内部多系统共享 AI 能力的场景。
- 核心优势
- 技术要点:采用对象池管理推理实例,配合服务注册与发现机制,支持水平扩展。
三、核心落地技术:从模型到生产的完整链路
3.1 模型来源:Python 训练,.NET 推理,ONNX 是桥梁
不用 Python 不代表完全排斥 Python 生态。工业界最成熟、性价比最高的方案,是训练与部署解耦:
- 算法团队使用熟悉的 PyTorch、TensorFlow、LightGBM、YOLO 等框架训练模型,保证算法效果;
- .NET 侧通过 ML.NET + ONNX Runtime 加载模型,执行推理。
这种模式下,两边都用自己最擅长的技术栈,没有强制绑定,协作成本最低。对于简单的表格分类、回归、异常检测场景,也可以直接使用 ML.NET 内置的训练器,实现全链路 C# 开发,进一步降低维护成本。
3.2 推理引擎封装:解决线程安全与性能问题
PredictionEngine 是 ML.NET 最常用的推理接口,但它不是线程安全的,单例多线程调用会导致原生层内存访问冲突,甚至进程崩溃。生产环境必须根据并发模式选择对应的封装方案。
ASP.NET Core 服务场景:对象池方案
使用官方提供的 PredictionEnginePool,通过依赖注入注册,自动管理实例的创建与复用,适配 Web 服务的随机并发请求。
// 服务注册builder.Services.AddPredictionEnginePool<QualityInput, QualityResult>() .FromFile(modelName: "default", filePath: "models/quality_model.onnx") .CacheSize(Environment.ProcessorCount * 2);// 业务代码直接注入使用public class QualityService{ private readonly PredictionEnginePool<QualityInput, QualityResult> _pool; publicQualityService(PredictionEnginePool<QualityInput, QualityResult> pool) { _pool = pool; } public QualityResult Predict(QualityInput input) { return _pool.Predict("default", input); }}
工业上位机场景:线程绑定方案
上位机通常是固定线程的流水线架构(采集→处理→控制),使用 ThreadLocal 为每个线程分配独立的推理实例,完全无锁竞争,延迟最低最稳定。
public class AnomalyDetector : IDisposable{ private readonly MLContext _mlContext; private readonly ITransformer _model; private readonly ThreadLocal<PredictionEngine<SensorInput, AnomalyResult>> _threadEngine; publicAnomalyDetector(string modelPath) { _mlContext = new MLContext(); _model = _mlContext.Model.Load(modelPath, out _); _threadEngine = new ThreadLocal<PredictionEngine<SensorInput, AnomalyResult>>( () => _mlContext.Model.CreatePredictionEngine<SensorInput, AnomalyResult>(_model)); } public AnomalyResult Predict(SensorInput input) { return _threadEngine.Value.Predict(input); } publicvoidDispose() { _threadEngine.Dispose(); _model.Dispose(); }}
3.3 特征一致性:守住准确率的生命线
离线测试 95% 准确率,上线只剩 70%,十有八九是特征处理口径不一致导致的。训练端和推理端的归一化参数、缺失值填充方式、特征顺序、编码规则,任何一点差异都会导致结果偏差。
生产级落地必须遵循一个核心原则:预处理逻辑只写一次。
- 最佳实践:训练时将特征转换逻辑与模型一起序列化保存,推理端直接加载完整管线,输入原始数据即可自动完成所有预处理,从根源上保证口径一致。
- 上线校验:发布前必须做双端一致性校验,用同一批测试样本分别在训练端和推理端运行,输出误差小于阈值才算通过。
3.4 模型生命周期管理:不停机更新,秒级回滚
模型迭代是常态,生产系统不能每次更新都重启服务。完整的热更新机制需要满足:加载过程不影响业务、切换瞬间原子性、出现问题可快速回滚。
核心实现思路是双实例 + 读写锁原子切换:后台完整加载新模型并校验通过后,原子替换全局引用,旧实例延迟释放,等待存量请求处理完毕。
public class HotUpdateModelManager<TInput, TOutput> : IDisposable where TInput : class where TOutput : class, new(){ private readonly ReaderWriterLockSlim _rwLock = new(); private PredictionEnginePool<TInput, TOutput> _currentPool; public string CurrentVersion { get; private set; } public bool UpdateModel(string newModelPath, string newVersion) { // 后台加载新模型 var newPool = CreatePool(newModelPath); // 基准样本校验,确保模型可用 if (!ValidateBenchmark(newPool)) return false; // 原子切换引用 _rwLock.EnterWriteLock(); try { var oldPool = _currentPool; _currentPool = newPool; CurrentVersion = newVersion; // 延迟释放旧实例 _ = Task.Delay(TimeSpan.FromSeconds(10)) .ContinueWith(_ => oldPool.Dispose()); } finally { _rwLock.ExitWriteLock(); } return true; }}
同时建立多版本留存机制,保留最近 3 个稳定版本,新版本出现异常时可一键回滚到上一个版本,秒级恢复服务。
四、企业级四大典型落地场景
ML.NET 的价值不在于技术本身,而在于能低成本解决真实业务问题。以下四个场景是 .NET 生态中最成熟、投入产出比最高的 AI 落地方向。
1. 工业制造:预测性维护与工艺优化
在现有工控上位机中内嵌 ML.NET 模块,实时采集设备的温度、振动、电流等传感器数据,通过异常检测与故障分类模型,提前识别设备早期故障,触发分级预警,将事后维修变为事前维护。同时基于历史生产数据训练工艺优化模型,根据来料、环境参数自动推荐最优工艺参数,降低对资深工程师的经验依赖。
2. 机器视觉:边缘端缺陷检测
普通工控机 + 工业相机,配合 ML.NET 加载轻量化 YOLO、MobileNet 模型,即可实现产品外观缺陷检测。所有推理在本地完成,检测结果直接输出给 PLC 执行剔除动作,无需上传云端,延迟低、可靠性高。整体成本远低于专用视觉控制器,且可与上位机业务逻辑深度集成,定制化能力更强。
3. 企业管理:风控与运营智能
直接内嵌到 ERP、CRM、WMS 等 .NET 业务系统中,实现交易反欺诈、客户流失预警、商品需求预测、库存智能调拨等功能。数据全程不离开业务系统,无需额外做数据同步与接口对接,既满足数据安全合规要求,又能快速将 AI 能力融入业务流程。
4. 边缘计算:分布式端侧智能
在分布式的边缘网关、终端设备上部署 ML.NET 推理服务,本地完成数据处理与智能决策,只把关键结果和异常数据回传中心。即使网络中断,端侧功能也完全不受影响,非常适合户外站点、分布式产线、无人值守设备等场景。
五、生产级工程化加固
能跑通 Demo 只是第一步,要支撑 7×24 小时稳定运行,必须在性能、可用性、可观测性上做完整的工程化加固。
5.1 性能优化:把 CPU 算力榨干
- 模型量化:优先使用 INT8 量化的 ONNX 模型,体积减少 75%,推理速度提升 2~4 倍,精度损失通常在 1% 以内,工业场景完全可接受。
- 内存池化:输入数组、张量缓冲区使用对象池复用,避免高频分配大对象导致 LOH 碎片化,运行时实现零 GC 卡顿。
- 参数调优:根据 CPU 物理核心数设置 ONNX Runtime 的线程数,避免超线程带来的上下文切换开销。
- 批量推理:高吞吐场景采用微批量推理,攒够一定数量的请求后一次执行,显著提升单位时间处理量。
5.2 高可用设计:AI 可以不准,不能拖垮业务
工业和企业级场景下,AI 永远是业务增强项,不是强依赖。任何时候都不能因为 AI 模块故障导致核心业务中断。
- 输入防御:所有输入数据先做量程校验、格式校验,脏数据直接拦截,不进入推理引擎。
- 异常兜底:所有推理调用外层包裹异常捕获,内部消化错误,记录日志,返回兜底结果,绝不把异常抛给业务层。
- 多级降级:设计 AI 推理→规则引擎→人工处理的三级降级路径,AI 故障时自动切回传统规则,保证业务始终可用。
- 超时控制:给推理加上超时机制,避免底层异常导致线程永久挂死,影响主流程。
5.3 可观测性:让黑盒变透明
缺少监控的 AI 服务就是黑盒,出了问题无从排查。必须建立三层监控体系:
- 性能层:监控 QPS、平均延迟、P99 延迟、错误率、CPU/内存占用,保障服务运行状态。
- 效果层:统计输出结果分布、正负样本比例,计算 PSI 群体稳定性指数,及时发现模型漂移。
- 业务层:关联业务指标,比如不良率、预警准确率、人工复核率,量化 AI 的实际业务价值。
同时建立全链路追溯机制,每次推理生成唯一 TraceId,记录输入摘要、输出结果、模型版本、耗时,异常样本自动留存原始数据,支持事后复盘与模型迭代。
5.4 数据闭环:让模型越跑越准
模型上线不是终点,而是迭代的起点。建立“生产运行→样本回流→增量训练→版本更新”的闭环机制:
- 自动采集误检、漏检、边界样本,结合人工标注结果加入训练集;
随着运行时间增长,模型会越来越贴合现场实际情况,效果持续提升。
六、避坑指南:最容易踩的 8 个生产级坑
1. 并发崩溃坑
现象:低并发正常,压力上来后偶发进程崩溃。 根因:单例推理实例被多线程同时调用,触发原生层内存冲突。 方案:使用对象池或线程绑定方案,严格禁止跨线程共享单个推理实例。
2. 准确率跳水坑
现象:离线测试效果很好,上线后准确率大幅下降。 根因:训练端和推理端特征处理口径不一致。 方案:序列化完整特征处理管线,上线前做双端一致性校验。
3. 内存泄漏坑
现象:运行时间越长内存越高,GC 也无法回收。 根因:频繁创建销毁推理实例导致原生内存泄漏,大对象频繁分配导致 LOH 碎片化。 方案:全局复用推理实例,输入缓冲区池化复用,低峰期主动压缩大对象堆。
4. 部署失败坑
现象:开发机运行正常,部署到老工控机或服务器上直接报错。 根因:CPU 不支持 AVX 指令集,或缺少原生运行库。 方案:启动时做指令集检测,自动降级到兼容模式;发布时采用自包含部署,携带所有依赖。
5. 热更新异常坑
现象:模型更新时偶发推理异常。 根因:非原子切换,请求拿到了半加载的模型实例。 方案:双实例预加载 + 读写锁原子切换,确保切换过程中所有请求都拿到完整可用的实例。
6. 业务中断坑
现象:AI 模块出问题导致整个业务系统不可用。 根因:把 AI 当成强依赖,没有降级兜底设计。 方案:AI 功能默认旁路,异常时自动降级为规则引擎,绝不影响主业务流程。
7. 效果衰减坑
现象:上线时效果很好,几个月后越来越不准。 根因:设备磨损、原料变化、季节更替导致数据分布漂移。 方案:建立分布监控与漂移告警机制,定期用新数据增量更新模型。
8. 排查困难坑
现象:出了问题不知道是数据错、模型错还是业务逻辑错。 根因:缺少日志埋点与全链路追溯能力。 方案:每次推理留痕,关键指标可监控,异常样本可回溯。
七、选型思考:什么时候该走 .NET 原生 AI 路线
技术没有好坏,只有适合不适合。ML.NET 不是万能药,它有自己的最佳适用场景。
非常适合的场景
- 团队主力技术栈是 .NET,不想额外引入 Python 技术栈增加运维与协作成本;
- 数据敏感度高,要求数据不出内网、不出进程,合规要求严格;
- 边缘部署场景,设备资源有限,环境复杂,需要断网自治能力;
- AI 是业务系统的增强功能,不是核心产品,追求低成本快速落地。
不建议的场景
- 超大规模模型训练、前沿算法研究,Python 生态依然是最优选择;
- 超大规模分布式推理集群,有专门的算法工程团队维护;
- 极度依赖 Python 生态独有算法,且无法导出为 ONNX 格式。
写在最后
.NET AI 的核心价值,从来不是“替代 Python”,而是给 .NET 生态一条更低成本、更高可靠的 AI 落地路径。它不需要你重新学习一门语言、不需要搭建一套新的基础设施、不需要组建一支新的技术团队,就能把 AI 能力融入现有的业务系统,实实在在解决问题。
对于广大 .NET 开发者来说,AI 从来不是遥不可及的前沿概念,也不是 Python 开发者的专属技能。用好 ML.NET,你完全可以在熟悉的技术栈里,把 AI 变成日常开发的常规工具,让数据产生价值。这,就是不用 Python 的 .NET AI 之路最核心的意义。
 10个月宝宝每天需要喝多少奶粉?