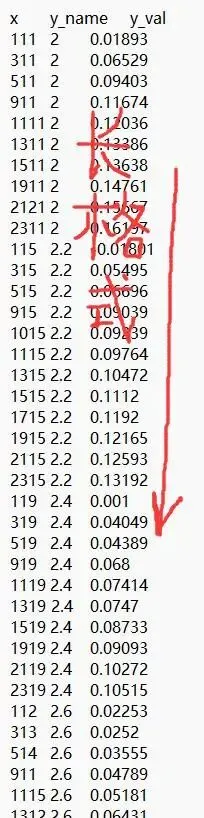
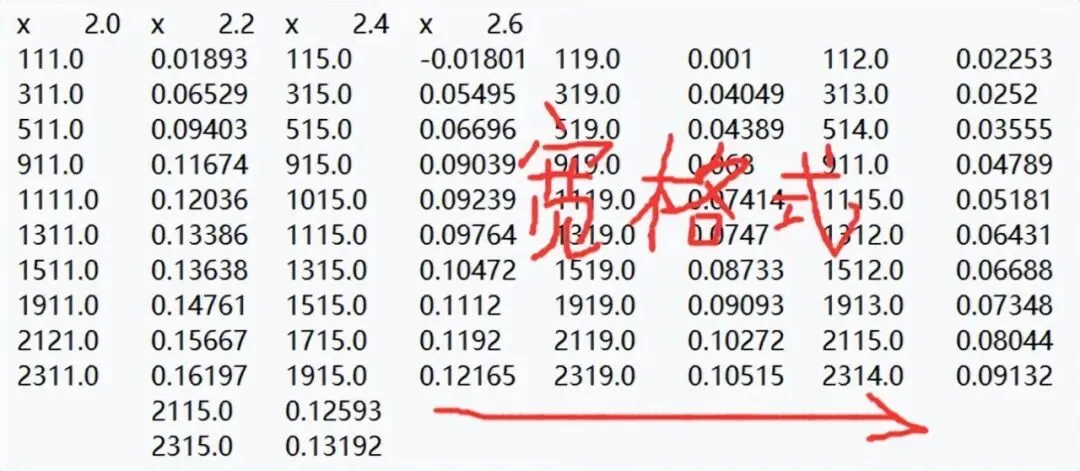
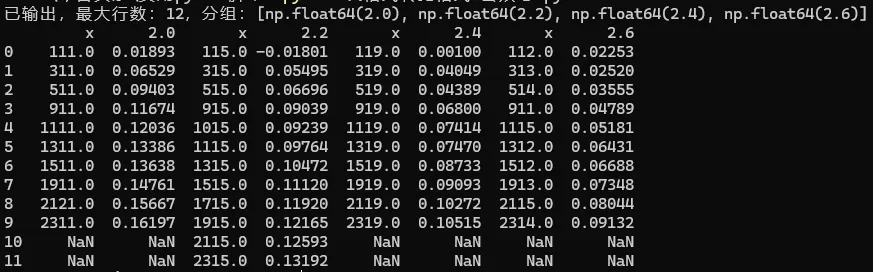
import pandas as pdimport numpy as np# ========== 配置区 ==========input_txt = "long_in.txt" # 输入长格式txt文件名output_txt = "wide_out.txt" # 输出宽格式txt文件名 sep_in = r"\s+" # 输入文件空格分隔,自动匹配多空格sep_out = "\t" # 输出用制表分隔,可读性更强# ==========================# 读取长格式三列表格:x, y_name, y_val# 1、如果输入文件有表头时,读取以下代码:df_long = pd.read_csv(input_txt, sep=sep_in)# 2、如果输入文件无表头时,读取以下代码:# df_long = pd.read_csv(input_txt, sep=sep_in, names=["x", "y_name", "y_val"])# 按数值排序分组标签group_names = sorted(df_long["y_name"].unique(), key=lambda s: float(s))group_subtables = []max_rows = 0# 拆分每组 [x, y_val]for g in group_names: sub = df_long[df_long["y_name"] == g][["x", "y_val"]].reset_index(drop=True) group_subtables.append(sub) if len(sub) > max_rows: max_rows = len(sub)# 统一填充到最大行数,不足行补NaNpadded_groups = []for sub in group_subtables: n_pad = max_rows - len(sub) pad_df = pd.DataFrame(np.full((n_pad, 2), np.nan), columns=["x", "y_val"]) full_sub = pd.concat([sub, pad_df], ignore_index=True) padded_groups.append(full_sub)# 横向拼接全部分组df_wide = pd.concat(padded_groups, axis=1)# 重命名表头:x,2,x,2.2,x,2.4...new_cols = []for g in group_names: new_cols.extend([x, str(g)]) df_wide.columns = new_cols# 导出df_wide.to_csv(output_txt, sep=sep_out, index=False)print(f"已输出,最大行数:{max_rows},分组:{group_names}")print(df_wide.head(15))
 10个月宝宝每天需要喝多少奶粉?