从 0 到 1 搭建 RAG 系统:Python + LangChain + ChromaDB 实战
- 2026-10-11 06:58:23
你好,我是江小湖。前四篇我们讲了 LLM 记不住、会编造、不懂你的业务?RAG 一次解决这三个问题、你的 RAG 为什么检索不准?八成是文档切分和 Embedding 没做好、RAG 的检索质量怎么保障?语义检索 + 关键词匹配 + Reranker 三管齐下 和 RAG 效果好不好,不能靠感觉——量化评测 + 系统优化全指南。这一篇,我们动手写代码,从零搭建一个能用的 RAG 系统。
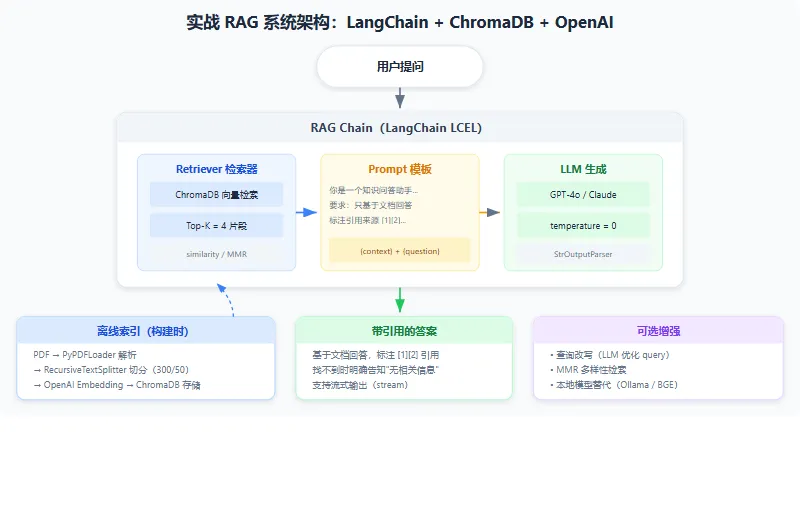
读完本文,你将拥有一个可以回答"基于你的私有文档"问题的 AI 助手,并且理解每一步在做什么。
开始之前,你需要准备:
| 准备项 | 说明 |
|---|---|
| Python 3.9+ | 推荐 3.11 或更新版本 |
| OpenAI API Key | 用于 Embedding 和 LLM 调用。如果不想付费,可以用本地模型替代(后文会提到) |
| 一个 PDF 文档 | 用于测试。可以是公司手册、产品文档、或任何你感兴趣的 PDF |
如果你还没有 OpenAI API Key:
# Windows PowerShell
$env:OPENAI_API_KEY="sk-你的密钥"

# Linux/Mac
export OPENAI_API_KEY="sk-你的密钥"
最终的项目结构如下:
my-rag/
├── data/
│   └── your_document.pdf    # 你的测试文档
├── rag.py                   # 主程序
└── requirements.txt         # 依赖
创建 requirements.txt:
langchain>=0.2
langchain-openai>=0.1
langchain-community>=0.2
chromadb>=0.5
pypdf>=4.0
安装:
pipinstall-rrequirements.txt
各库的作用:
| 库 | 作用 |
|---|---|
| langchain | RAG 流程编排框架 |
| langchain-openai | OpenAI Embedding 和 Chat 模型的封装 |
| langchain-community | 向量数据库(ChromaDB)和文档加载器(PyPDF)的集成 |
| chromadb | 向量数据库,负责存储和检索向量 |
| pypdf | PDF 文档解析 |
将 PDF 文档加载为 LangChain 的 Document 对象:
from langchain_community.document_loaders import PyPDFLoader

# 加载 PDF
loader = PyPDFLoader("data/your_document.pdf")
documents = loader.load()

print(f"加载了 {len(documents)} 页")
print(f"第一页内容预览:{documents[0].page_content[:200]}")
每个 Document 对象包含两个字段:
page_content:页面的文本内容metadata:元数据(如页码、文件名)# 查看元数据 print(documents[0].metadata) # {'source': 'data/your_document.pdf', 'page': 0}
如果要加载整个文件夹:
from langchain_community.document_loaders import DirectoryLoader, PyPDFLoader

loader = DirectoryLoader(
    "data/",
    glob="**/*.pdf",
    loader_cls=PyPDFLoader,
)
documents = loader.load()
print(f"共加载 {len(documents)} 页")
除了 PDF,LangChain 还支持多种文档格式:
| 格式 | 加载器 |
|---|---|
PyPDFLoader |
|
| Word (.docx) | Docx2txtLoader |
| HTML | BSHTMLLoader |
| Markdown | UnstructuredMarkdownLoader |
| 纯文本 | TextLoader |
文档需要切成小块(chunk),否则向量化和检索的效果会很差。
from langchain.text_splitter import RecursiveCharacterTextSplitter

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=300,      # 每个片段约 300 字符
    chunk_overlap=50,    # 相邻片段重叠 50 字符
    separators=["\n\n", "\n", "。", "!", "?", ",", " "],  # 中文分隔符
)

chunks = text_splitter.split_documents(documents)
print(f"切分后共 {len(chunks)} 个片段")
print(f"片段示例:{chunks[0].page_content[:100]}")
关键参数说明:
chunk_size:控制片段大小。太小会丢失上下文,太大会引入噪音。建议从 300 开始调优chunk_overlap:相邻片段的重叠部分。避免把一句话切断,通常设为 chunk_size 的 10%-20%separators:按优先级尝试的分隔符列表。中文文档建议加上中文标点# 打印前 3 个片段,检查切分效果 for i, chunk in enumerate(chunks[:3]): print(f"\n--- 片段 {i+1} ---") print(chunk.page_content)
如果发现切分效果不好(比如一句话被切断),可以增大 chunk_size 或调整 separators。
用 OpenAI 的 Embedding 模型将文本片段转为向量,存入 ChromaDB:
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import Chroma

# 初始化 Embedding 模型
embedding_model = OpenAIEmbeddings(model="text-embedding-3-small")

# 将文档片段向量化并存入 ChromaDB
vectorstore = Chroma.from_documents(
    documents=chunks,
    embedding=embedding_model,
    persist_directory="./chroma_db",  # 持久化目录
)

print(f"已存入 {vectorstore._collection.count()} 个向量")
persist_directory 让 ChromaDB 将向量保存到磁盘,下次运行时可以直接加载,不需要重新向量化。
# 下次运行时,直接加载
vectorstore = Chroma(
    persist_directory="./chroma_db",
    embedding_function=embedding_model,
)
基于用户问题,在向量数据库中检索最相关的文档片段:
# 创建检索器
retriever = vectorstore.as_retriever(
    search_type="similarity",  # 相似度检索
    search_kwargs={"k": 4},    # 返回 Top-4
)

# 测试检索
query = "这个文档的主要内容是什么?"
docs = retriever.invoke(query)

print(f"检索到 {len(docs)} 个相关片段:")
for i, doc in enumerate(docs):
    print(f"\n--- 片段 {i+1} (页码: {doc.metadata.get('page', 'N/A')}) ---")
    print(doc.page_content[:200])
检索参数调优:
k:返回的片段数量。太少可能漏掉信息,太多会引入噪音。通常 3-6 效果最好search_type:similarity(默认)、mmr(最大边际相关性,多样性更好)retriever = vectorstore.as_retriever( search_type="mmr", search_kwargs={"k": 4, "fetch_k": 20}, # 先取 20 个,再选 4 个最多样化的 )
将检索结果和用户问题组合成 Prompt,交给 LLM 生成答案:
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

# 初始化 LLM
llm = ChatOpenAI(model="gpt-4o", temperature=0)

# 定义 Prompt 模板
prompt_template = ChatPromptTemplate.from_template("""
你是一个知识问答助手。请基于以下参考资料回答用户的问题。

要求:
1. 只基于参考资料回答,不要编造信息
2. 如果参考资料中没有相关信息,明确告知"找不到相关信息"
3. 在回答中标注引用来源(如 [1]、[2])

---
参考资料:
{context}
---

用户问题:{question}
""")

# 格式化检索结果
defformat_docs(docs):
    formatted = []
    for i, doc in enumerate(docs):
        source = doc.metadata.get("source", "未知来源")
        page = doc.metadata.get("page", "N/A")
        formatted.append(f"[{i+1}] (来源: {source}, 第{page}页)\n{doc.page_content}")
    return "\n\n".join(formatted)

# 组装 RAG Chain(使用 LCEL 语法)
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

rag_chain = (
    {
        "context": retriever | format_docs,
        "question": RunnablePassthrough(),
    }
    | prompt_template
    | llm
    | StrOutputParser()
)

# 提问
answer = rag_chain.invoke("这个文档的主要内容是什么?")
print(answer)
如果你觉得 LCEL 语法不直观,可以用传统写法:
defask(question):
    # 1. 检索
    docs = retriever.invoke(question)

    # 2. 构造 Prompt
    context = format_docs(docs)
    prompt = prompt_template.format(context=context, question=question)

    # 3. 生成
    answer = llm.invoke(prompt)
    return answer.content

# 测试
print(ask("这个文档的主要内容是什么?"))
两种写法效果完全一样,选你觉得清晰的就行。
将以上步骤整合为一个完整的 rag.py:
"""RAG 系统 - 基于 PDF 文档的知识问答"""

from langchain_community.document_loaders import PyPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

# --- 配置 ---
DATA_PATH = "data/your_document.pdf"
DB_PATH = "./chroma_db"
EMBEDDING_MODEL = "text-embedding-3-small"
LLM_MODEL = "gpt-4o"
CHUNK_SIZE = 300
CHUNK_OVERLAP = 50
TOP_K = 4


defload_documents(path):
"""加载 PDF 文档"""
    loader = PyPDFLoader(path)
    docs = loader.load()
    print(f"✓ 加载了 {len(docs)} 页")
    return docs


defsplit_documents(docs):
"""切分文档"""
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=CHUNK_SIZE,
        chunk_overlap=CHUNK_OVERLAP,
        separators=["\n\n", "\n", "。", "!", "?", ",", " "],
    )
    chunks = splitter.split_documents(docs)
    print(f"✓ 切分为 {len(chunks)} 个片段")
    return chunks


defbuild_vectorstore(chunks):
"""向量化并存入 ChromaDB"""
    embeddings = OpenAIEmbeddings(model=EMBEDDING_MODEL)
    vectorstore = Chroma.from_documents(
        documents=chunks,
        embedding=embeddings,
        persist_directory=DB_PATH,
    )
    print(f"✓ 已存入 {vectorstore._collection.count()} 个向量")
    return vectorstore


defcreate_rag_chain(vectorstore):
"""创建 RAG Chain"""
    retriever = vectorstore.as_retriever(
        search_type="similarity",
        search_kwargs={"k": TOP_K},
    )

    prompt = ChatPromptTemplate.from_template("""
你是一个知识问答助手。请基于以下参考资料回答用户的问题。

要求:
1. 只基于参考资料回答,不要编造信息
2. 如果参考资料中没有相关信息,明确告知"找不到相关信息"
3. 在回答中标注引用来源(如 [1]、[2])

---
参考资料:
{context}
---

用户问题:{question}
""")

    llm = ChatOpenAI(model=LLM_MODEL, temperature=0)

    defformat_docs(docs):
        formatted = []
        for i, doc in enumerate(docs):
            page = doc.metadata.get("page", "N/A")
            formatted.append(f"[{i+1}] (第{page}页)\n{doc.page_content}")
        return "\n\n".join(formatted)

    chain = (
        {
            "context": retriever | format_docs,
            "question": RunnablePassthrough(),
        }
        | prompt
        | llm
        | StrOutputParser()
    )

    return chain


defmain():
    # 1. 加载文档
    docs = load_documents(DATA_PATH)

    # 2. 切分文档
    chunks = split_documents(docs)

    # 3. 向量化并存储
    vectorstore = build_vectorstore(chunks)

    # 4. 创建 RAG Chain
    chain = create_rag_chain(vectorstore)

    # 5. 交互式问答
    print("\n" + "=" * 50)
    print("RAG 系统已就绪!输入问题开始对话,输入 q 退出。")
    print("=" * 50)

    while True:
        question = input("\n你:")
        if question.lower() in ("q", "quit", "exit"):
            break
        if not question.strip():
            continue

        answer = chain.invoke(question)
        print(f"\nAI:{answer}")


if __name__ == "__main__":
    main()
| 问题 | 原因 | 解决方案 |
|---|---|---|
| 答案不相关 | 检索结果不相关 | 增大 k;调整 chunk_size;尝试 MMR 检索 |
| 答案胡说八道 | 模型没有基于文档回答 | 检查 Prompt 是否明确要求"基于文档";降低 temperature |
| 答案太短/不完整 | 检索到的片段太少或太碎 | 增大 k;增大 chunk_size |
| 运行太慢 | 向量化或检索耗时 | 首次运行需向量化,后续加载 chroma_db 即可加速;考虑换更快的 Embedding 模型 |
| OpenAI 报错 | API Key 问题或网络问题 | 确认 Key 正确;国内需配置代理或使用兼容 API |
1. 查询改写
用户的问题有时表述模糊,可以用 LLM 改写后再检索:
rewriter_prompt = ChatPromptTemplate.from_template("""
请将以下用户问题改写为更适合搜索的形式,保持原意但表述更清晰。

用户问题:{question}
改写后的搜索查询:
""")

rewriter = rewriter_prompt | llm | StrOutputParser()

# 使用改写后的查询检索
defretrieve_with_rewrite(question):
    rewritten = rewriter.invoke(question)
    print(f"原始问题:{question}")
    print(f"改写后:{rewritten}")
    return retriever.invoke(rewritten)
2. 流式输出
对于长答案,可以使用流式输出让用户实时看到生成过程:
for chunk in rag_chain.stream("这个文档的主要内容是什么?"):
    print(chunk, end="", flush=True)
print()  # 换行
3. 返回来源
用户通常想知道答案来自文档的哪个位置:
defask_with_sources(question):
    docs = retriever.invoke(question)
    context = format_docs(docs)
    prompt = prompt_template.format(context=context, question=question)
    answer = llm.invoke(prompt)

    print(f"答案:{answer.content}")
    print(f"\n参考来源:")
    for i, doc in enumerate(docs):
        print(f"  [{i+1}] 第 {doc.metadata.get('page', 'N/A')} 页")
4. 使用免费/本地模型替代 OpenAI
如果不想付费,可以使用本地模型:
# 方案 1:使用 Ollama(需安装 Ollama)
from langchain_community.embeddings import OllamaEmbeddings
from langchain_community.llms import Ollama

embedding_model = OllamaEmbeddings(model="nomic-embed-text")
llm = Ollama(model="qwen2.5:7b")

# 方案 2:使用 Hugging Face 本地模型
from langchain_community.embeddings import HuggingFaceEmbeddings

embedding_model = HuggingFaceEmbeddings(model_name="BAAI/bge-small-zh-v1.5")
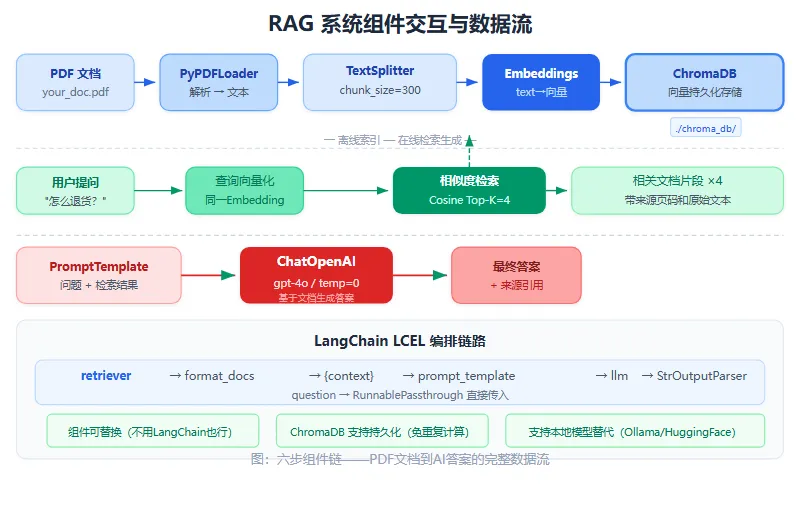
这一篇我们从零搭建了一个完整的 RAG 系统,走过了六个步骤:
这是一个最小可用的 RAG 系统。实际项目中,你可能还需要处理更多细节(如多格式文档、权限控制、并发处理等),但核心流程是一样的。
这是一个最小可用的 RAG 系统。实际项目中,你可能还需要处理更多细节(如多格式文档、权限控制、并发处理等),但核心流程是一样的。朴素 RAG 有一个天花板——跨文档的因果关系它推理不了。下一篇 GraphRAG:知识图谱增强检索 会突破这个天花板。
以上就是本文的全部内容。如果觉得有收获,欢迎点赞、在看、转发,这是对 江小湖 最大的鼓励。
如有疑问或建议,欢迎在评论区留言交流。
📖 近期文章
• RAG 效果好不好,不能靠感觉——量化评测 + 系统优化全指南
• RAG 的检索质量怎么保障?语义检索 + 关键词匹配 + Reranker 三管齐下
• 你的 RAG 为什么检索不准?八成是文档切分和 Embedding 没做好
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- Python 玩转 RabbitMQ:路由、主题一次讲清
- Rocky Linux 9 源码编译安装 PostgreSQL 16 完整步骤
- 第12课 Python 的运算符——身份运算符
- Python开发从零开始-50.21-Office 文档处理
- 【教程】最新基于Python科研数据可视化实践技术应用
- Python电竞数据分析:选手表现可视化实战案例
- Python Install Manager (PIM)安装管理器的安装与使用
- 3天搞定Python入门,小白也能轻松上手
- Linux操作系统管理与服务器配置 乔哲 高秀艳 陈辉 课后习题答案解析
- Python数据分析核心:Pandas常用方法完整梳理