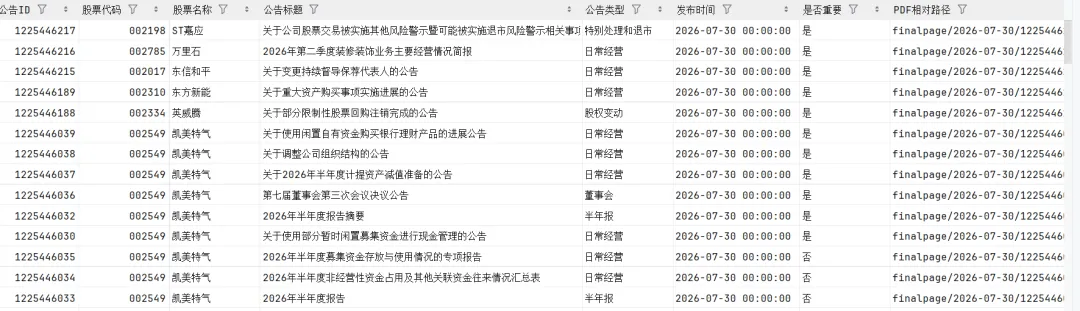
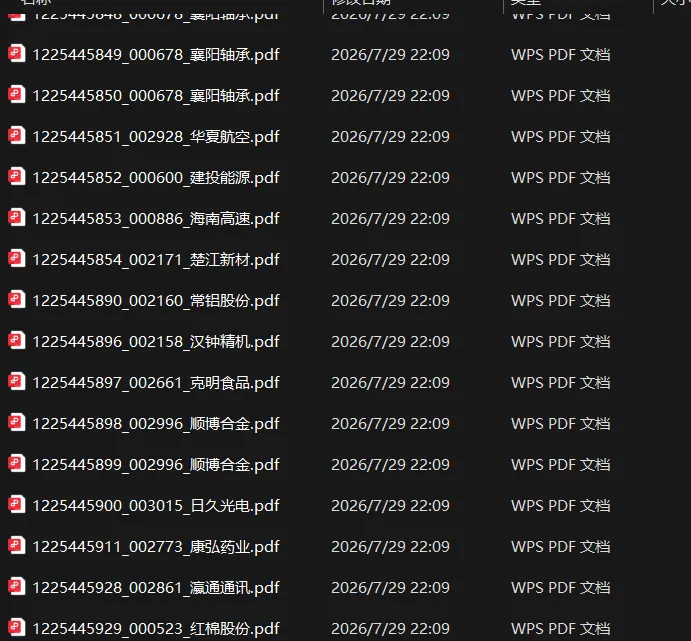
做Python爬虫和量化投研的朋友,对巨潮资讯(CNINFO)一定不陌生。作为证监会指定的上市公司信息披露平台,这里是A股最权威的公告数据源:财报、重组、减持、股权激励、问询函……几乎所有影响股价的信息,都必须在这里披露。公告列表是接口驱动(new/disclosure),不是静态 HTML公告文件是PDF,且下载需要 Referer 校验今天这篇,我基于DrissionPage监听公告接口,把公告ID、股票代码、公告标题、公告类型、发布时间、PDF下载地址等 11 个字段结构化落盘,并批量下载 PDF 到本地,自动去重。核心思路全讲,但PDF 下载失败重试、文件名校验、Referer 策略,我只给逻辑,不贴完整封装——毕竟能稳定跑一个月的投研脚本,和跑一次就炸的 Demo,完全是两个东西。
Python爬取巨潮资讯公告 · 核心逻辑拆解
技术栈:DrissionPage + listen.wait() + 毫秒时间戳 + requests PDF下载 + 本地文件去重
一、为什么巨潮资讯公告值得爬?
字段 | 投研价值 |
|---|
公告ID | 唯一标识,便于增量更新 |
股票代码 / 名称 | 标的精准定位 |
公告类型 | 事件分类(财报 / 重组 / 减持) |
发布时间 | 事件时间轴(毫秒级) |
PDF下载地址 | 原始监管文件 |
是否重要 | 监管层标记的重点公告 |
👉 一份 CSV + 本地 PDF,就是一套可回测的A股事件数据库。
二、监听接口:new/disclosure
dp.listen.start('new/disclosure')dp.get('https://www.cninfo.com.cn/new/commonUrl?url=disclosure/list/notice#szseMain')
巨潮资讯的公告数据全在 new/disclosure接口返回的是classifiedAnnouncements(双层数组)
三、毫秒时间戳转换(监管数据标配)
"announcementTime": 1785324598000
time.strftime( '%Y-%m-%d %H:%M:%S', time.localtime(ann.get('announcementTime', 0) / 1000))
四、PDF 下载:Referer 是关键
HEADERS = { "User-Agent": "Mozilla/5.0", "Referer": "https://www.cninfo.com.cn/"}
pdf_url = f"http://static.cninfo.com.cn/{adjunct_url}"r = requests.get(pdf_url, headers=HEADERS, timeout=20)
不判断 status_code 和文件大小 → 下载空文件
五、本地文件去重(投研脚本必备)
if not local_pdf_path.exists(): download_pdf(pdf_url, local_pdf_path)else: print(f"✅ PDF 已存在,跳过")
六、公告结构的双重循环(极易写错)
"classifiedAnnouncements": [ [ {...}, {...} ], // 第一批 [ {...}, {...} ] // 第二批]
for batch in announcements: for ann in batch: ...
七、我故意不展开的三处
PDF 下载失败重试机制:网络抖动、403 临时封禁的指数退避策略文件名校验与清洗:公告标题含非法字符、过长路径、同名文件冲突处理增量更新逻辑:基于 announcementId 或 announcementTime 的断点续爬
八、这套数据能干什么?
AI 投研:PDF 文本抽取 + NLP 事件识别
九、结尾软广
爬虫不难,难的是在巨潮资讯这种“监管级、高合规、强反爬”的平台上,稳定拿到结构化数据并批量下载 PDF。