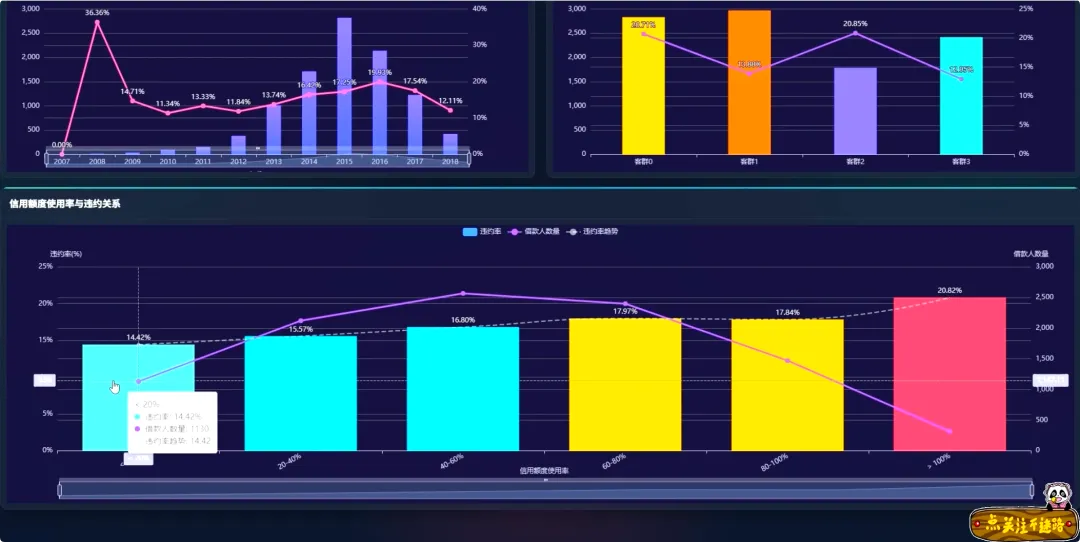
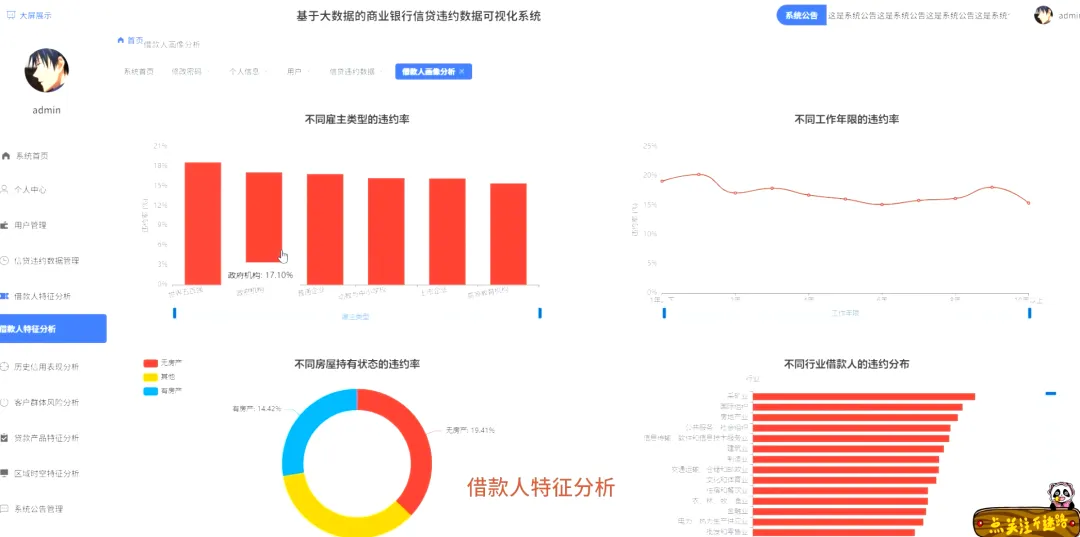
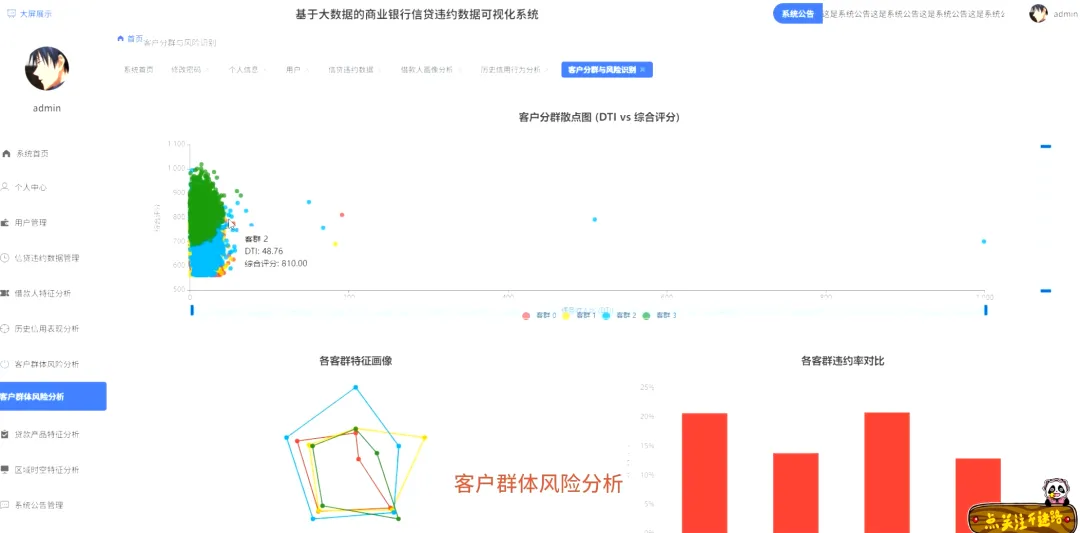
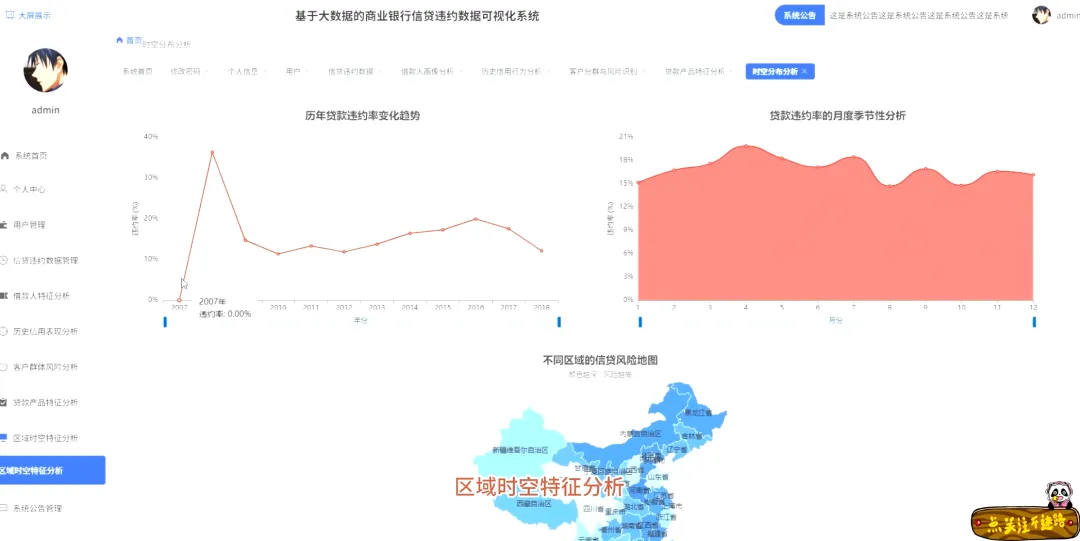
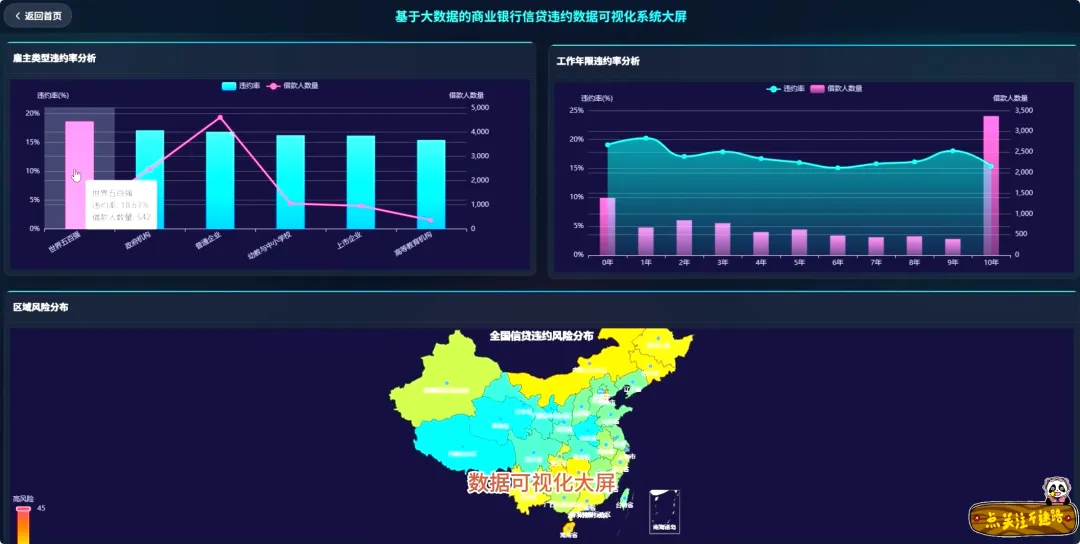
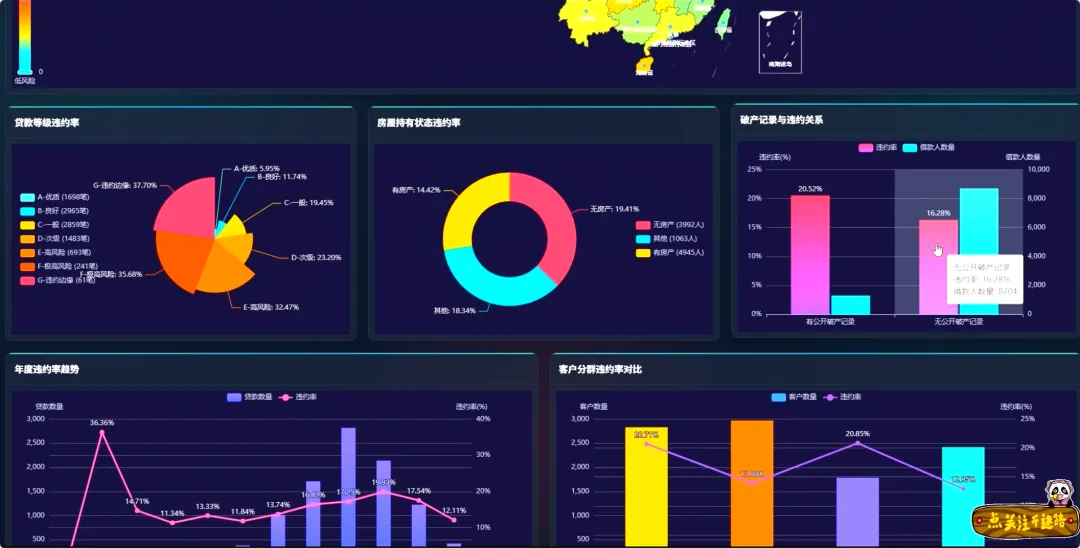
from pyspark.sql import SparkSessionfrom pyspark.sql.functions import col, count, sum, when, year, month, roundfrom pyspark.ml.feature import VectorAssemblerfrom pyspark.ml.clustering import KMeansspark = SparkSession.builder.appName("CreditRiskAnalysis").master("local[*]").getOrCreate()# 功能1: 不同雇主类型的违约率分析def analyze_employer_default_rate(df): df_grouped = df.groupBy("employer_type").agg( count("*").alias("total_count"), sum(col("isDefault")).alias("default_count") ) df_with_rate = df_grouped.withColumn("default_rate", round(col("default_count") / col("total_count") * 100, 2)) df_sorted = df_with_rate.orderBy(col("default_rate").desc()) result_list = [] for row in df_sorted.collect(): result_list.append({ "employer_type": row["employer_type"], "total_count": row["total_count"], "default_count": row["default_count"], "default_rate": row["default_rate"] }) return result_list# 功能2: 基于K-Means算法的客户聚类分群def perform_kmeans_clustering(df): feature_cols = ["total_loan", "interest", "debt_loan_ratio", "scoring_avg"] assembler = VectorAssembler(inputCols=feature_cols, outputCol="features") df_features = assembler.transform(df.na.drop(subset=feature_cols)) kmeans = KMeans(k=3, seed=42, featuresCol="features", predictionCol="cluster") model = kmeans.fit(df_features) predictions = model.transform(df_features) cluster_stats = predictions.groupBy("cluster").agg( count("*").alias("count"), sum(col("isDefault")).alias("defaults") ) cluster_stats = cluster_stats.withColumn("default_rate", round(col("defaults") / col("count") * 100, 2)) return cluster_stats.collect()# 功能3: 历年贷款违约率变化趋势分析def analyze_yearly_trend(df): df_with_year = df.withColumn("issue_year", year(col("issue_date"))) yearly_stats = df_with_year.groupBy("issue_year").agg( count("*").alias("total_loans"), sum(col("isDefault")).alias("defaults") ) yearly_stats = yearly_stats.withColumn("default_rate", round(col("defaults") / col("total_loans") * 100, 2)) yearly_stats = yearly_stats.orderBy("issue_year") trend_data = [] for row in yearly_stats.collect(): trend_data.append({ "year": row["issue_year"], "total_loans": row["total_loans"], "default_rate": row["default_rate"] }) return trend_data




 10个月宝宝每天需要喝多少奶粉?