用Codex+DeepSeek写Python脚本:从需求描述到可运行代码的全流程
- 2026-09-05 04:14:40
这周我终于把拖了超久的一件事给干了——用 Codex + DeepSeek 帮我写一段真正能跑的 Python 脚本。🤯
以前都是让它给我文字需求,这回要跑个流程:从提需求开始,到拿到代码、运行、报错、再修,完整走一遍。下面就是全过程,顺便附上我踩过的两个坑,给各位避避雷。
起因:我习惯于记账数据可没时间整理 📝
我有记账的习惯,但记得很糙——用的是手机备忘录,格式全靠手敲,大概长这样:
88月1日 早餐 12 午餐 408月2日 早餐 6 午餐 28 晚餐1288月3日 泡泡玛特 698月3日 早餐 12 午餐 408月5日 早餐 6 午餐 28 晚餐3008月5日 泡泡玛特 207
攒了快一个月,我想知道两件事:总共花了多少,以及每类花了多少。手动加肯定能加,但太累,而且我想顺便学学用 Python 处理数据。
我之前学过一点点类似的,但很多操作已经记不清了。与其再重新拾起来,不如直接让 DeepSeek 帮我写。💪
第一步:描述需求(第一版,翻车版)🚗💥
我跟 DeepSeek 是这么说的:
帮我写个Python脚本,分析我的记账数据,算一下总花费和每类花费。它给的回复其实不算差——给了一段用 pandas 的代码,大致逻辑是读 CSV、按类别 groupby 求和、打印结果。
但问题是:我的数据根本不是 CSV。我就是备忘录里一行行的纯文本,没有逗号分隔,没有表头。它默认我给的是规整的 CSV,我直接用肯定不行。
备注:AI 不会替你判断你的数据长什么样。它默认了一个"标准"场景,但我的场景一点都不标准。😅
第二步:把真实情况讲清楚(第二版)🎯
我重新组织了一下语言,这次把数据的真实样子贴进去了:
我有一份记账数据,存在一个txt文件里,每行格式是:日期 类别 金额 备注(备注可能没有)示例:8月1日 早餐 12 午餐 408月2日 早餐 6 午餐 28 晚餐1288月3日 泡泡玛特 69我想用Python写一个脚本,实现:1. 读取这个txt文件2. 算出总花费3. 按”类别”分组,算每类花了多少,从高到低排4. 把结果打印出来环境:Python 3.10,没装pandas(能不能只用标准库?)
这次说清楚了三件事:数据长什么样、我要什么结果、我的环境限制。
它的回复质量明显上来了。下面是我贴出来的它给的关键部分:
# parts[0]=日期 parts[1]=类别 parts[2]=金额 parts[3:]=备注(可选)if len(parts) < 3:print(f”这行格式不对,跳过:{line}”)continuecategory = parts[1]try:amount = float(parts[2])except ValueError:print(f”金额不是数字,跳过:{line}”)continuetotal += amountby_category[category] += amount# 按花费从高到低排序sorted_cats = sorted(by_category.items(), key=lambda x: x[1], reverse=True)print(f”总花费:{total:.2f} 元\n”)print(”分类明细(从高到低):”)for cat, amt in sorted_cats:print(f” {cat}:{amt:.2f} 元”)if __name__ == '__main__':analyze_expenses('expenses.txt')
它还顺手提醒我:"如果你的txt文件编码不是utf-8(比如Windows记事本默认存成gbk),读取时把 encoding 改成 gbk。"
这点提醒后来真的有用。
第三步:跑起来——然后报错了
我把代码存成 analyze.py,记账数据存成 expenses.txt,放同一个目录下,敲:
python analyze.py报错来得很快:
Traceback (most recent call last):File ”analyze.py”, line 30, inanalyze_expenses('expenses.txt')File ”analyze.py”, line 9, in analyze_expenseswith open(filepath, encoding='utf-8') as f:UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd4 in position 2...
果然是编码问题。我之前用 Windows 记事本存的这个 txt,默认就是 GBK。
第四步:把报错原样贴回去
这一步是整个流程里我觉得最值的一步——我没有自己去查这个错,直接把整段报错复制粘贴回给 DeepSeek:
我运行你的代码报错了,完整报错如下:Traceback (most recent call last):File ”analyze.py”, line 30, inanalyze_expenses('expenses.txt')File ”analyze.py”, line 9, in analyze_expenseswith open(filepath, encoding='utf-8') as f:UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd4 in position 2...
它回得很干脆:
这就是编码问题。你的txt文件是GBK编码(Windows记事本默认)。把代码里第9行的
encoding='utf-8'改成encoding='gbk'就行。或者更稳妥的做法——用
chardet自动检测编码,但你只想用标准库的话,直接改gbk最快。
我改了一行:
with open(filepath, encoding='gbk') as f:再跑:
总花费:1478.00 元分类明细(从高到低):午餐:158.00 元晚餐:360.00 元泡泡玛特:828.0元早餐:72.00 元地铁:60.00 元
第五步:加点功能,又踩一坑(排序的坑)🕳️
跑通之后我有点飘,想加个功能:按日期算每天花了多少。
我跟它说:
在原来的基础上加一个:按日期统计每天的总花费,按日期升序打印。它给了我补丁式的代码(在循环里多存一个 by_date 字典,最后多打印一段)。逻辑没问题,我粘进去再跑,结果输出里日期排序是乱的:
8月1日:52.00 元8月10日:69.00 元8月2日:162.00 元...
8月10日 排在了 8月2日 前面。原因不复杂——字符串排序是按字典序的,"8月10日" 的第三个字符是 "1",比 "8月2日" 的 "2" 小,所以排前面。
这种字符串排序的坑,自己写十有八九也会踩。我又把现象贴给 DeepSeek:
日期排序乱了,8月10日排在了8月2日前面。应该按真实日期顺序排。
它的修法是把日期里的数字抠出来排序:
# 提取”8月10日”里的日数字,转成整数来排def date_key(date_str):# date_str 形如 ”8月10日”,取”月”和”日”之间的数字# 这里假设都是8月,简化处理day_part = date_str.split('月')[1].replace('日', '')return int(day_part)sorted_dates = sorted(by_date.items(), key=lambda x: date_key(x[0]))
这里我得多说一句:它给的
date_key只处理了"8月"的情况,如果我数据跨月了(比如7月和8月混着),这个函数会出问题。我当时追问了一句"如果跨月怎么办",它给了一个更完整的版本(把月和日都拆出来转成(月, 日)元组排序)。这种边界情况你不追问,它不一定主动想到。所以 多问一嘴,少踩一坑。😉
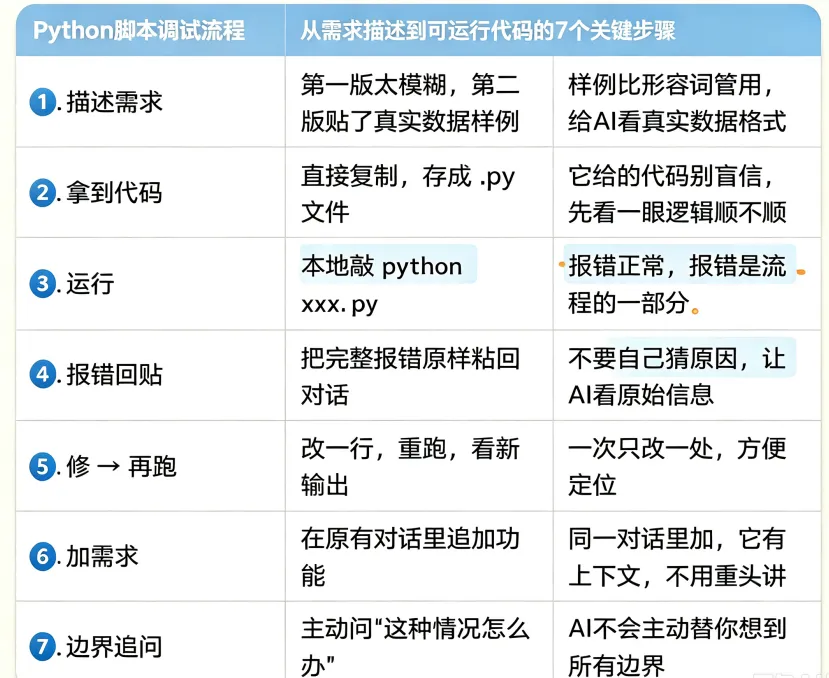
我把整个流程拆成一张表 📊
走完这一圈,我回头总结了一下"用 DeepSeek 写代码"到底分几步:
几个我用下来的真实感受 💬
“描述清楚需求”这步最花时间,也最值。第一版太糙,它直接给我假设了一个不存在的场景。第二版贴了真实数据和限制条件,代码立马靠谱。跟上周 Prompt 工程那篇的结论一样——说清楚比说得多重要。
报错不要怕,原样贴回去就行。以前我遇到报错第一反应是去百度,现在第一反应是贴给 DeepSeek。它给的修法不一定全对,但至少能告诉你“问题大概出在哪”,省了大半定位时间。
它写的代码不能盲信,但也不用怕。这次踩的两个坑(编码、排序)都不是它写错了,是我没说清楚 + 字符串本身的特性。但像“跨月排序”这种边界,你不追问它就不会主动处理。把它当个反应贼快但需要你盯细节的搭档,这个心态比较合适。
同一个对话里迭代,比开新对话效率高。加“按日期统计”功能时我是在原对话里追加的,它记得前面的数据格式和代码结构,直接给补丁式修改。如果开新对话,得把背景重讲一遍,太费劲。
小结 🌟
这周最大的收获,是第一次完整走通了 需求 → 代码 → 运行 → 报错 → 修复 的全流程。让AI写代码,跑程序已经省去了我们90%的时间,就算是新手小白,只要一遍遍的改需求,修bug,很多问题就都不是问题,很多日常需要解决的问题都可以写个代码,比如待办清单、抽签器,要事提醒等大家可以动手试一试,还是蛮有趣的。
《DeepSeek今天涨价!高峰价翻倍、最高27元/百万token,普通人怎么把钱省回来?》
一周实测:我把 Codex + DeepSeek 如何识图、渲染视频和“省钱模式”全都试过了。
从零开始手把手教你如何安装codex使用deepseek,全程国内网络环境,无账号限制,一步到位!
———————✨———————
❤️ 关注不迷路
感谢浏览
———————✅———————
