实战:从Python到Codex,一个数据可视化网站的两种开发方式
- 2026-10-20 17:15:58
大家好,我是J哥。
有一段时间没有更新了,因为我最近一直在用AI Agent做实战项目。今天,我要用AI智能体Codex复刻一个老项目,一个可视化的网站。
长这样:
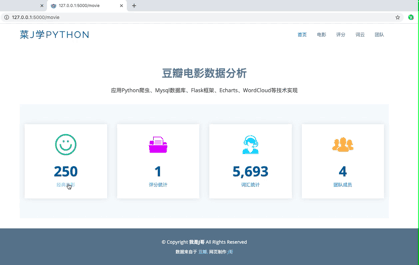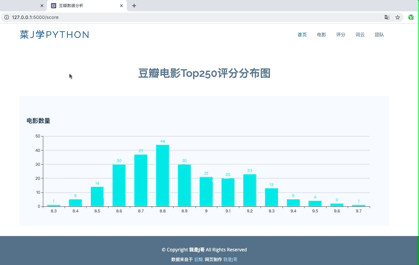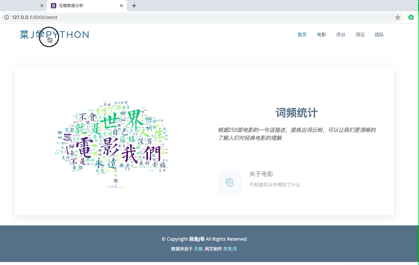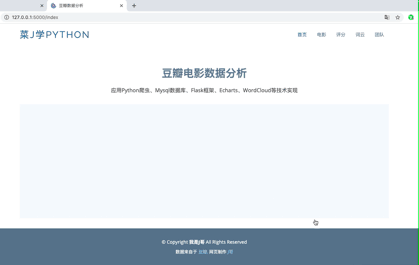
说实话,以前我用Python做这个项目还有点费劲,前前后后敲了几百行代码。但这次不一样,我全程用 Codex,从采集数据、数据处理到可视化图表网站生成,没写一行代码,十来分钟就搞定了!
OK,开始实操!
创建项目
打开Codex,直接选择创建新项目豆瓣250。PS:如果你没用过Codex,没关系,最近我会推出Codex保姆级安装、配置和使用教程,避开各种坑,让你快速上手。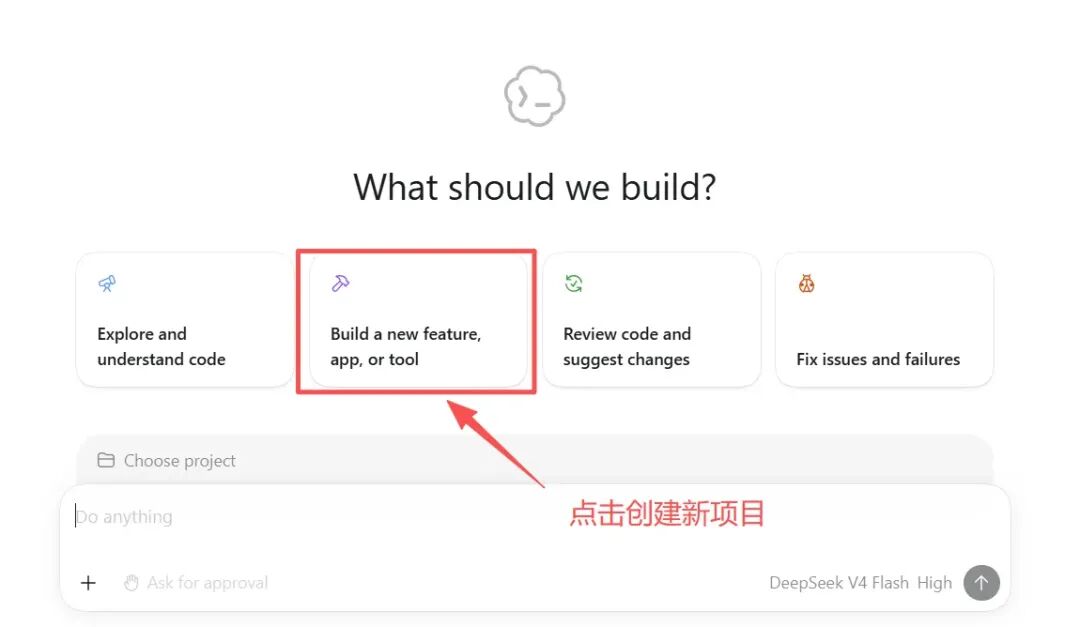
获取数据
原来用Python爬取豆瓣电影数据,我得啰嗦一大篇,教你怎么构造 url、怎么翻页、怎么导出。现在不用了,你只需要对 Codex 说:
采集豆瓣电影Top250数据,采集完成后预览前10条数据。Codex 拿到需求后,自动干了一堆活:
写出爬虫脚本 douban_top250.py(requests + BeautifulSoup);自动遍历 10 个分页( start=0、25、…、225),每页 25 条,一共 250 条;把排名、片名、年份、地区、类型、评分、评价人数、经典台词等字段全部解析出来; 乖乖预览前 10 条给你看,并存成 csv 和 json 两个文件。
Codex自动写的Python爬虫代码如下(片段):
import requestsfrom bs4 import BeautifulSoupdefparse_page(html): soup = BeautifulSoup(html, "html.parser") movies = []for li in soup.select("ol.grid_view > li"): rank = li.select_one(".pic em").get_text(strip=True) title = li.select_one(".hd .title").get_text(strip=True) rating = li.select_one(".rating_num").get_text(strip=True)# 评价人数、经典台词、年份/地区/类型…… movies.append({...})return moviesfor start in range(0, 250, 25): html = fetch_page(start) # 带 UA、带重试、带限速 movies.extend(parse_page(html))比我原来手搓的代码优雅多了!
不过别高兴太早,中间还有两个小插曲,正好体现 AI 的价值:
网络被拦了:沙箱环境访问要授权,点一下同意就好; 豆瓣改版了:新版页面里"评价人数"和"经典台词"的 HTML 结构变了,旧的选择器抓不到数据。Codex 二话不说,抓了一页 HTML 自查,改好选择器重新采集,搞定!
清洗数据
数据爬下来之后,咱得稍微清洗下,并存储下来,这里因为数据量小,我直接让Codex存为Excel。
跟 Codex 说:
选取排名、片名、年份、地区、类型、评分、评价人数、经典台词字段,原始信息字段切割为导演和主演字段,其余字段删除,数据导出为Excel文件movie.xlsx。Codex 三下五除二:
只保留 8 个有用字段,其余删光; 把"原始信息"按 导演:、主演:切成导演和主演两列;评分转成数字、评价人数去掉千分位; 导出 movie.xlsx,Excel 双击就能打开。
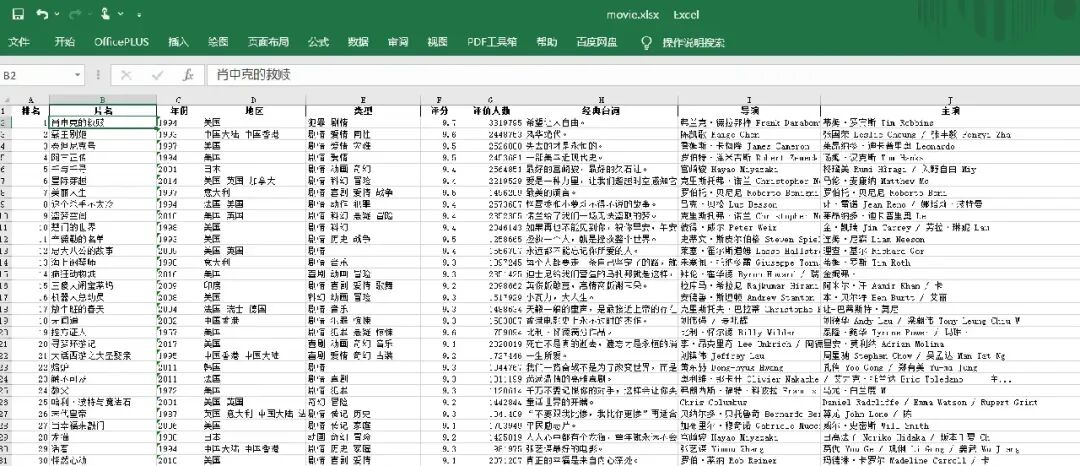
Codex自动导出核心代码就几行,以前用Python的pandas库清洗数据,要构思逻辑、编写代码、调试BUG,现在Codex几秒钟自动搞定!
import pandas as pddf = pd.DataFrame(rows, columns=["排名", "片名", "年份", "地区", "类型","评分", "评价人数", "经典台词", "导演", "主演"])df.to_excel("movie.xlsx", index=False, sheet_name="豆瓣电影Top250")制作网站主页
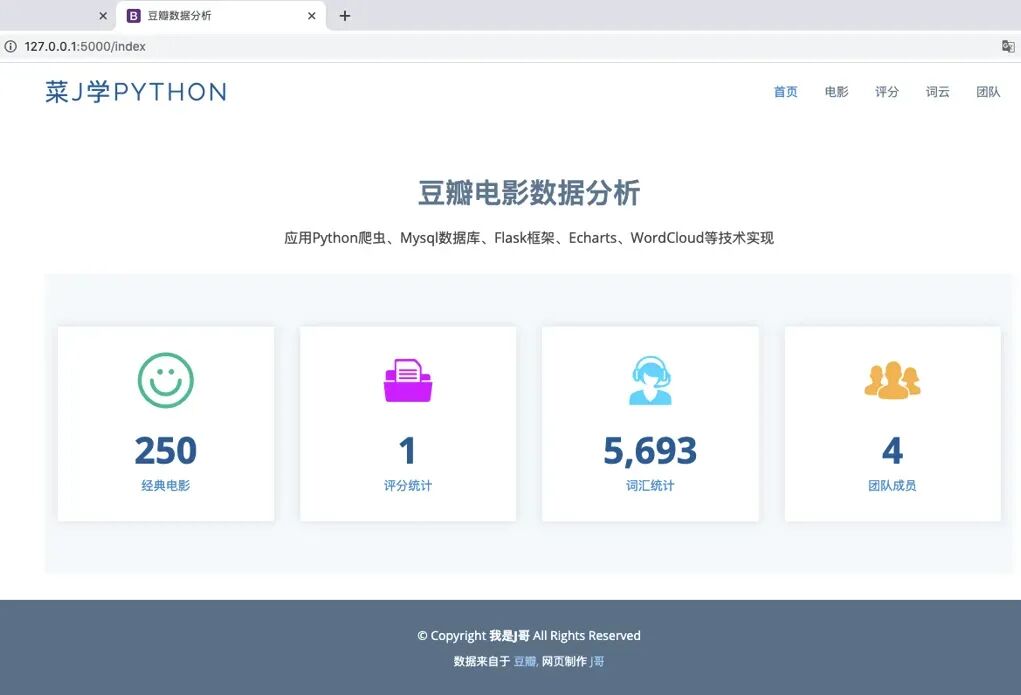
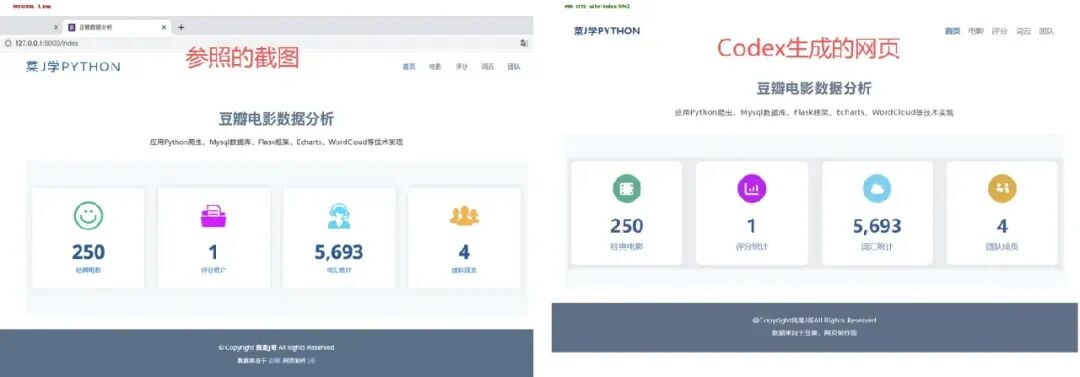
做网站最头疼的就是前端:配色、字号、间距,调来调去眼睛都要花了。以前要么自己啃 CSS,要么去网上扒模板。这次我直接甩给 Codex 一张网页截图1.png,让他照着做。
对Codex说:
帮我设计一个主页,完全模仿图片1.png你可能要问:Codex 是文本模型,它怎么"看懂"图片?办法总比困难多,它用了三招:
OCR 识别文字:先用 rapidocr_onnxruntime 把截图里的文字全认出来; 像素级分析:用 PIL 逐块取色、量字号、量间距、定位坐标; 无头浏览器校准:用 headless Chrome 渲染自己的页面,再 OCR 对比,反复微调到对齐。
等待一小会,主页就被Codex还原出来了,几乎和原网站一模一样。
主页核心结构:
<navclass="navbar">…Logo + 导航链接…</nav><headerclass="hero"><h1>豆瓣电影数据分析</h1><p>应用Python爬虫、Flask框架、Echarts、WordCloud等技术实现</p></header><sectionclass="stats-section"><divclass="stats-box"><!-- 4 张统计卡片:彩色图标 + 数字 + 标签 --></div></section><footerclass="footer">…版权信息…</footer>数据渲染到主页
网站架子有了,但卡片上的数字还是占位的,这不带劲,不是来自movie.xlsx中的数据。跟 Codex 说:
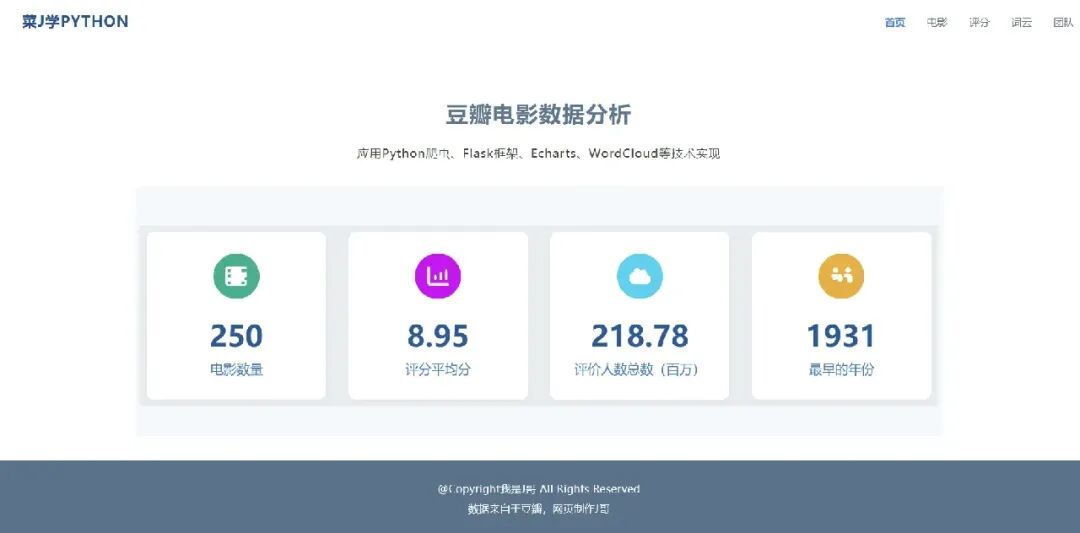
数字250改为电影总数,1改为评分平均分,5693改为评价人数总数且单位换成百万,4改为最早的年份Codex 直接读表中的数据,把硬编码的占位数字换成了真实统计:
顺手我还让 Codex 改了些小细节:"网页制作哥"改成"网页制作J哥"、副标题删掉"Mysql数据库、"……都是动动嘴的事。看看效果:
制作评分子网页
主页搞定了,咱再加个"评分"子页面,展示不同评分的电影数量。还是老规矩,一步步提需求:
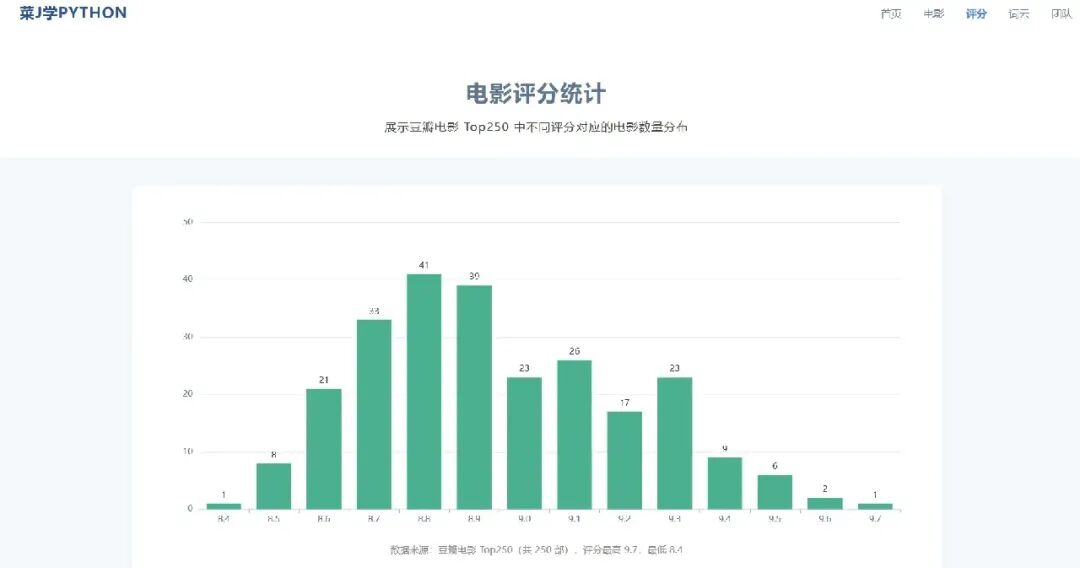
接着制作评分子网页,子网页显示不同评分的电影数量图片帮我换成ECharts图表表头删除,柱状图样式用最基础的柱状图,青绿色显示每个柱形显示数字标签我原网站图表是用ECharts图表生成的,因此我加了提示词“帮我换成ECharts图表”。
Codex 依次搞定:
先算出评分分布:8.4 ~ 9.7 共 14 档,8.8 分最多(41 部); 把 echarts.min.js下载到本地(约 1MB),断网也能用;生成基础柱状图:青绿色 #00B090,每根柱顶显示数字。
看看效果:
ECharts 配置其实很简单,核心就这几行:
var option = {xAxis: { type: 'category', data: ["8.4", "8.5", …, "9.7"] },yAxis: { type: 'value' },series: [{type: 'bar',data: [1, 8, 21, 33, 41, 39, 23, 26, 17, 23, 9, 6, 2, 1],itemStyle: { color: '#00b090' },label: { show: true, position: 'top' } }]};当然,如果你对图表有更精细化要求,也可以截图发给Codex照着做。(我这里为了省点Token没有这样干)
对了,Codex 还挺靠谱:做完会用 node 检查 JS 语法,用无头浏览器截图确认图表真的渲染出来了,而不是"看起来对"。
成果一览
项目目录/├── douban_top250.py # 爬虫脚本├── douban_top250.csv # 原始数据├── douban_top250.json # 原始数据(JSON)├── movie.xlsx # 清洗后的 Excel└── site/ # 网站 ├── index.html # 主页 ├── rating.html # 评分页(ECharts) ├── css/style.css ├── js/echarts.min.js └── data/douban_top250.json写在最后
我把这次用到的"魔法咒语"整理好了,你可以参考试试看:
剩下的电影列表页、词云页、团队页,也是相同的方法让Codex去完成,还可以让Codex部署到服务器,以后只要定时跑一遍爬虫,网站内容就自动更新啦。
OK,我们下期再见~
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- Python编程题:31.P5720 【深基4.例4】一尺之棰
- Python学习 | 09 FASTA/FASTQ Parser 与 Generator:逐条处理大型序列文件
- Effective Python 条款 3:搞懂 bytes 与 str,别再被编码 BUG 折磨
- python数据可视化技巧的100个练习 -- 55. 比较点图生成
- 我用 Python 把每天200封邮件自动分类,再也没漏过领导的消息
- Python爬取京东商品数据:DrissionPage监听search-pc-java接口,OpenCV自动过滑块验证码
- Python绘制卫星降雨校正、水文模型模拟径流的散点密度图(文末免费包邮送书)
- Python 自动分析岩石破坏过程:裂纹提取、扩展演化与损伤区域可视化(含代码)
- Python 的 str.lower() 藏着安全漏洞:大小写校验可能被绕过
- 每天10分钟玩转Python基础篇 - 异常处理