Python学习【217】:NFS之于BeeGFS,犹如OLTP之于OLAP:一个架构类比的技术启示
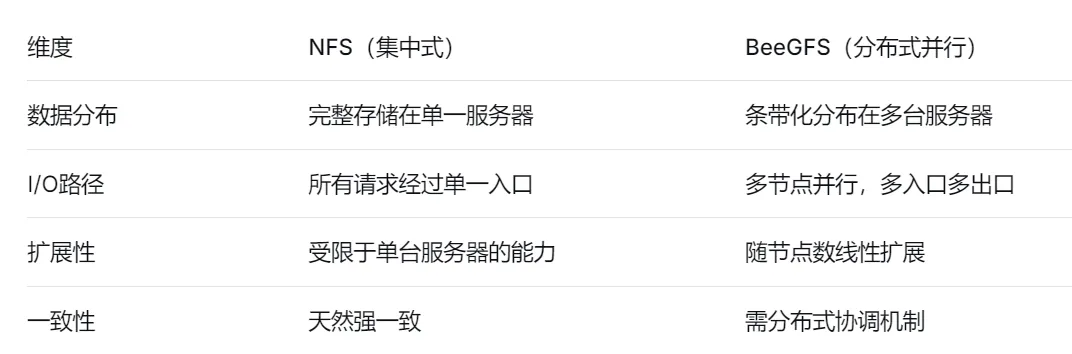
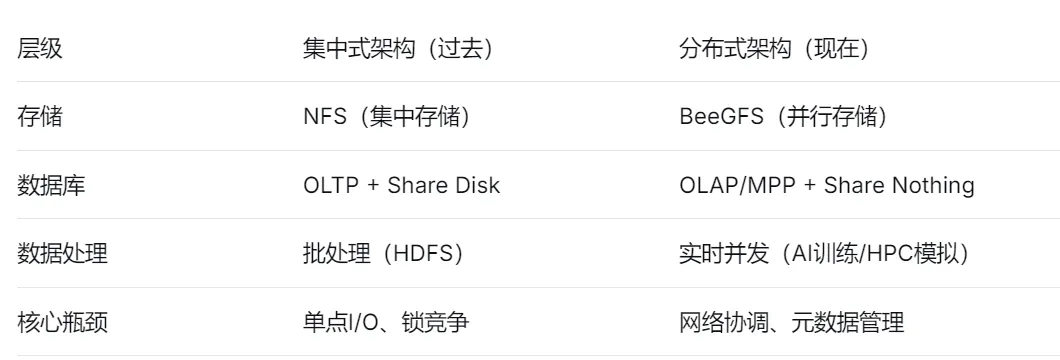
高性能集群的存储系统,常常被简化为“一块共享硬盘”的认知。当我们在管理节点上挂载800TB集中存储,并通过NFS导出给所有计算节点使用时,这种感觉尤为强烈——所有节点都能看到同一份数据,使用起来极其方便。但当我们深入观察集群的节点列表时,会发现问题并不那么简单。除了20个计算节点和4个GPU节点,还有一台名为ass01的服务器和node01、node02、node03三台存储节点,它们构成了一个BeeGFS并行存储集群。为什么已经有了NFS,还需要部署BeeGFS?这两种存储系统的本质差异是什么?它们各自适合什么场景?本文将从底层架构出发,将NFS与BeeGFS的差异类比为数据库领域的OLTP与OLAP,并引入HDFS作为对照,说明一项技术本身并无绝对的优劣,关键在于场景的适配。最后,通过这一对比,揭示从“集中式”到“分布式”的技术演进趋势。从NFS到BeeGFS:高性能集群存储架构的演进逻辑2.1 NFS与BeeGFS:从底层存储看两种架构NFS(Network File System)的本质是集中式存储。一台服务器(如mu01)将本地磁盘通过NFS协议导出,所有计算节点作为客户端挂载并访问。- 单一入口:所有读写请求都必须经过NFS服务器这一个“大门”
- 串行处理:多个客户端的请求在服务器端排队,逐一处理
- 数据一致性:因所有节点访问同一份数据,天然保证一致性
- 性能瓶颈: 当20个节点同时进行大规模数据读写时,NFS服务器的网络带宽和磁盘I/O迅速成为瓶颈。这就好比一条单车道公路,无论有多少辆车排队,每次只能通过一辆。
BeeGFS是一种分布式并行文件系统,它将多台服务器(如node01~03)的本地硬盘通过软件逻辑整合成一个统一的存储池。- 多出入口:数据被条带化(Striping)分散存储在多台服务器上
- 性能优势: 当4个GPU节点同时读取TB级训练数据时,每个节点可并行访问不同的存储服务器,整体吞吐量随节点数线性增长。这就像一条多车道高速公路,车辆可以并驾齐驱。
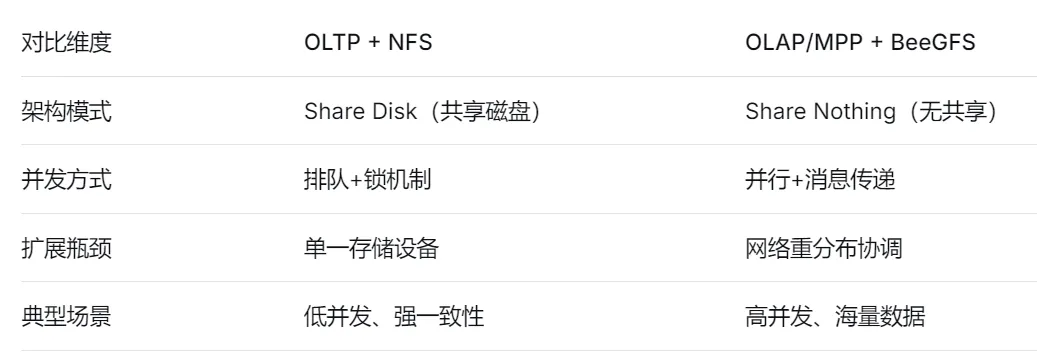
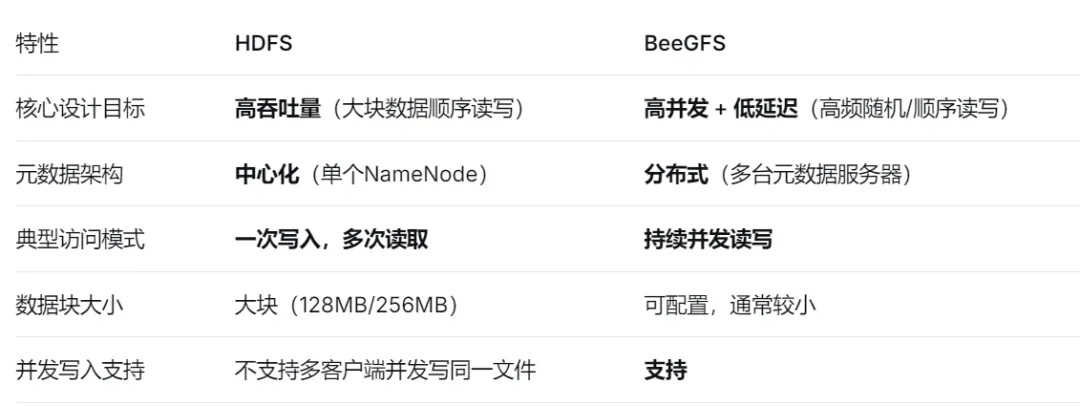
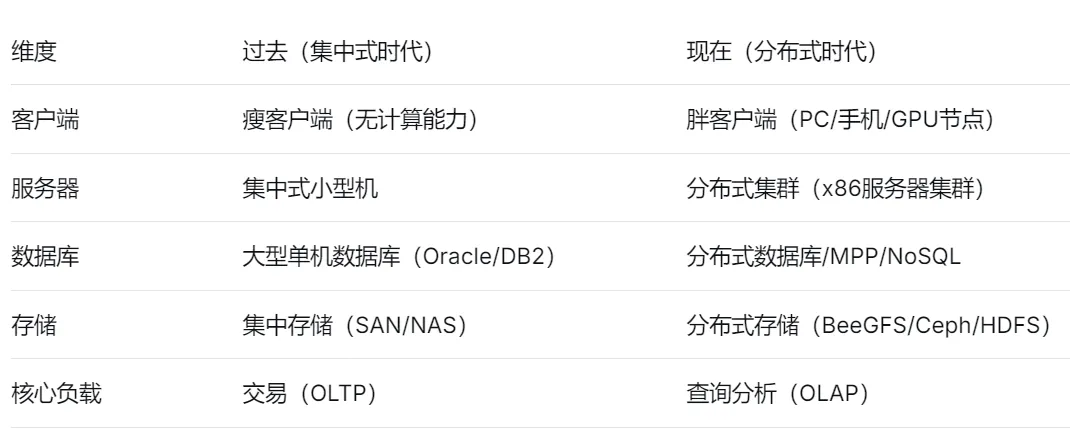
2.2 类比数据库:从OLTP到OLAP的架构演进1. 集中式存储 ≈ OLTP + Share Disk在数据库领域,OLTP(在线事务处理)系统(如银行交易系统)长期采用Share Disk架构:所有数据库节点共享同一份磁盘数据,通过分布式锁管理器(DLM)协调并发访问。这种架构与NFS如出一辙——所有节点访问同一份数据,通过排队和锁机制保证一致性,但当并发量上升时,单点瓶颈立刻显现。2. 分布式并行存储 ≈ OLAP + MPP + Share NothingOLAP(在线分析处理)系统(如数据仓库、BI报表)则采用MPP(大规模并行处理)架构,其核心是Share Nothing:每个节点拥有独立的CPU、内存和磁盘,数据被分片(Sharding)存储在各个节点上,查询被并行下发给所有节点,各自计算自己的数据分片,最后汇总结果。这种架构与BeeGFS完全对应——数据被条带化分布到多台存储节点,多个客户端并行访问,整体吞吐量随存储节点数线性增长。HDFS(Hadoop Distributed File System)是另一种分布式存储系统,但它与BeeGFS有着不同的设计哲学。HDFS的目标是批处理:一次性导入TB级数据,然后用MapReduce或Spark进行顺序扫描计算,最后一次性导出结果。它在面对频繁并发读写时表现不佳,因为它从未为这种场景设计。而BeeGFS的目标正是高频并发I/O:AI训练过程中每个Step都要读取小批量数据,多个GPU节点同时写入检查点文件——这种密集、持续的并发读写,正是BeeGFS的设计原点。因此,HDFS与BeeGFS虽然同属分布式存储,但面向的是完全不同的场景:前者服务于大数据离线批处理,后者服务于高性能在线计算。2.4 技术演进:从集中式到分布式,从OLTP到OLAP互联网和人工智能的发展,彻底改变了数据处理的格局:- 并发规模剧增:从几十个用户到百万级并发,集中式架构无法支撑
- 负载类型变化:从高频小事务(OLTP)到海量数据分析(OLAP),从顺序批处理到实时并发查询
以AI大模型训练为例:4个GPU节点同时读取TB级训练数据,每个Step都要读取小批量数据,训练过程中要频繁保存几十GB的检查点文件——这种密集并发I/O场景,NFS无法胜任,只有BeeGFS这类分布式并行文件系统才能支撑。- NFS在低并发、小文件、强一致性的场景下,简单、稳定、够用
- BeeGFS在高并发、大文件、高性能计算的场景下,是NFS的有力补充
- HDFS在大数据离线批处理场景下,以极高的吞吐量服务着整个Hadoop生态
- OLTP数据库在交易场景下,至今仍是金融系统的基石
BeeGFS的发展,反映了从“集中式”到“分布式”的技术演进趋势——当数据的规模、并发的密度、性能的要求超越了单台机器的极限时,分布式是必然的选择。从NFS到BeeGFS,从OLTP到OLAP,从集中式到分布式,这是一条清晰的技术演进脉络:技术没有绝对的“先进”与“落后”,只有“适合”与“不适合”。NFS至今仍在无数集群中稳定运行,因为它足够简单,且在低并发场景下完全够用。但当AI大模型训练需要4个GPU节点同时以每秒数GB的速度读取数据时,BeeGFS的价值就体现出来了——它用分布式的架构,解决了集中式无法逾越的瓶颈。这不仅是存储技术的演进,更是整个计算范式的转变:从“一台机器解决所有问题”到“一群机器协同解决问题”,从“集中式单点”到“分布式并行”。BeeGFS、MPP数据库、分布式计算框架……所有这些技术的共同内核,都在于用“分”来解决“大”的问题——数据太大、并发太大、计算量太大,唯有分布式,才能承载这个时代的算力需求。让我们保持学习的热情,2026年一马当先、马到成功!