附上整体代码
import pandas as pdimport numpy as npimport lightgbm as lgbimport timefrom sklearn.metrics import mean_squared_error as msefrom sklearn.model_selection import StratifiedKFold, KFoldfrom matplotlib.pyplot import plot, show, titledf_train = pd.read_csv('data/A榜-训练集_海上风电预测_气象变量及实际功率数据.csv', encoding='gbk')df_test = pd.read_csv('data/A榜-测试集_海上风电预测_气象变量数据.csv', encoding='gbk')add_df = pd.read_csv('data/A榜-训练集_海上风电预测_基本信息.csv', encoding='gbk')# add_df = pd.read_csv('data/A榜-训练集_海上风电预测_基本信息.csv')print(df_test.columns)df = pd.concat([df_train, df_test])df = df.merge(add_df[['站点编号', '装机容量(MW)']], on='站点编号', how='left')df['站点编号_le'] = df['站点编号'].map(lambda x: int(x[1]))df['time'] = pd.to_datetime(df['时间'])df['hour'] = df['time'].dt.hourdf['month'] = df['time'].dt.monthdf['min'] = df['time'].dt.minuteLABEL = '出力(MW)'df_train = df[df[LABEL].notna()]df_test = df[df[LABEL].isna()].reset_index(drop=True)df_train = df_train[df_train[LABEL]!='<NULL>'].reset_index(drop=True)df_train[LABEL] = df_train[LABEL].astype('float32')params_lgb = { 'learning_rate': 0.02, 'boosting_type': 'gbdt', 'objective': 'mse', 'metric': 'mse', 'num_leaves': 64, 'verbose': -1, 'seed': 2, 'n_jobs': -1, 'feature_fraction': 0.8, 'bagging_fraction': 0.9, 'bagging_freq': 4,}importance = 0MODEL_TYPE = 'lgb'sub_train_df = df_train[df_train['time'] < '2023-02-01 0:0:0']sub_val_df = df_train[df_train['time'] >= '2023-02-01 0:0:0']feats = [f for f in sub_train_df.columns if f not in [LABEL, '时间', 'time', '站点编号', 'min' ]]train = lgb.Dataset(sub_train_df[feats], sub_train_df[LABEL])val = lgb.Dataset(sub_val_df[feats], sub_val_df[LABEL])model = lgb.train(params_lgb, train, valid_sets=[train, val], num_boost_round=5000, callbacks=[lgb.early_stopping(100), lgb.log_evaluation(100)])val_pred = model.predict(sub_val_df[feats])s_mse = mse(sub_val_df[LABEL], val_pred, squared=False)score = 1/(1+s_mse)print('score... %.5f'%score, 'rmse...%.5f'%s_mse)importance += model.feature_importance(importance_type='gain')feats_importance = pd.DataFrame()feats_importance['name'] = featsfeats_importance['importance'] = importanceprint(feats_importance.sort_values('importance', ascending=False)[:30])plot(sub_val_df[LABEL].values)plot(val_pred)show()model = lgb.train(params_lgb, lgb.Dataset(df_train[feats], df_train[LABEL]), num_boost_round=model.best_iteration)pred_y = model.predict(df_test[feats])df_test[LABEL] = pred_ydf_test[['站点编号','时间','出力(MW)']].to_csv('ans/lgb_base_%.5f.csv'%score, index=False)
该模型的目标很简单:
根据过去的天气和风机信息(csv数据集),预测未来海上风电发了多少电。(经典的预测类模型,类似波士顿房价预测,波士顿房价预测是通过机器学习模型,基于房屋特征(如房间数、位置、犯罪率等)预测波士顿地区房价的回归分析任务。)
第一部分:我们要做什么?
“想象一下,你是个风力发电厂的厂长。你需要根据明天的天气预报(风速、温度等),提前算出明天能发多少电。这个代码就是帮你干这个活的‘智能计算器’。”
第二部分:工具箱介绍(引入库的思想)
在开始干活前,我们要把工具箱拿出来。这部分代码就像是在“点兵点将”。
1. pandas (pd)
- 深层次定位不只是“Python 中的 Excel”,而是构建在 NumPy 之上的结构化数据计算范式。其核心思想是将数据视为关系表或时间序列,并引入了 DataFrame(二维表) 和 Series(一维序列) 两种高级数据结构,使得数据操作具有声明式的表达能力。关键特性
- 惰性计算与链式操作支持
df.query()、df.pipe() 等方法,可构建清晰的数据处理流水线。 - 内存优化通过分类类型(
category)和稀疏数据结构处理大规模数据集。 - 时间序列深度支持内置时区处理、滚动窗口、重采样等金融与信号处理功能。
- 多层索引允许高维数据在二维表中表达,实现类似数据立方体的操作。
- 哲学意义:将数据库的关系代数与电子表格的直观操作结合,是数据整理(Data Wrangling)的终极工具。
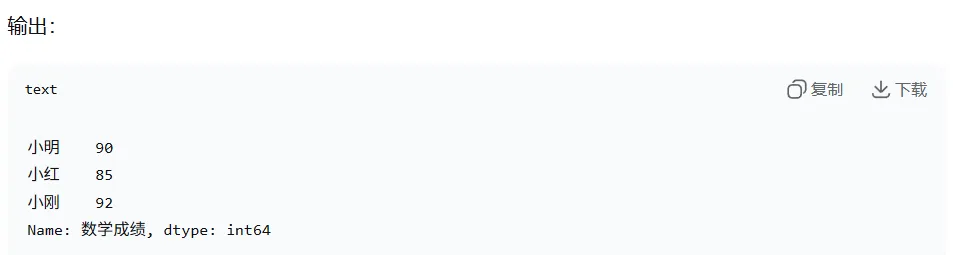
Series(一维序列):
想象一个带标签的智能列表。普通列表 [10, 20, 30] 只有数值,而Series给每个数值配上了"名字"(索引)。
import pandas as pdgrades = pd.Series([90, 85, 92],#创建Seriesindex=['小明', '小红', '小刚'], name='数学成绩') print(grades)
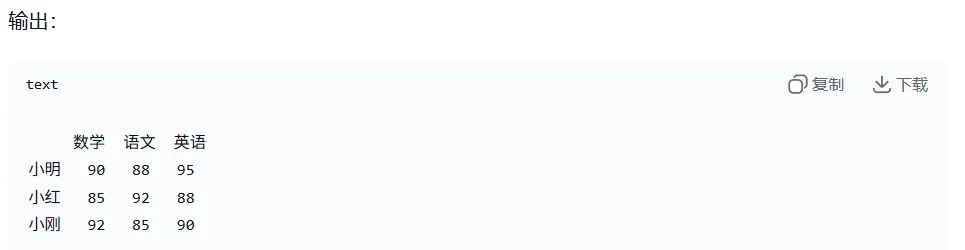
DataFrame(二维表):
想象一个Excel表格或数据库表,由多个Series按列组合而成。
#创建DataFramereport_card = pd.DataFrame({ '数学': [90, 85, 92], '语文': [88, 92, 85], '英语': [95, 88, 90] }, index=['小明', '小红', '小刚'])print(report_card)
关键区别:
- Series = 单列数据 + 行标签(索引)
- DataFrame = 多个Series的集合,有行标签和列标签
类比:
- DataFrame 像字典的字典(列名→{索引→值})
2. numpy (np)
- 深层次定位Python 科学计算的基石,核心是基于 C 语言实现的多维数组(
ndarray),提供近乎硬件级别的数值计算效率。 - 关键特性
- 广播机制允许不同形状数组进行算术运算,避免显式循环,极大提升代码简洁性与性能。
- 视图与副本通过
view() 实现数据零复制切片,优化内存使用。 - 通用函数
ufunc 支持元素级操作,并可编译为 GPU 代码(通过 CuPy 等库)。 - 结构化数组可定义复杂数据类型,模拟 C 语言结构体,适合处理二进制数据。
- 哲学意义确立了 “数组即数据” 的范式,是 Python 科学计算生态的接口标准。
核心思想:NumPy就是批量计算器。
普通Python列表 vs NumPy数组:
# Python列表:笨拙的计算方式grades_list = [90, 85, 92, 78, 88]average_list = sum(grades_list) / len(grades_list) # 需要手动计算
# NumPy数组:智能批量操作import numpy as npgrades_np = np.array([90, 85, 92, 78, 88])average_np = np.mean(grades_np) # 一句话搞定
NumPy的三大魔法:
- 广播魔法
# 数组可以直接加减乘除scores = np.array([85, 90, 78])adjusted = scores + 5 # 自动给每个成绩加5分# 结果:[90, 95, 83]
- 向量化运算
# 传统方式(慢)result = []for x in [1, 2, 3, 4]: result.append(x * 2) # 需要循环# NumPy方式(快如闪电)arr = np.array([1, 2, 3, 4])result = arr * 2 # 一句话完成
- 多维视角
# 一维数组:12个月的销售额sales = np.array([100, 120, 110, 130, 140, 150, 160, 170, 180, 190, 200, 210])# 变成二维:按季度查看(4个季度×3个月)sales_by_quarter = sales.reshape(4, 3)print(sales_by_quarter)
小白记忆口诀:
"普通列表像算盘,一个一个拨珠子;
NumPy像计算器,整盘数据一起算。"
3. lightgbm (lgb)
- 深层次定位不仅是“快速梯度提升机”,更是面向大规模数据与高维特征的树模型优化实现。其核心创新在于 GOSS(基于梯度的单边采样) 与 EFB(互斥特征捆绑) 算法。
- 关键特性
- 直方图算法
- 叶子优先生长策略
- 类别特征直接支持
- 并行与分布式优化
- 哲学意义体现了 “精度与效率的权衡”——通过算法创新,在几乎不损失精度的情况下,将传统 GBDT 的效率提升数个量级。
GBDT(梯度提升决策树):
想象一个学习小组做数学题:
LightGBM 的优化:
普通GBDT像全班一起考试,LightGBM像智能分小组考试:
- 直方图算法把分数段分组(如90-100、80-90),只看组别不看具体分数
- 叶子生长先集中攻克最容易提分的知识点(优先分裂损失最大的叶子)
- 特征捆绑把相关的知识点打包学习(如"几何"和"三角函数"一起学)
代码示例对比:
# 传统决策树 vs LightGBMfrom sklearn.tree import DecisionTreeRegressorimport lightgbm as lgb# 传统方式:一棵大树(容易过拟合)tree = DecisionTreeRegressor(max_depth=10)tree.fit(X_train, y_train)
# LightGBM:100棵小树团队合作(更稳定)model = lgb.LGBMRegressor( n_estimators=100, # 100棵小树 learning_rate=0.1, # 每棵树学慢一点 max_depth=3 # 每棵树很浅)model.fit(X_train, y_train)
4. sklearn (scikit-learn)
- 深层次定位机器学习算法设计与工程化的典范,其核心是统一的 API 设计(
fit、predict、transform),使得算法成为可插拔组件。 - 关键特性
- 流水线
Pipeline 将预处理、特征选择、模型训练封装为单一对象,避免数据泄露。 - 模型选择工具
GridSearchCV、cross_val_score 等实现了自动化超参数调优与验证。 - 元估计器如
OneVsRestClassifier,可通过组合简单模型构建复杂模型。 - 设计一致性
- 哲学意义将机器学习流程模块化与标准化,降低了算法应用的门槛,并推动了可复现研究。
5. matplotlib.pyplot
- 深层次定位Python 可视化的底层引擎,其设计哲学是提供从像素级别控制到高级图表快速生成的全层次接口。
- 关键特性
- 面向对象与状态机接口支持两种编程风格——显式操作图形对象或依赖
pyplot 隐式管理当前图形。 - 图形元素抽象将图表分解为
Figure、Axes、Axis、Artist 等对象,允许极细粒度定制。 - 后端系统可将图形渲染到多种输出(PNG、PDF、交互式窗口等),并可集成 GUI 框架。
- TeX 集成
- 哲学意义“可视化即编程”,将图形生成过程转化为可脚本化、可版本控制的计算任务,与探索性数据分析(EDA)文化深度契合。
第三部分:逐行实战讲解(代码逻辑)
我们要把代码分成几个阶段:数据准备 -> 数据清洗 -> 建立模型 -> 训练 -> 预测。
阶段一:读取与合并数据 (Data Loading)
df_train = pd.read_csv('data/A榜-训练集_海上风电预测_气象变量及实际功率数据.csv', encoding='gbk') df_test = pd.read_csv('data/A榜-测试集_海上风电预测_气象变量数据.csv', encoding='gbk') add_df = pd.read_csv('data/A榜-训练集_海上风电预测_基本信息.csv', encoding='gbk')
- 讲解点:
encoding='gbk':因为文件里有中文,如果不加这个,Python 可能会显示乱码报错。Windows 下的中文 CSV 常需要用 gbk。- 逻辑: 我们有三份文件。
df_train 是带答案的练习题(有天气,也有实际发电量);df_test 是期末考卷(只有天气,没有发电量,需要我们填);add_df 是补充资料(每个风机的装机容量等固定属性)。
df = pd.concat([df_train, df_test])
- 讲解点:
pd.concat - 为什么要拼? 为了方便统一处理数据(比如统一把时间格式改好),处理完再切开。
df = df.merge(add_df[['站点编号', '装机容量(MW)']], on='站点编号', how='left')
- 讲解点:
merge 是“左右拼接”(类似 Excel 的 VLOOKUP)。 - 意思: 也就是根据“站点编号”,把
add_df 里的“装机容量”贴到主表上去。how='left' 意思是保留左边表(主表)的所有行。
阶段二:特征工程 (Feature Engineering)
“原始数据往往不够好,我们需要把它们加工成模型更容易理解的形式,这叫‘特征工程’。”
df['站点编号_le'] = df['站点编号'].map(lambda x: int(x[1]))
- 讲解点: 原始编号可能是 "S1", "S2" 这种字符串。模型只认识数字。
- 操作:
x[1] 取出第二个字符(即数字部分),然后转成整数 int。
df['time'] = pd.to_datetime(df['时间']) df['hour'] = df['time'].dt.hour df['month'] = df['time'].dt.month df['min'] = df['time'].dt.minute
- 讲解点: 时间原本是字符串 "2023-01-01 12:00"。
- 操作:
- 为什么要拆? 因为风和电是有规律的。比如中午(hour=12)通常太阳大、风可能变;夏天和冬天(month)风况也不同。模型能从这些数字里学到规律。
阶段三:数据清洗与还原 (Data Cleaning)
`LABEL = '出力(MW)' # 我们要预测的目标
把刚才拼起来的表,按是否有答案切回“训练集”和“测试集”
df_train = df[df[LABEL].notna()] df_test = df[df[LABEL].isna()].reset_index(drop=True)
关键清洗步骤
df_train=df_train[df_train[LABEL]!='<NULL>'].reset_index(drop=True) df_train[LABEL] = df_train[LABEL].astype('float32')`
- 讲解点:
notna() 和 isna():通过判断目标列是不是空的,把拼在一起的数据分家。!= '<NULL>': 有时候数据里的缺失值不是真正的空值,而是写了个字符串 "<NULL>"。这行代码是把这些脏数据扔掉。astype('float32')
阶段四:模型参数设置 (Model Configuration)
params_lgb = { 'learning_rate': 0.02, # 学习率:步子迈多大。太小跑得慢,太大容易错过最优解。 'boosting_type': 'gbdt', # 算法类型:传统的梯度提升树。 'objective': 'mse', # 目标函数:我要最小化均方误差(预测值和真实值差的平方)。 'num_leaves': 64, # 树的复杂度:树越繁茂,拟合越好,但太繁茂会“死记硬背”(过拟合)。 'n_jobs': -1, # 用电脑的所有CPU核一起跑。 'feature_fraction': 0.8, # 每次学习只看80%的特征(防止偏科)。 'bagging_fraction': 0.9, # 每次学习只看90%的数据(防止死记硬背)。 'bagging_freq': 4, # 每4次迭代执行一次bagging。}
阶段五:验证集切分与训练 (Training & Validation)
sub_train_df = df_train[df_train['time'] < '2023-02-01 0:0:0']sub_val_df = df_train[df_train['time'] >= '2023-02-01 0:0:0']
- 重要概念:线下验证 (Local Validation)
- 讲解: 我们不能把所有带答案的数据都用来训练,必须留一部分(比如2月1号以后的)假装没看过,用来测试模型到底学懂了没有。
- 为什么按时间切? 因为是时间序列问题。我们在预测未来,所以验证集必须是“未来”的时间段,不能打乱随机切,否则就是作弊(用未来的数据预测过去)。
# 构造 LightGBM 专用的数据格式train = lgb.Dataset(sub_train_df[feats], sub_train_df[LABEL])val = lgb.Dataset(sub_val_df[feats], sub_val_df[LABEL])# 开始训练!model = lgb.train(params_lgb, train, valid_sets=[train, val], num_boost_round=5000, callbacks=[lgb.early_stopping(100), lgb.log_evaluation(100)])
- 讲解点:
lgb.Dataset:把 DataFrame 打包成 LightGBM 也就是 LGB 喜欢吃的高效格式。num_boost_round=5000early_stopping(100):早停机制。如果模型在验证集上连续 100 轮都没有进步,就提前停止。这就像“如果再学也学不进去了,就别学了,去考试吧”,防止过拟合。
阶段六:评估与可视化 (Evaluation)
val_pred = model.predict(sub_val_df[feats])s_mse = mse(sub_val_df[LABEL], val_pred, squared=False) # 其实这里算的是RMSEscore = 1/(1+s_mse)
- 讲解点:
mse(..., squared=False):这里虽然函数名是 mse,但参数 squared=False 意味着结果开了根号,所以是 RMSE(均方根误差)。score = 1/(1+s_mse):这是比赛定义的得分公式。误差越小,分母越小,分数越高。
importance += model.feature_importance(importance_type='gain')# ... 打印前30个最重要的特征 ...
- 作用: 看看模型觉得哪些因素最影响发电量(比如风速肯定排第一,如果是“分钟”排第一可能就有问题)。
阶段七:全量训练与输出结果 (Final Submit)
model = lgb.train(params_lgb, lgb.Dataset(df_train[feats], df_train[LABEL]), num_boost_round=model.best_iteration)pred_y = model.predict(df_test[feats])df_test[LABEL] = pred_ydf_test[['站点编号','时间','出力(MW)']].to_csv(...)
- 逻辑: 刚才我们验证觉得模型不错,现在我们要用所有的数据(不再留验证集)重新训练一遍,用刚才找到的“最佳轮数” (
best_iteration)。这样模型见过的世面更多,预测考试题(测试集)效果理论上更好。
好了,到这里,我们就完成了这份基线代码的完整“旅程”。
从理解目标、认识工具箱、到亲手处理数据、调教模型,最后做出预测——你已经不只是看懂了几行代码,而是完成了一次小小的数据科学实践。
你可以这样告诉你的朋友:
“这份 Baseline 就像一张地图,它告诉了你从起点到终点的标准路线。现在路你认得了,接下来,想走得更快(优化速度)、发现更美的风景(提高精度),甚至开辟新道路(尝试新模型),就取决于你的探索了。”
当你按下运行键,得到第一份预测结果时,你就不再是面对算法黑箱的“小白”,而是开始驾驭数据的“船长”。这份基线代码,就是你的第一艘船。
祝你的朋友,航行顺利,在数据的海洋里发现属于自己的宝藏!