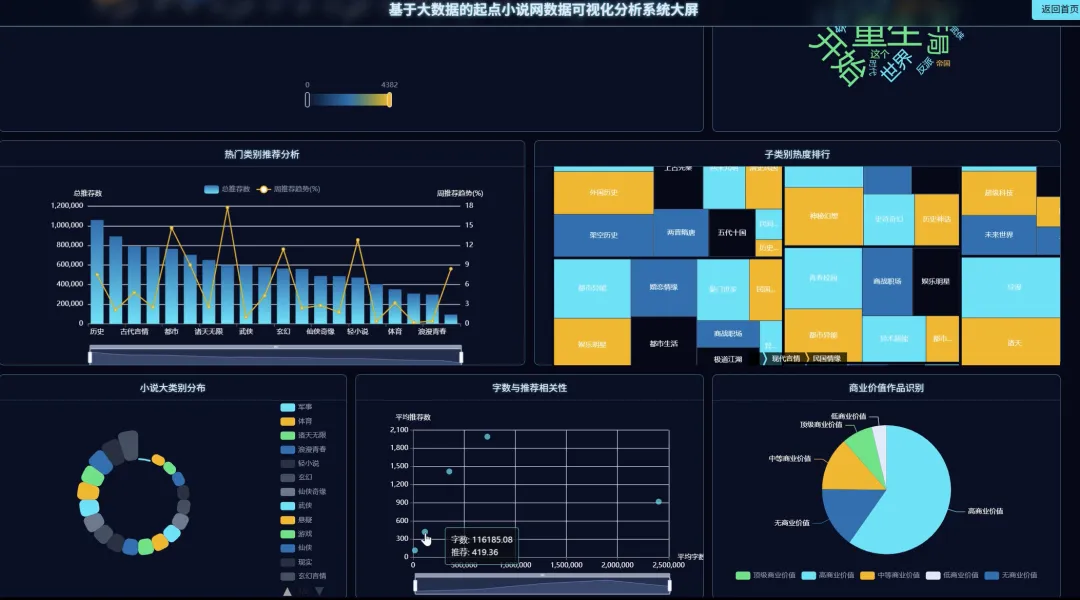
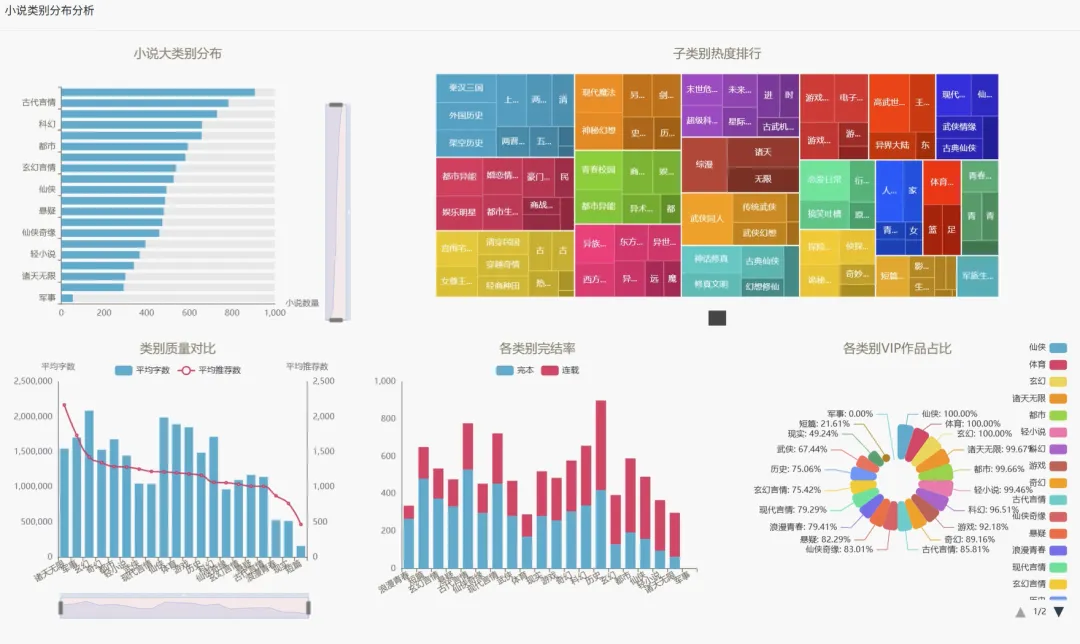
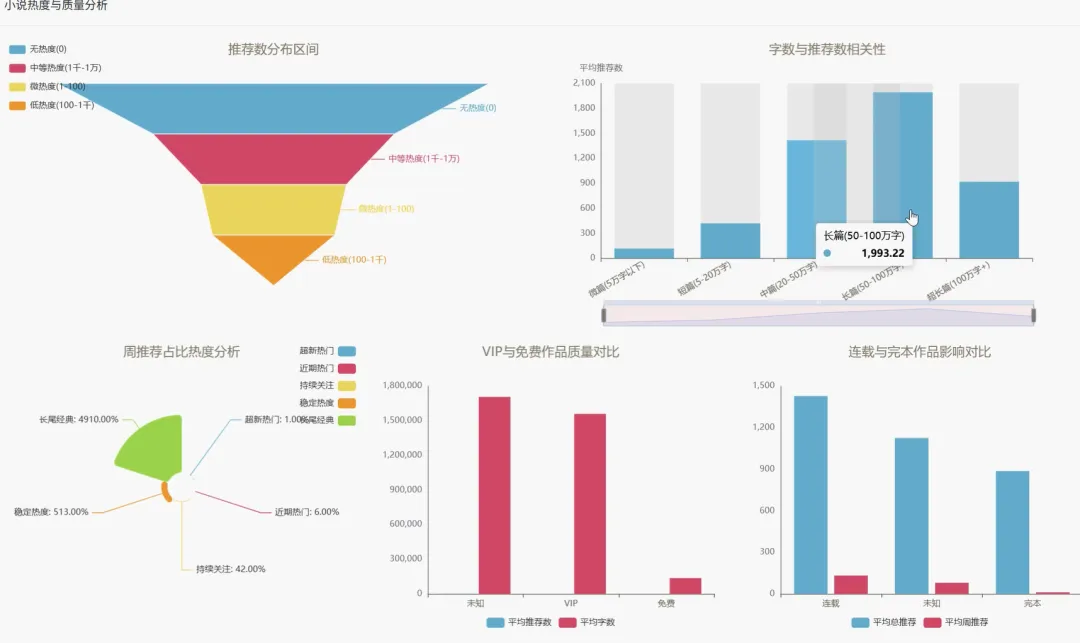
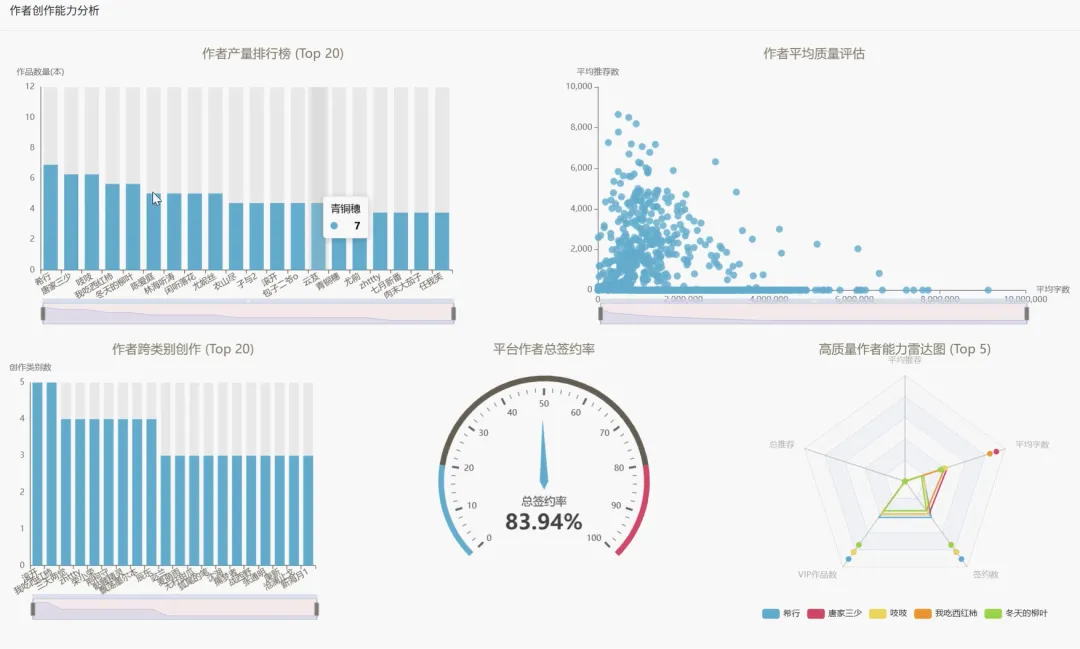
from pyspark.sql import SparkSession, functions as Ffrom pyspark.sql.window import Windowspark = SparkSession.builder.appName("QidianAnalysis").getOrCreate()# 核心功能1: 小说类别分布分析def class_distribution_analysis(): df = spark.read.csv("hdfs://your_path/bookInfo.csv", header=True, inferSchema=True, encoding="utf-8") df_filtered = df.filter(F.col("class_type").isNotNull() & (F.col("class_type") != "")) class_count_df = df_filtered.groupBy("class_type").agg(F.count("*").alias("novel_count")) total_novels = df_filtered.count() class_distribution_df = class_count_df.withColumn("percentage", F.round((F.col("novel_count") / total_novels) * 100, 2)) class_distribution_df = class_distribution_df.orderBy(F.col("novel_count").desc()) class_distribution_df.toPandas().to_csv("/path/to/save/class_distribution.csv", index=False, encoding="utf-8-sig")# 核心功能2: 高产作者排行榜分析def author_productivity_analysis(): df = spark.read.csv("hdfs://your_path/bookInfo.csv", header=True, inferSchema=True, encoding="utf-8") df_filtered = df.filter(F.col("author_name").isNotNull() & (F.col("author_name") != "未知")) author_count_df = df_filtered.groupBy("author_name").agg(F.count("*").alias("book_count")) window_spec = Window.orderBy(F.col("book_count").desc()) author_ranked_df = author_count_df.withColumn("rank", F.row_number().over(window_spec)) top_authors_df = author_ranked_df.filter(F.col("rank") <= 20).select("rank", "author_name", "book_count") top_authors_df.toPandas().to_csv("/path/to/save/top_authors.csv", index=False, encoding="utf-8-sig")# 核心功能3: 字数与推荐数相关性分析def word_count_recommend_correlation_analysis(): df = spark.read.csv("hdfs://your_path/bookInfo.csv", header=True, inferSchema=True, encoding="utf-8") df_cleaned = df.filter(F.col("count").isNotNull() & (F.col("total_recommend").isNotNull()) df_cleaned = df_cleaned.withColumn("word_count_num", F.regexp_extract(F.col("count"), r"(\d+\.?\d*)", 1).cast("float")) df_cleaned = df_cleaned.withColumn("word_count_num", F.when(F.col("count").contains("万"), F.col("word_count_num") * 10000).otherwise(F.col("word_count_num"))) df_cleaned = df_cleaned.filter(F.col("word_count_num") > 0) correlation_df = df_cleaned.select(F.corr("word_count_num", "total_recommend").alias("correlation")) correlation_value = correlation_df.collect()[0]["correlation"] df_binned = df_cleaned.withColumn("word_count_bin", F.when(F.col("word_count_num") < 500000, "50万字以下").when((F.col("word_count_num") >= 500000) & (F.col("word_count_num") < 1000000), "50-100万字").when((F.col("word_count_num") >= 1000000) & (F.col("word_count_num") < 2000000), "100-200万字").otherwise("200万字以上")) bin_analysis_df = df_binned.groupBy("word_count_bin").agg(F.avg("total_recommend").alias("avg_recommend"), F.count("*").alias("book_count")).orderBy(F.col("word_count_bin")) bin_analysis_df.toPandas().to_csv("/path/to/save/word_recommend_analysis.csv", index=False, encoding="utf-8-sig")
 10个月宝宝每天需要喝多少奶粉?