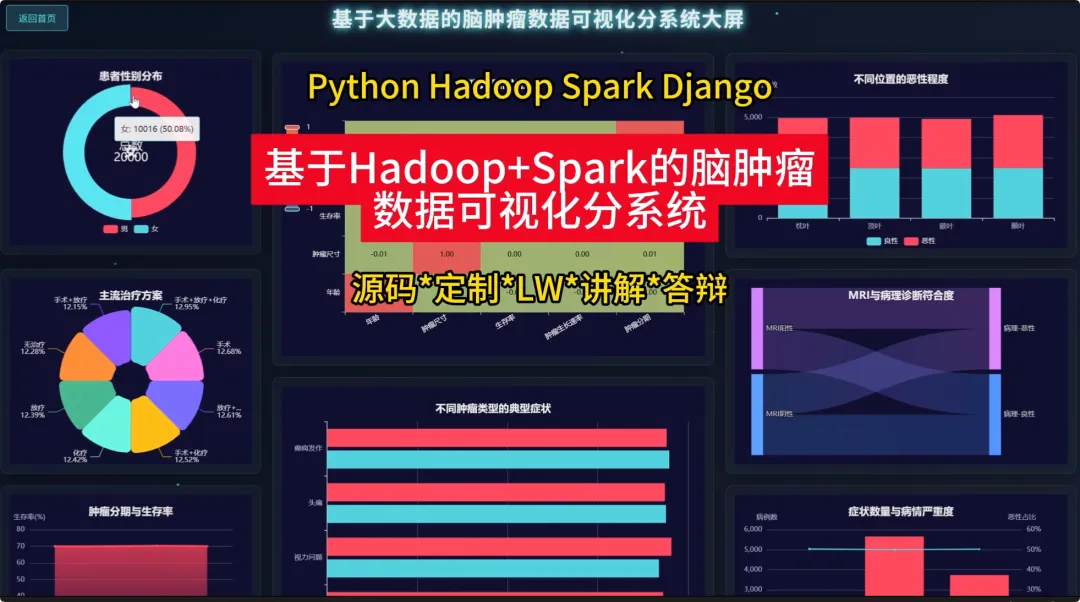
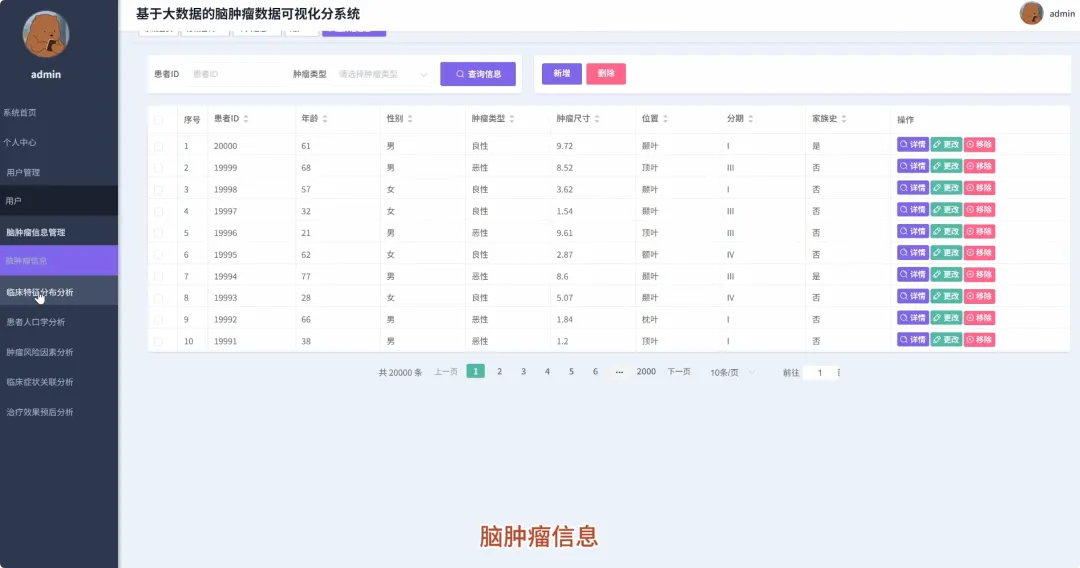
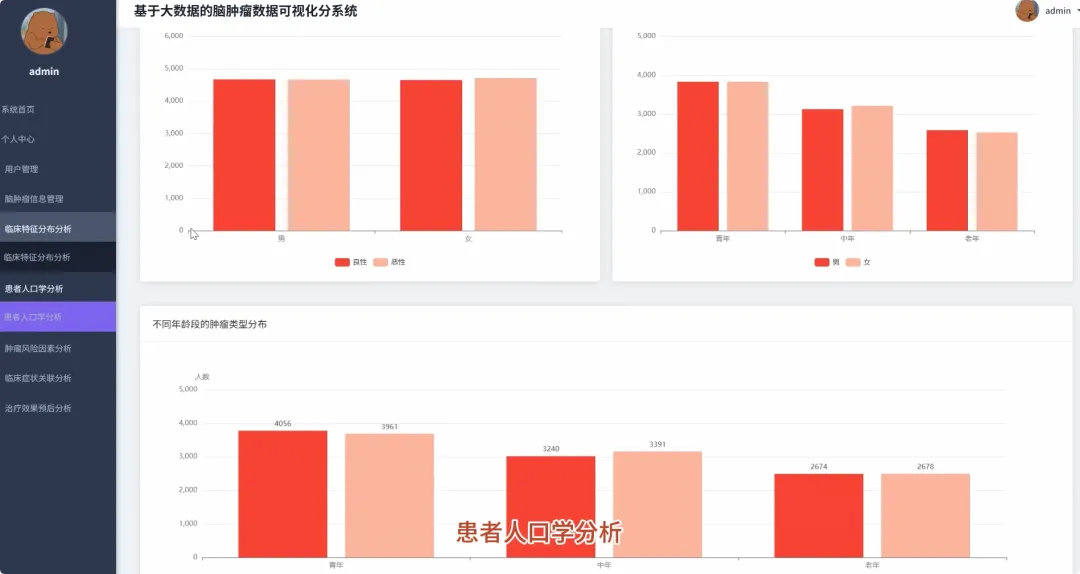
from pyspark.sql import SparkSession, functions as Ffrom pyspark.sql.types import IntegerTypespark = SparkSession.builder.appName("BrainTumorAnalysis").getOrCreate()df = spark.read.csv("hdfs://path/to/brain_tumor_data.csv", header=True, inferSchema=True)def analyze_age_gender_distribution(): age_group_df = df.withColumn("Age_Group", F.when((df.Age < 18), "少年").when((df.Age >= 18) & (df.Age < 40), "青年").when((df.Age >= 40) & (df.Age < 60), "中年").otherwise("老年")) result_df = age_group_df.groupBy("Age_Group", "Gender").count().orderBy("Age_Group", "Gender") result_df.show() return result_dfdef analyze_treatment_survival(): treatment_df = df.withColumn("Treatment_Combination", F.concat_ws("+", F.when(df.Surgery_Performed == "Yes", "手术"), F.when(df.Radiation_Treatment == "Yes", "放疗"), F.when(df.Chemotherapy == "Yes", "化疗"))) survival_df = treatment_df.groupBy("Treatment_Combination").agg(F.avg("Survival_Rate").alias("Average_Survival_Rate"), F.count("*").alias("Patient_Count")).orderBy(F.desc("Average_Survival_Rate")) survival_df.show() return survival_dfdef analyze_correlation(): correlation_df = df.select("Age", "Tumor_Size", "Survival_Rate", "Tumor_Growth_Rate").na.drop() age_size_corr = correlation_df.stat.corr("Age", "Tumor_Size") age_survival_corr = correlation_df.stat.corr("Age", "Survival_Rate") size_survival_corr = correlation_df.stat.corr("Tumor_Size", "Survival_Rate") growth_survival_corr = correlation_df.stat.corr("Tumor_Growth_Rate", "Survival_Rate") print(f"年龄与肿瘤尺寸的相关系数: {age_size_corr}") print(f"年龄与生存率的相关系数: {age_survival_corr}") print(f"肿瘤尺寸与生存率的相关系数: {size_survival_corr}") print(f"肿瘤生长速率与生存率的相关系数: {growth_survival_corr}") return {"age_size": age_size_corr, "age_survival": age_survival_corr, "size_survival": size_survival_corr, "growth_survival": growth_survival_corr}
 10个月宝宝每天需要喝多少奶粉?