一直想用python来实现下RAG功能,可能因为设备性能问题,我们在本地只能跑小模型,我们又没有能力自己对模型进行微调。所以能给到对应文档,让AI根据文档内容来进行回复,这样可以增加准确率。 我们本次实验使用的库如下:使用pip install xxx==版本号,即可安装。requests==2.31.0sentence-transformers==2.2.2faiss-cpu==1.7.4numpy==1.24.3
sentence-transformers 这个库是由英国UKPLab实验室开发、现在由社区维护的一个非常流行的Python库,可以用它来轻松地将句子、段落甚至图片转换成高质量的向量表示(即“嵌入”),然后用于计算语义相似度、语义搜索、文本聚类等多种任务。
它提供超过100种语言的众多预训练模型,例如经典的 all-MiniLM-L6-v2(速度快)和 all-mpnet-base-v2(精度高)。
使用pip安装即可:pip install -U sentence-transformers
faiss 是一个非常流行的向量相似性搜索库,简单来说,sentence-transformers 负责将文本转换为向量,而 faiss 则负责高效地存储和检索这些向量。
最常用的安装方式是使用 pip 安装 CPU 版本(适合大多数学习和开发场景):
如果有gpu环境也可以使用gpu加速:
总的来说,你可以把 sentence-transformers 和 faiss 看作处理向量语义任务的前后两大利器:一个负责“理解”并生成向量,另一个负责“管理”并快速查找向量。
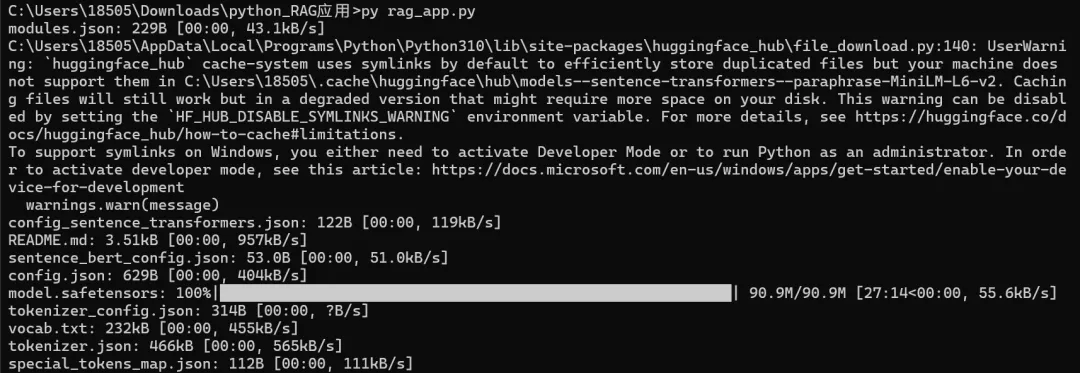
那么接下来进入正题,我们在使用模型时,首次会需要去下载模型,我们需要在运行程序的终端里,运行以下命令:
set HF_ENDPOINT=https://hf-mirror.com
然后再运行我们的程序,这样会通过国内镜像站下载模型,速度会快很多。
接下来我们来看本次实验的代码:
import osimport jsonimport requestsfrom typing import List, Dictfrom sentence_transformers import SentenceTransformerimport faissimport numpy as np# 配置DeepSeek API密钥和URLDEEPSEEK_API_KEY = "DEEPSEEK_API_KEY"#DEEPSEEK_API_KEYDEEPSEEK_API_URL = "https://api.deepseek.com/v1/chat/completions"# 初始化嵌入模型embedding_model = SentenceTransformer('paraphrase-MiniLM-L6-v2')# 模拟文档库documents = [ "DeepSeek 是一个强大的语言模型平台。", "RAG 结合了检索和生成的优势。", "Python 是一种广泛使用的高级编程语言。", "向量数据库用于高效存储和检索嵌入向量。", "Faiss 是 Facebook 开发的高效相似性搜索库。"]# 构建向量索引def build_vector_index(docs: List[str]) -> faiss.IndexFlatIP: embeddings = embedding_model.encode(docs) dimension = embeddings.shape[1] index = faiss.IndexFlatIP(dimension) faiss.normalize_L2(embeddings) index.add(embeddings.astype('float32')) return index# 检索相关文档def retrieve_documents(query: str, index: faiss.IndexFlatIP, docs: List[str], top_k: int = 3) -> List[str]: query_embedding = embedding_model.encode([query]) faiss.normalize_L2(query_embedding) distances, indices = index.search(query_embedding.astype('float32'), top_k) return [docs[i] for i in indices[0]]# 调用DeepSeek API生成回答def generate_answer(prompt: str) -> str: headers = { "Authorization": f"Bearer {DEEPSEEK_API_KEY}", "Content-Type": "application/json" } payload = { "model": "deepseek-chat", "messages": [{"role": "user", "content": prompt}], "stream": False } response = requests.post(DEEPSEEK_API_URL, headers=headers, data=json.dumps(payload)) if response.status_code == 200: result = response.json() return result["choices"][0]["message"]["content"] else: raise Exception(f"请求失败:{response.status_code}, {response.text}")# 主函数实现RAG流程def rag_pipeline(query: str): print("构建向量索引...") index = build_vector_index(documents) print("检索相关文档...") retrieved_docs = retrieve_documents(query, index, documents) context = "\n".join(retrieved_docs) prompt = f"根据以下内容回答问题:\n{context}\n\n问题:{query}" print("生成回答中...") answer = generate_answer(prompt) print("回答:", answer)if __name__ == "__main__": user_query = input("请输入你的问题:") rag_pipeline(user_query)
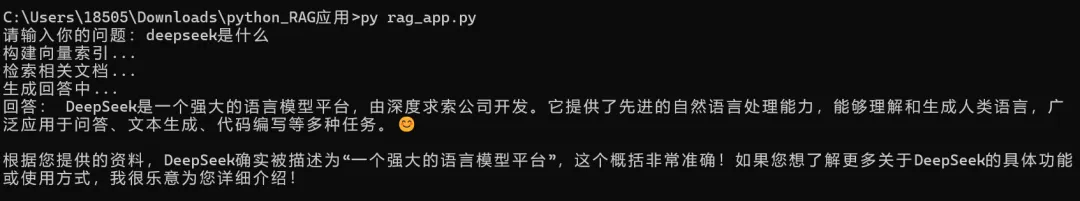
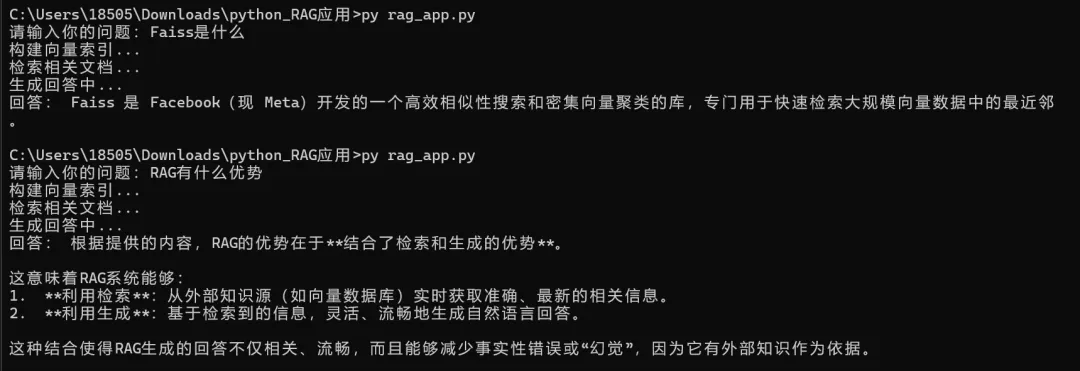
我们在终端里运行:
我们可以看到AI根据我们提供的文本进行了一个回复。那么我们本次的实验就到这里,感兴趣的伙伴可以跟着实操起来啦!
 10个月宝宝每天需要喝多少奶粉?