当前位置:首页>python>【大数据毕设】Python+Hadoop实现抑郁症风险数据分析可视化 毕业设计 选题推荐 毕设选题 数据分析 机器学习

【大数据毕设】Python+Hadoop实现抑郁症风险数据分析可视化 毕业设计 选题推荐 毕设选题 数据分析 机器学习

  • 2026-10-21 13:26:54
【大数据毕设】Python+Hadoop实现抑郁症风险数据分析可视化 毕业设计 选题推荐 毕设选题 数据分析 机器学习
基于Hadoop的青少年抑郁症风险数据分析可视化系统
一

青少年抑郁症风险数据分析可视化系统-简介

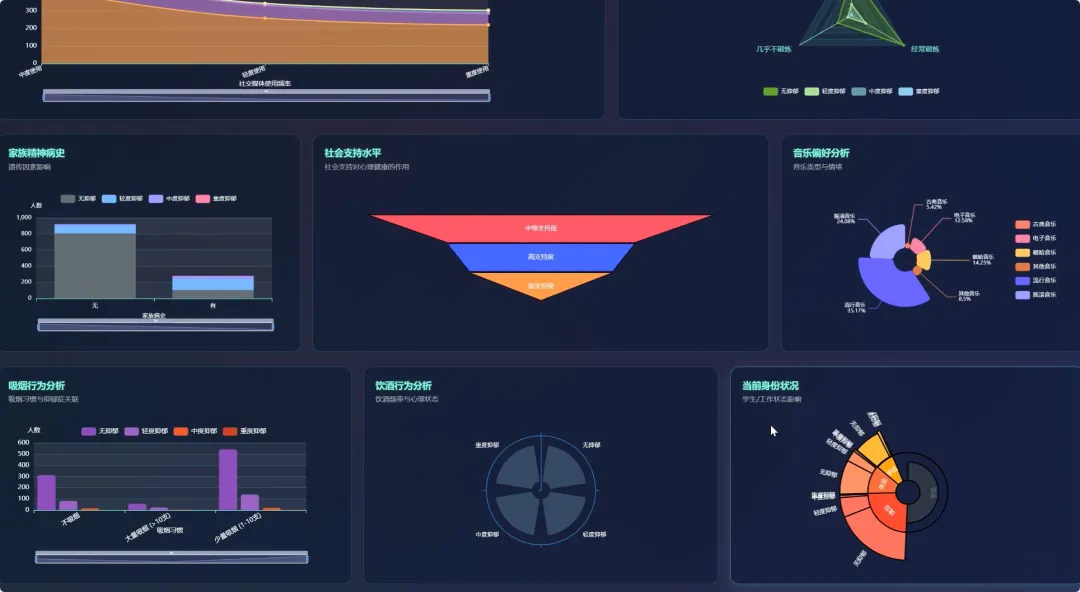
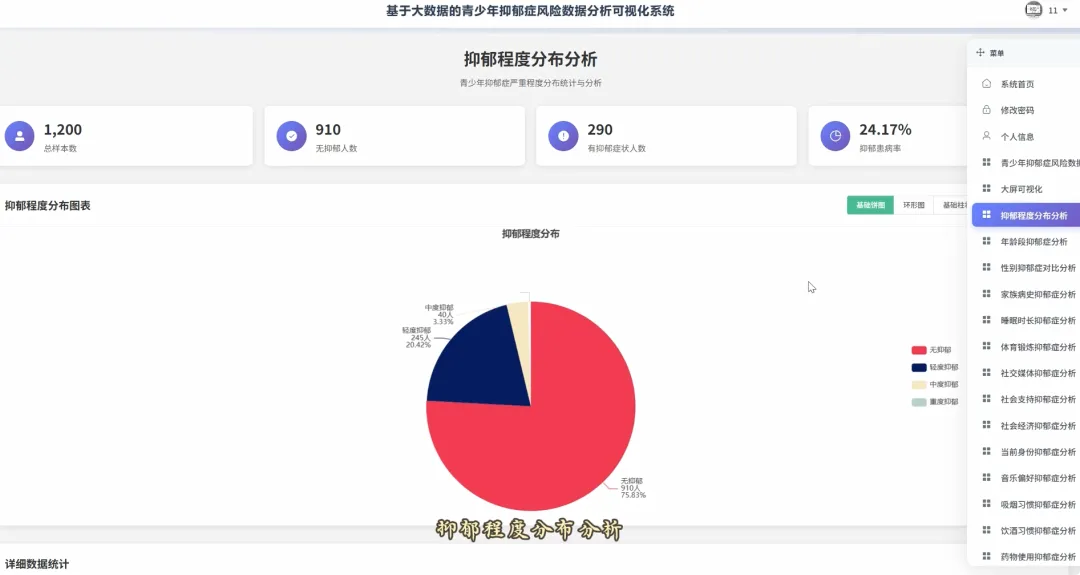
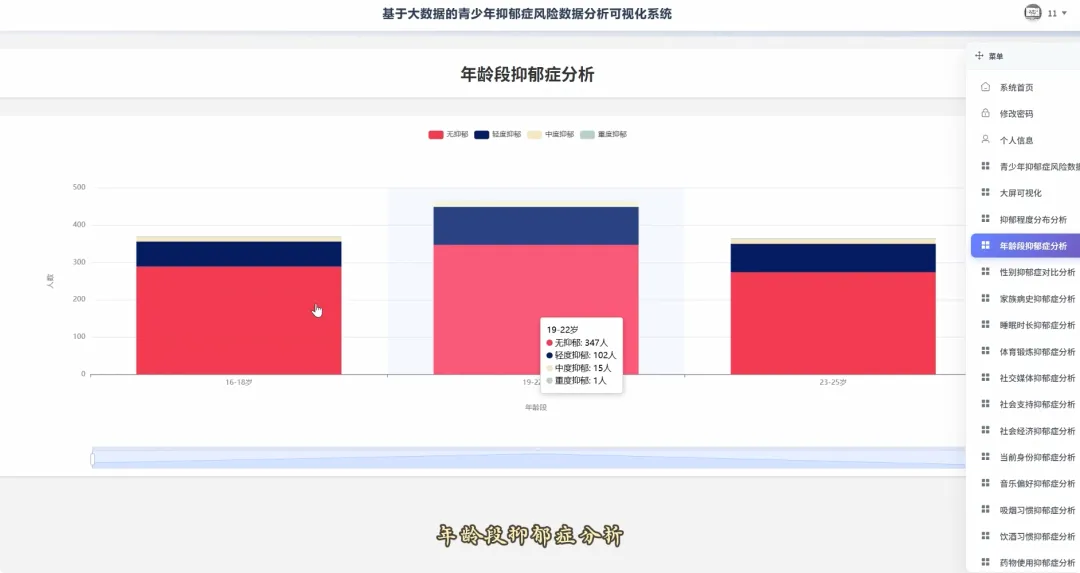
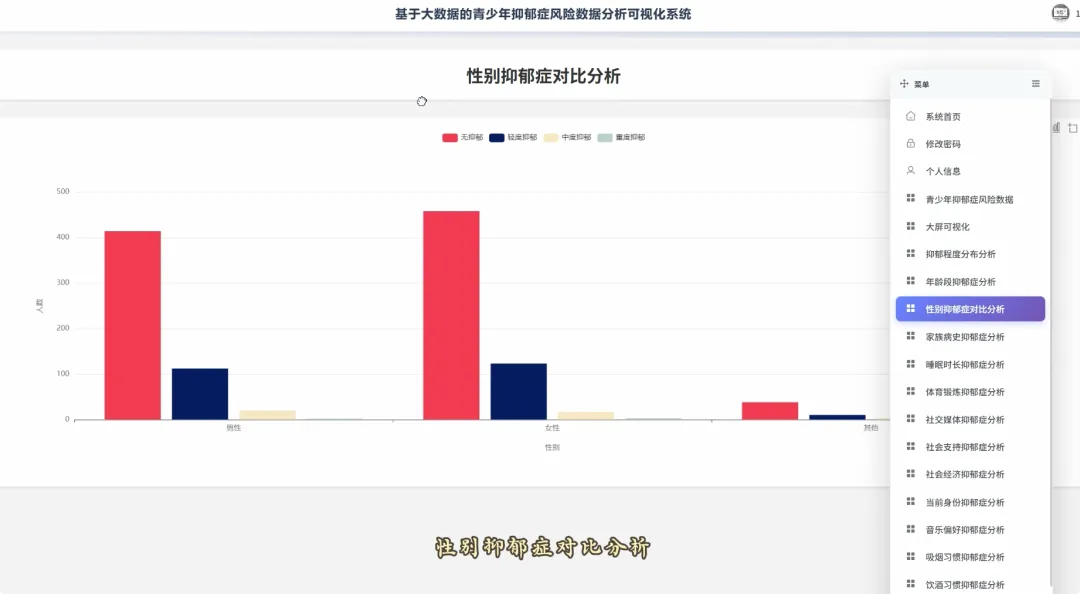
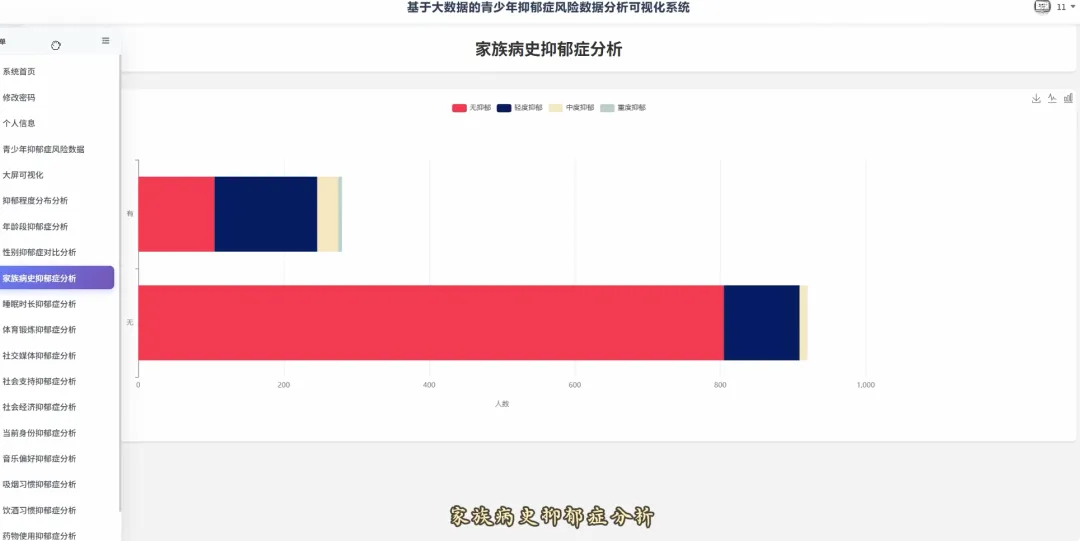
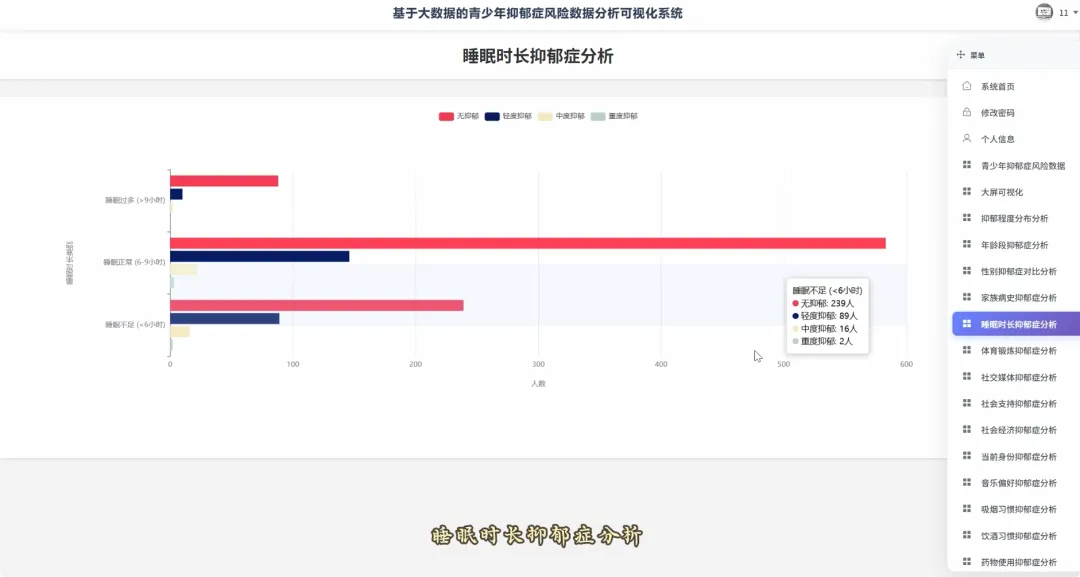
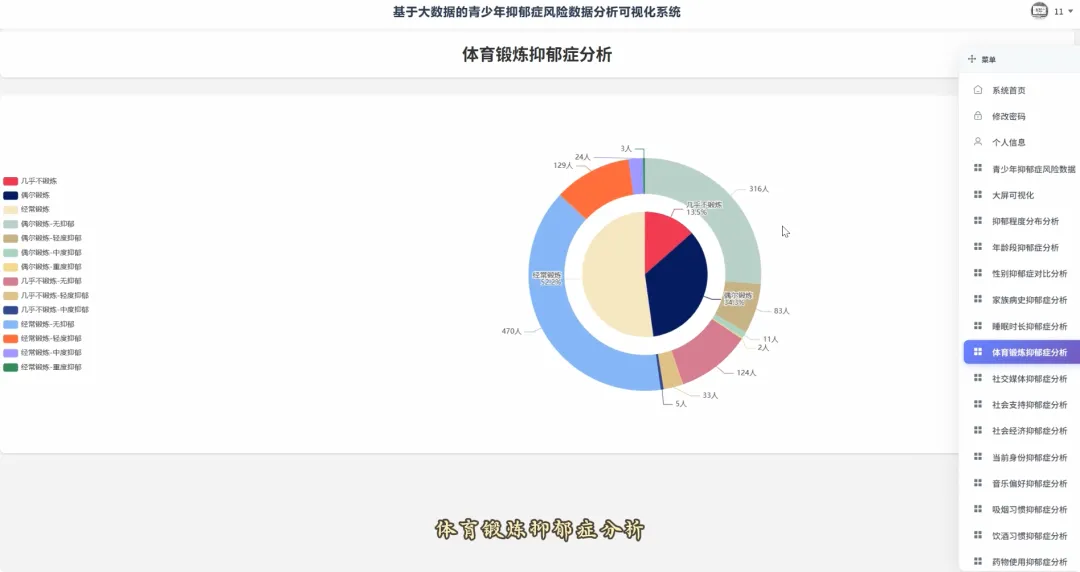
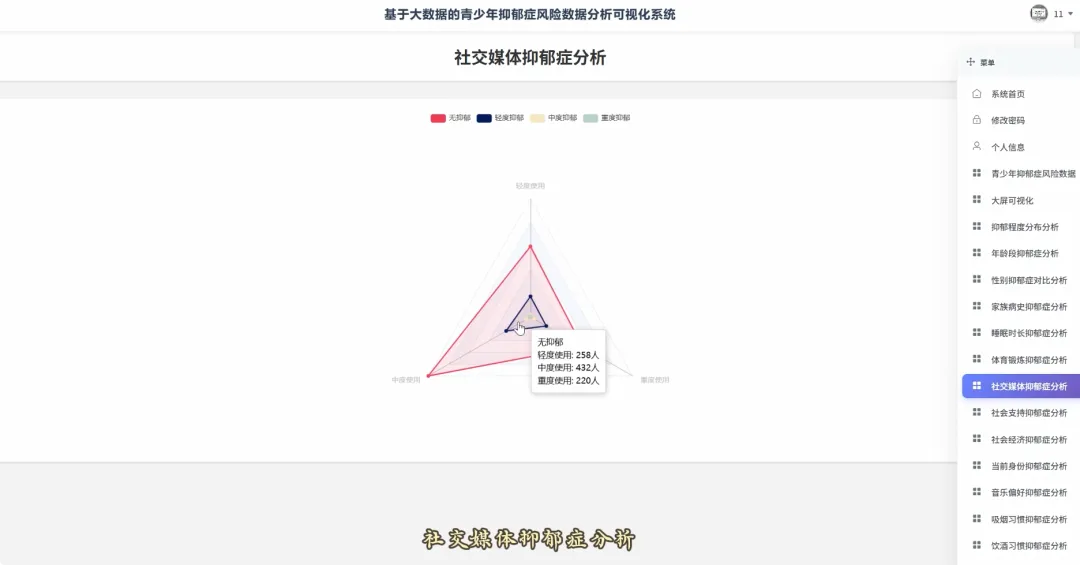
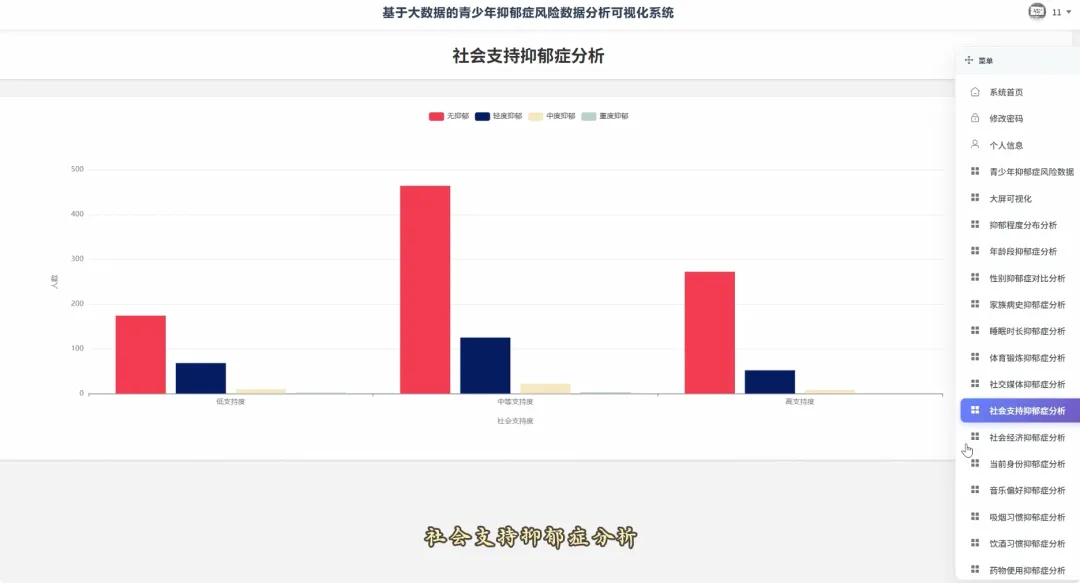
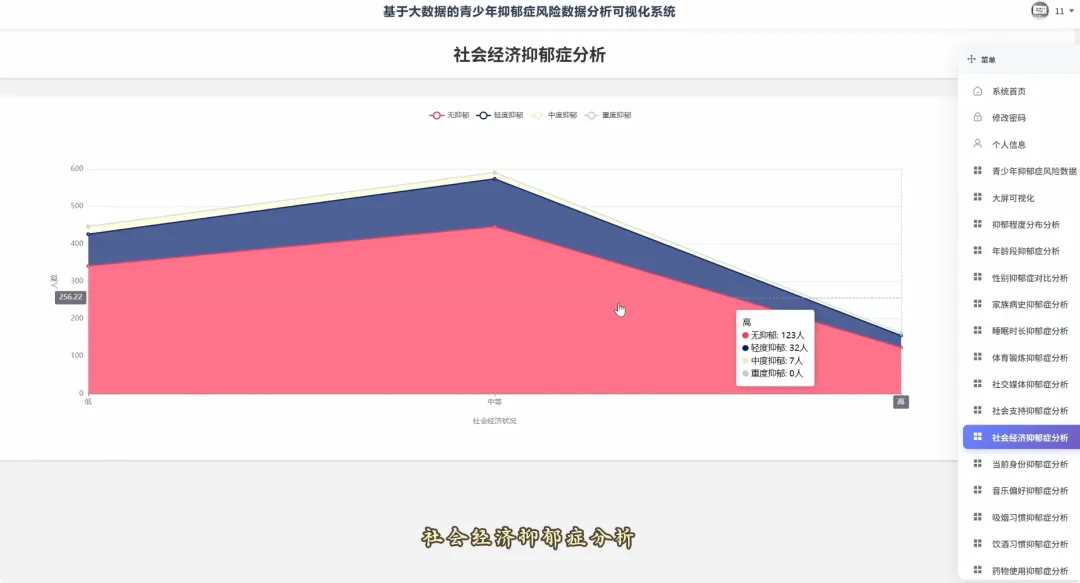
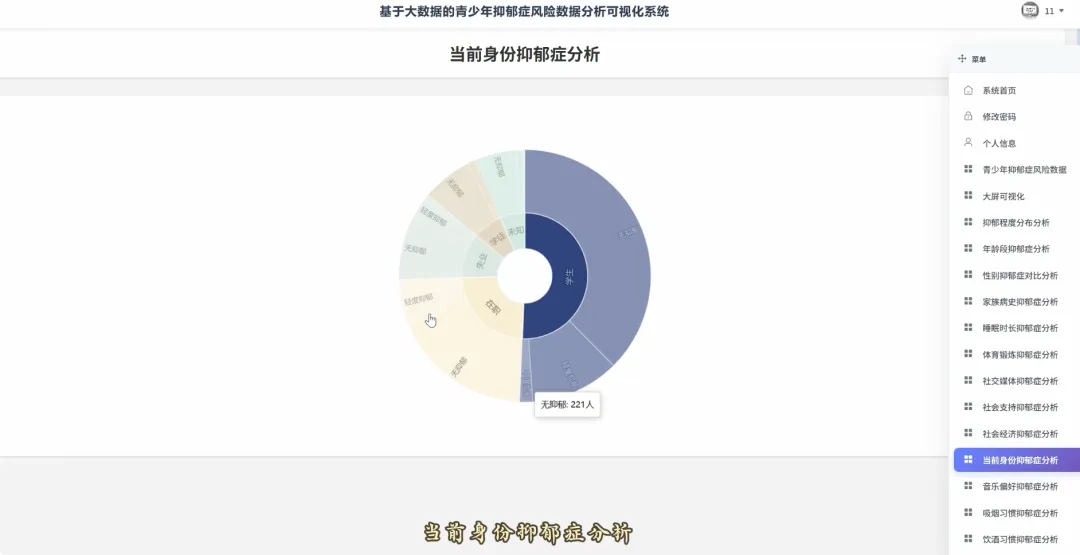
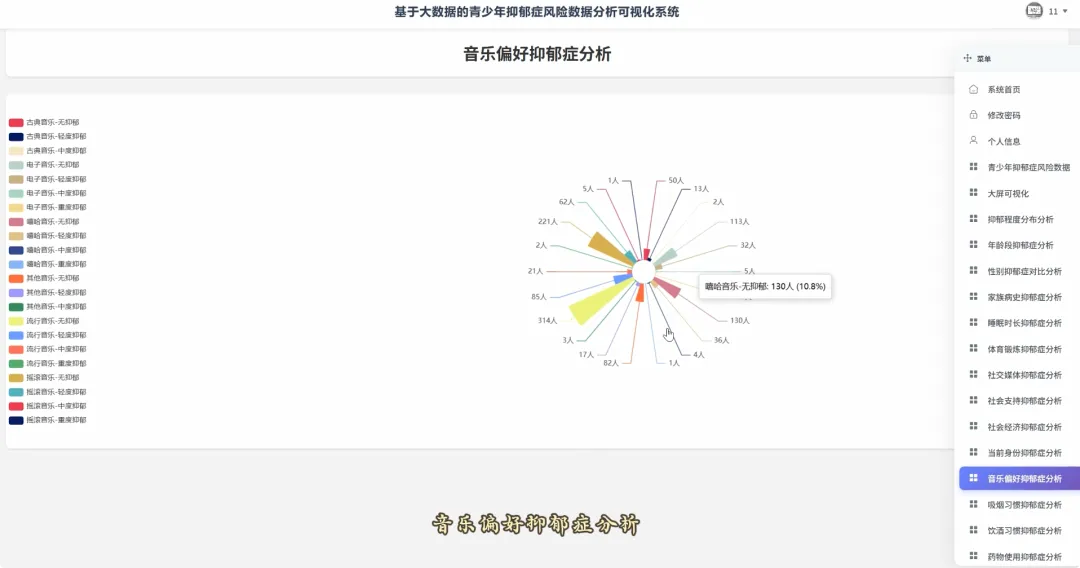
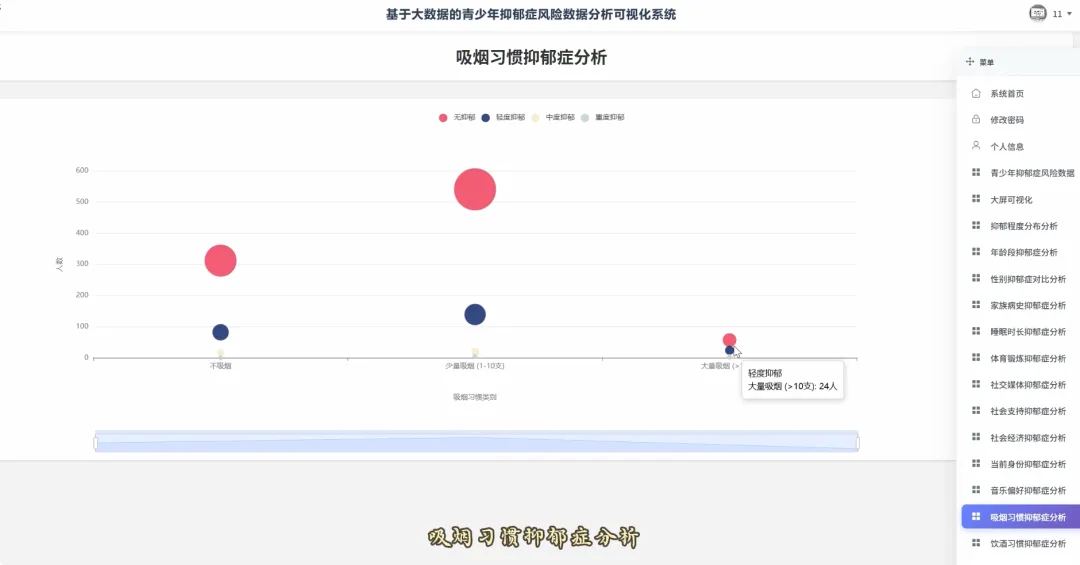
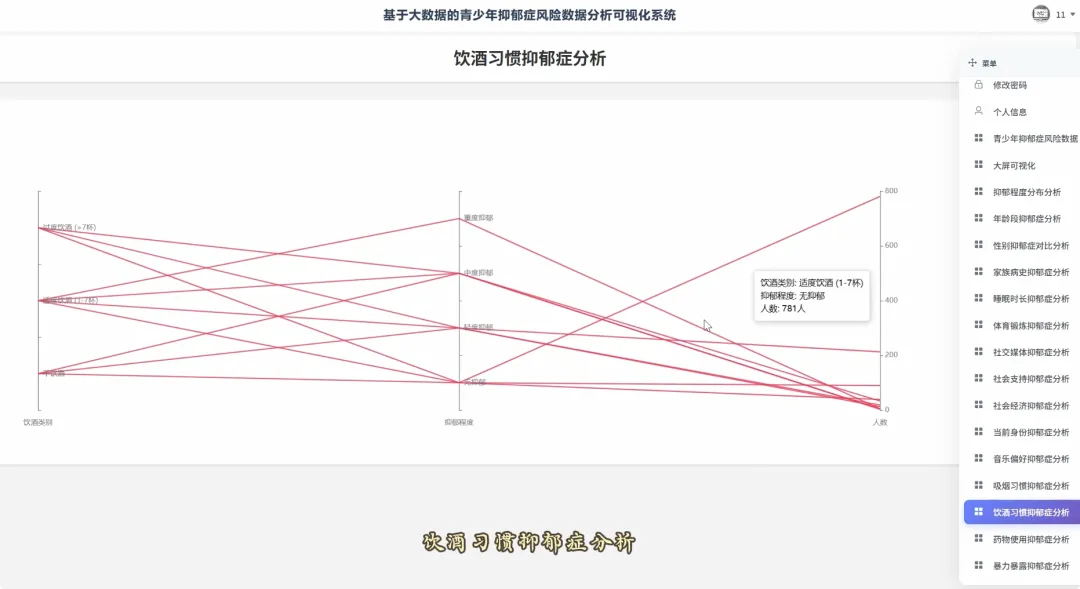
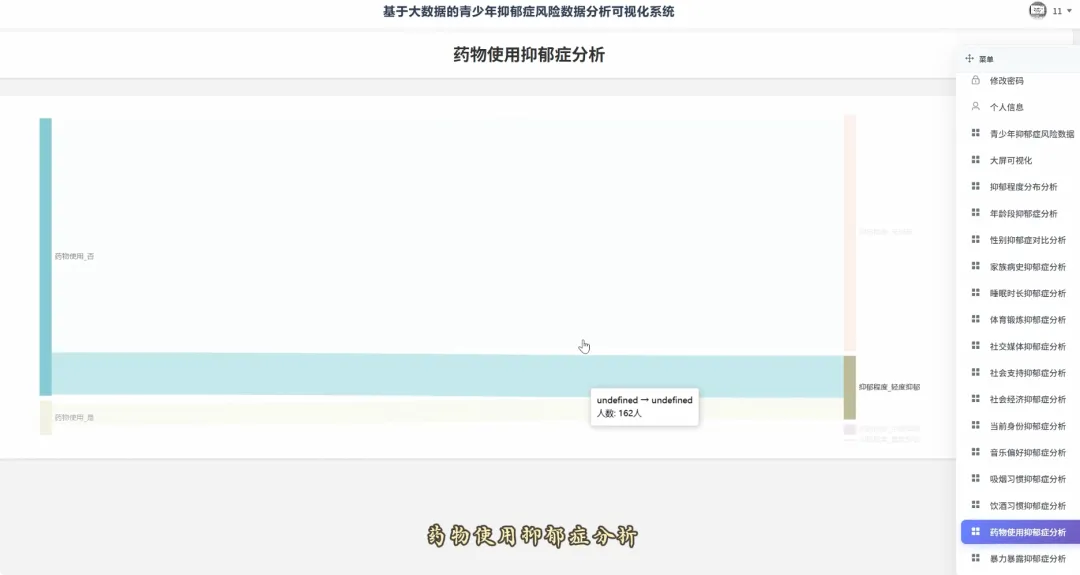
本系统是一个基于Hadoop大数据生态构建的青少年抑郁症风险数据分析可视化平台,旨在通过技术手段深入探究影响青少年心理健康的复杂因素。系统后端采用Python语言,并结合Django框架进行业务逻辑处理与接口开发,确保了开发的灵活性与高效性。核心数据处理与分析引擎依托于Hadoop的HDFS进行海量数据存储,并利用Spark进行高效的分布式计算,能够应对大规模数据集的分析挑战。通过Spark SQL及Pandas、NumPy等库,系统对包含抑郁程度、性别、年龄、社会经济状况、生活习惯(吸烟、饮酒、睡眠)、社会支持等十五个维度的数据集进行多角度的统计与关联性分析。例如,系统能够探究不同性别、年龄段的抑郁程度分布,分析生活习惯如吸烟、饮酒、睡眠时长与抑郁风险的内在联系,并评估社会支持、体育锻炼等保护性因素的作用。最终,分析结果通过MySQL数据库进行管理,并由前端Vue框架结合Echarts图表库,以动态、直观的可视化图表形式呈现,为研究青少年心理健康问题提供了全面的数据洞察与决策支持。

二

青少年抑郁症风险数据分析可视化系统-背景

选题背景

近年来,青少年群体的心理健康问题日益受到社会各界的关注。他们正处在身心发展的关键时期,面临着来自学业、人际关系、社会环境等多方面的压力。这些复杂的因素交织在一起,对他们的情绪状态和心理承受能力构成了不小的挑战。传统的观察和个案研究虽然有一定价值,但难以从宏观层面把握问题的普遍规律和潜在风险因素。因此,如何利用现代技术手段,对影响青少年心理健康的大量数据进行系统性分析,找出关键的风险点与保护性因素,成为了一个值得探索的课题,这也正是本课题的出发点。

选题意义

本课题的意义在于,它尝试搭建一个实用的数据分析工具,为关注青少年心理健康的研究者或工作者提供一个参考视角。通过这个系统,用户可以方便地查看不同维度下的抑郁风险分布情况,比如生活习惯与心理状态的关系,或者社会支持的重要性。虽然这只是一个毕业设计层面的实践,但它完整地展示了从数据采集、存储、处理到可视化分析的全过程,验证了大数据技术在社会科学领域的应用潜力。它希望能为后续更深入的研究提供一个基础的数据分析框架,也帮助同学们更好地理解和运用相关技术,解决一些实际问题。

三

青少年抑郁症风险数据分析可视化系统-技术框架

开发语言:Python+Java

后端框架大数据框架:Hadoop+Spark(本次没用Hive,支持定制)

:Django+Spring Boot(Spring+SpringMVC+Mybatis)

前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery

数据库:MySQL

四

青少年抑郁症风险数据分析可视化系统-视频展示

已关注
关注
重播 分享 赞

导师总说选题没深度?这个Hadoop抑郁症分析系统让他眼前一亮

五

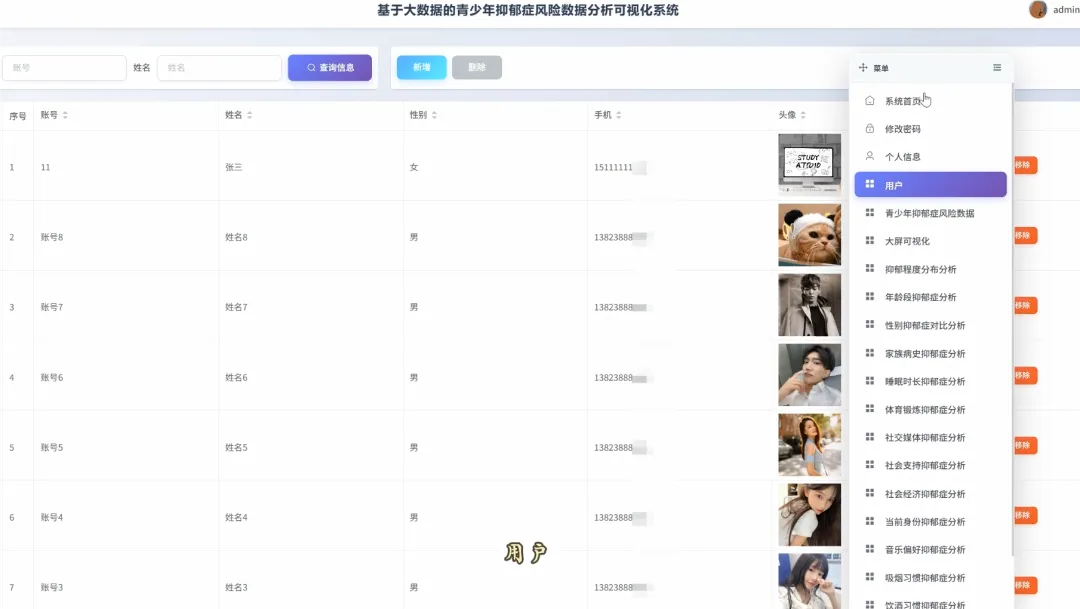
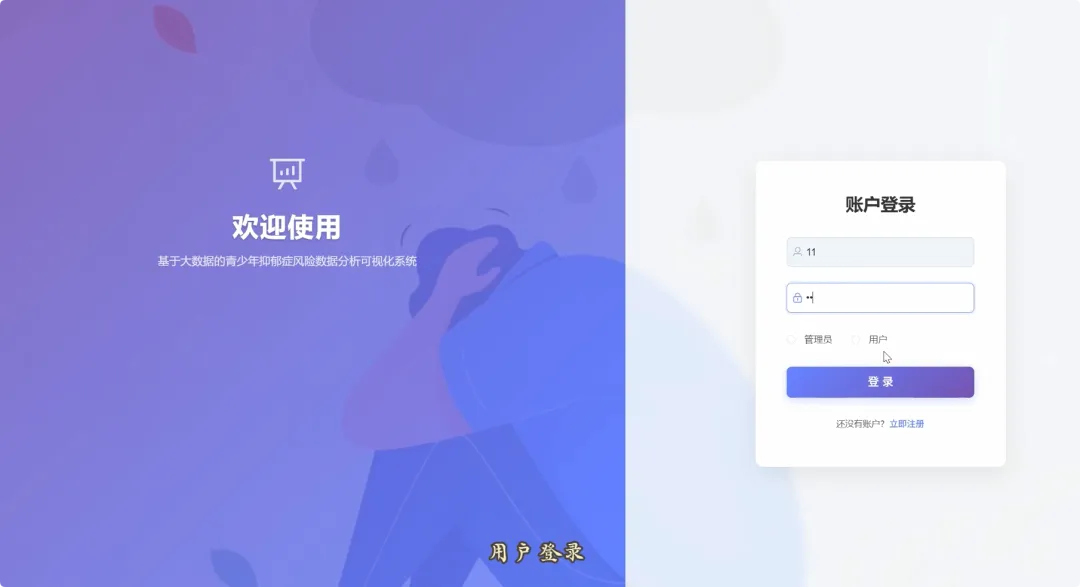
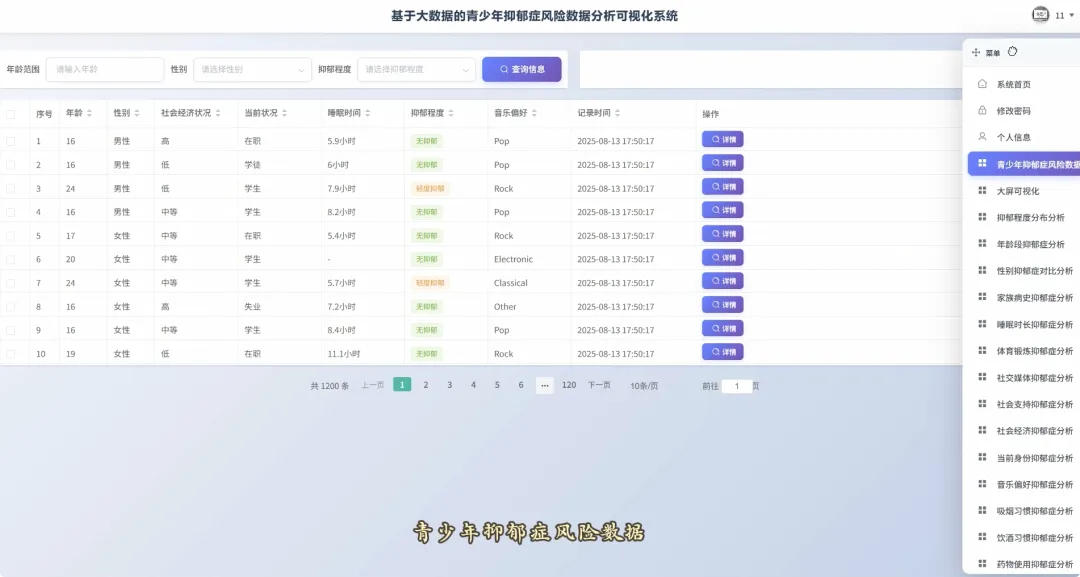
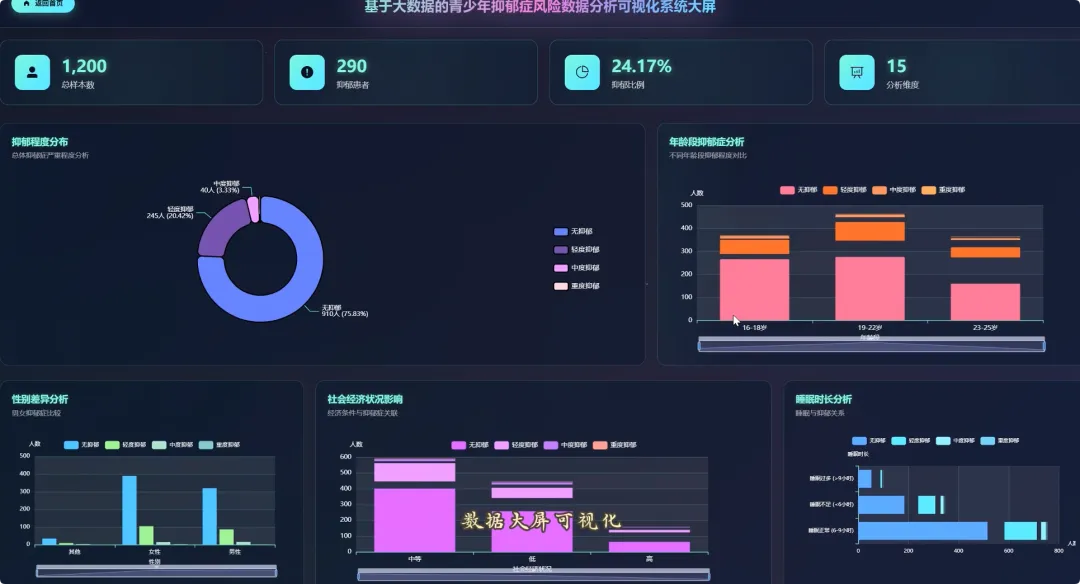
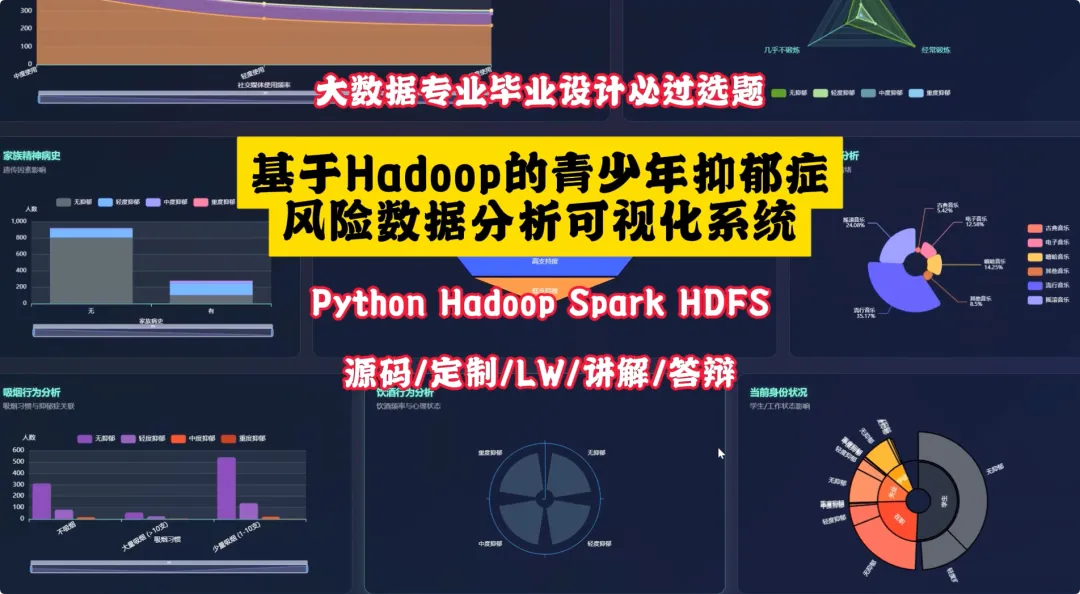
青少年抑郁症风险数据分析可视化系统-图片展示

六

青少年抑郁症风险数据分析可视化系统-代码展示

from pyspark.sql import SparkSessionspark = SparkSession.builder.appName("YouthDepressionAnalysis").getOrCreate()df = spark.read.csv("hdfs://namenode:8020/user/hadoop/depression_data.csv", header=True, inferSchema=True)def analyze_overall_depression_distribution():    global df    result_df = df.groupBy("depression_severity").count().orderBy("count", ascending=False)    data_list = [{"name": row['depression_severity'], "value": row['count']} for row in result_df.collect()]    return data_listdef analyze_gender_vs_depression():    global df    result_df = df.groupBy("gender", "depression_severity").count().orderBy("gender", "count", ascending=False)    data_list = [{"gender": row['gender'], "severity": row['depression_severity'], "count": row['count']} for row in result_df.collect()]    return data_listdef analyze_sleep_hours_vs_depression():    global df    from pyspark.sql.functions import when, col    binned_df = df.withColumn("sleep_category", when(col("sleep_hours") < 6, "睡眠不足(<6小时)").when((col("sleep_hours") >= 6) & (col("sleep_hours") <= 8), "正常睡眠(6-8小时)").otherwise("睡眠过多(>8小时)"))    result_df = binned_df.groupBy("sleep_category", "depression_severity").count().orderBy("sleep_category", "count", ascending=False)    data_list = [{"sleep": row['sleep_category'], "severity": row['depression_severity'], "count": row['count']} for row in result_df.collect()]    return data_list
七

联系我们

商务合作

关注公众号:

计算机毕设指导师

~~感谢您抽出时间来阅读此文~~

最新文章

随机文章