01 研究背景与创新点
本文分享一项前沿研究方法:使用大语言模型(LLM)驱动进化算法,自动生成网络关键节点识别函数。该方法突破传统固定中心性算法的局限,让算法本身在进化过程中不断优化。核心创新:
- • 传统方法:依赖人工预设的中心性指标(度中心性、PageRank等)
- • 本文方法:使用LLM自动生成和优化节点重要性评估函数
02 方法框架与核心思想
基本流程:
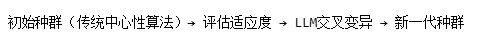
# 节点重要性评估函数统一接口defscore_nodes(adj_matrix):""" 输入: 邻接矩阵 输出: 节点重要性得分字典{节点ID: 得分} """return scored_nodes
适应度评估标准:
# 网络连通性破坏程度作为适应度fitness = 1 - (σ_after / σ_before)
其中σ(G)表示网络连通性,删除重要节点后连通性下降越多,算法越优。
03 核心代码实现
进化算法主框架
defevolve_with_llm(adj_matrix, init_codes, model, epochs=15, pop_size=12):# 初始化种群 population = []for code in init_codes: fn = safe_exec_score_nodes(code) fit = evaluate_fitness(adj_matrix, fn, remove_ratio=0.10) population.append({"code": code, "fitness": fit})# 进化循环for ep inrange(epochs): population = sorted(population, key=lambda x: x["fitness"], reverse=True) elites = population[:2] # 保留精英 children = []# 生成子代whilelen(children) + len(elites) < pop_size: parent_a = roulette_select(population) parent_b = roulette_select(population)# LLM交叉 child_code = crossover_with_llm(parent_a, parent_b, model=model)# 概率变异if random.random() < 0.35: child_code = mutate_with_llm(child_code, model=model) children.append({"code": child_code, "fitness": evaluate_fitness(...)}) population = elites + children
LLM驱动的交叉操作
defcrossover_with_llm(parent_a, parent_b, model):"""使用LLM融合两个父代函数的代码""" prompt = f""" 请将以下两个函数融合: 父代函数A:{parent_a['code']} 父代函数B: {parent_b['code']} 生成一个新的score_nodes函数。 """return llm_chat(model, prompt)
适应度评估函数
defevaluate_fitness(adj_matrix, score_fn, remove_ratio=0.2):"""评估函数:删除重要节点后的网络连通性破坏程度"""# 计算原始网络连通性 G_original = nx.from_numpy_array(adj_matrix) sigma_before = network_connectivity(G_original)# 使用算法评分并删除重要节点 scores = score_fn(adj_matrix) nodes_to_remove = sorted(scores, key=scores.get, reverse=True)[:int(remove_ratio*len(scores))]# 删除节点后计算连通性 G_removed = G_original.copy() G_removed.remove_nodes_from(nodes_to_remove) sigma_after = network_connectivity(G_removed)return1 - (sigma_after / sigma_before)
04 实验结果与发现
进化过程表现:
- • 初始种群:传统中心性算法(度中心性、PageRank等)
最终生成的优秀函数:
defscore_nodes(adj_matrix): A = np.asarray(adj_matrix) G = nx.from_numpy_array(A) pr = nx.pagerank(G, weight="weight") scored_nodes = {int(k): float(v) for k, v in pr.items()}return scored_nodes
适应度提升:
05 方法优势与应用价值
技术优势:1.自动化:减少人工设计算法的成本2.适应性:针对特定网络特性自动优化3.可解释性:生成的函数代码可读可分析4.扩展性:可融入领域知识引导进化方向
应用场景:
06 总结与展望
本文展示了一种LLM驱动算法进化的新范式,将算法设计从人工编码转向自动优化。这种方法不仅适用于节点重要性评估,还可扩展到其他网络分析任务。未来方向:
欢迎在评论区交流网络分析算法自动化的技术问题!
文献来源: Mao, Jinzhu, et al. "Identify critical nodes in complex network with large language models." arXiv preprint arXiv:2403.03962 (2024).免责声明: 本代码基于公开文献复现,因原始实现细节未完全披露或编码习惯差异,结果可能存在细微偏差,仅供参考。
代码领取方式
转发本推文到朋友圈
添加客服
发送代码编号
发送保留2小时并集齐10个点赞的截图
即可免费领取代码