超链接在 pdf 中被归类为“链接注释”(Link Annotations)。根据 pdf规范,超链接是一种特殊的注释类型,其核心结构包含定义可点击区域的矩形、指定跳转目标的 URI 或页面信息,以及可选的视觉样式。这种设计允许 pdf 阅读器识别并响应用户的点击行为。
本文基于 python 开源库 pdfplumber 来提取 pdf 中的超链接。pdfplumber 库,专门用于解析 pdf 文档,可提取 pdf 的基本信息(作者、创建时间、修改时间…)及表格、文本、图片、超链接等信息,基本可以满足所有较为简单的内容提取。pdfplumber 可直接使用 pip 命令进行安装,具体命令如下:pdfplumber 自带的 .hyperlinks 属性,专门用于获得 pdf 中的所有超链接信息,返回结果为一个字典列表。如以下代码,使用 pdfplumber 打开 test.pdf 后,采用 .hyperlinks 属性获取每一页的超链接信息。import pdfplumberwith pdfplumber.open(r'./data/test.pdf') as pdf_info: for page in pdf_info.pages: links = page.hyperlinks print(links)
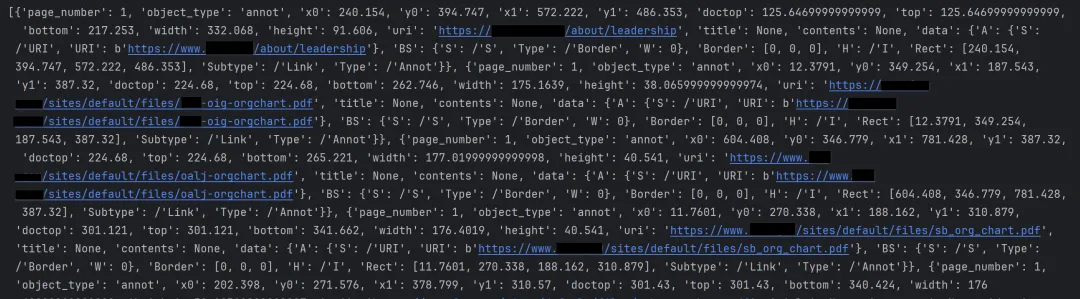
上述代码运行后,返回结果为一个字典列表,内容包含页码、URI(目标地址)等超链接信息。如下图:
然后根据需要,提取字典列表中的超链接即可。
完整代码如下,直接复制该代码,修改文件路径为自己的 pdf 完整路径,即可获取到 pdf 所有页中所有的超链接。
import pdfplumberdef get_links(file_path): res_links = [] with pdfplumber.open(file_path) as pdf_info: for page in pdf_info.pages: links = page.hyperlinks for link in links: res_link = link.get('uri') res_links.append(res_link) return res_linksif __name__=="__main__": # 将文件路径替换为自己的 pdf 完整路径即可 res_links = get_links('输入pdf的完整路径') print(res_links)
以上仅为 pdf 中超链接提取的一种方法,可供参考