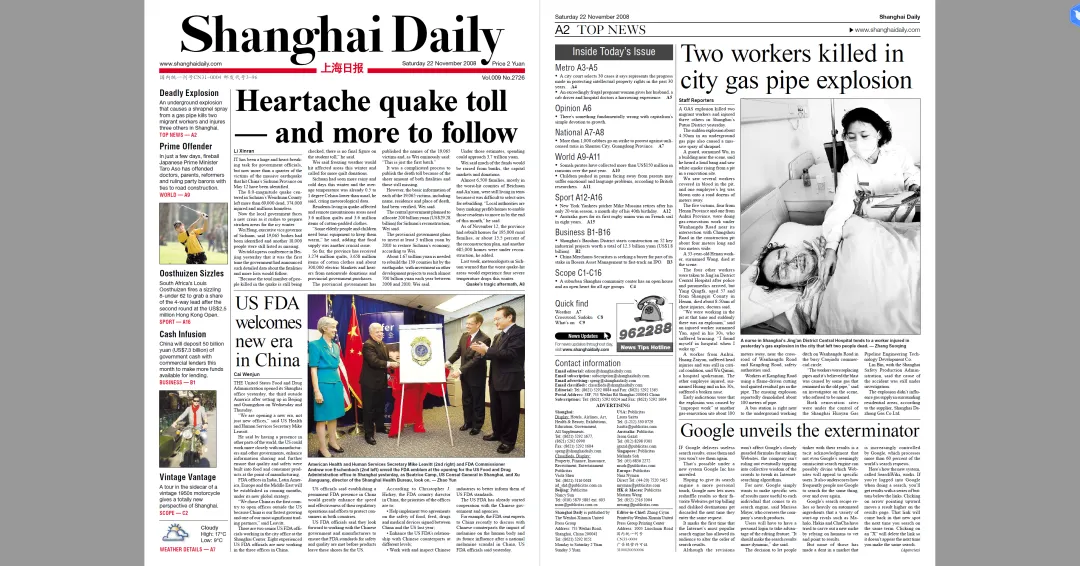
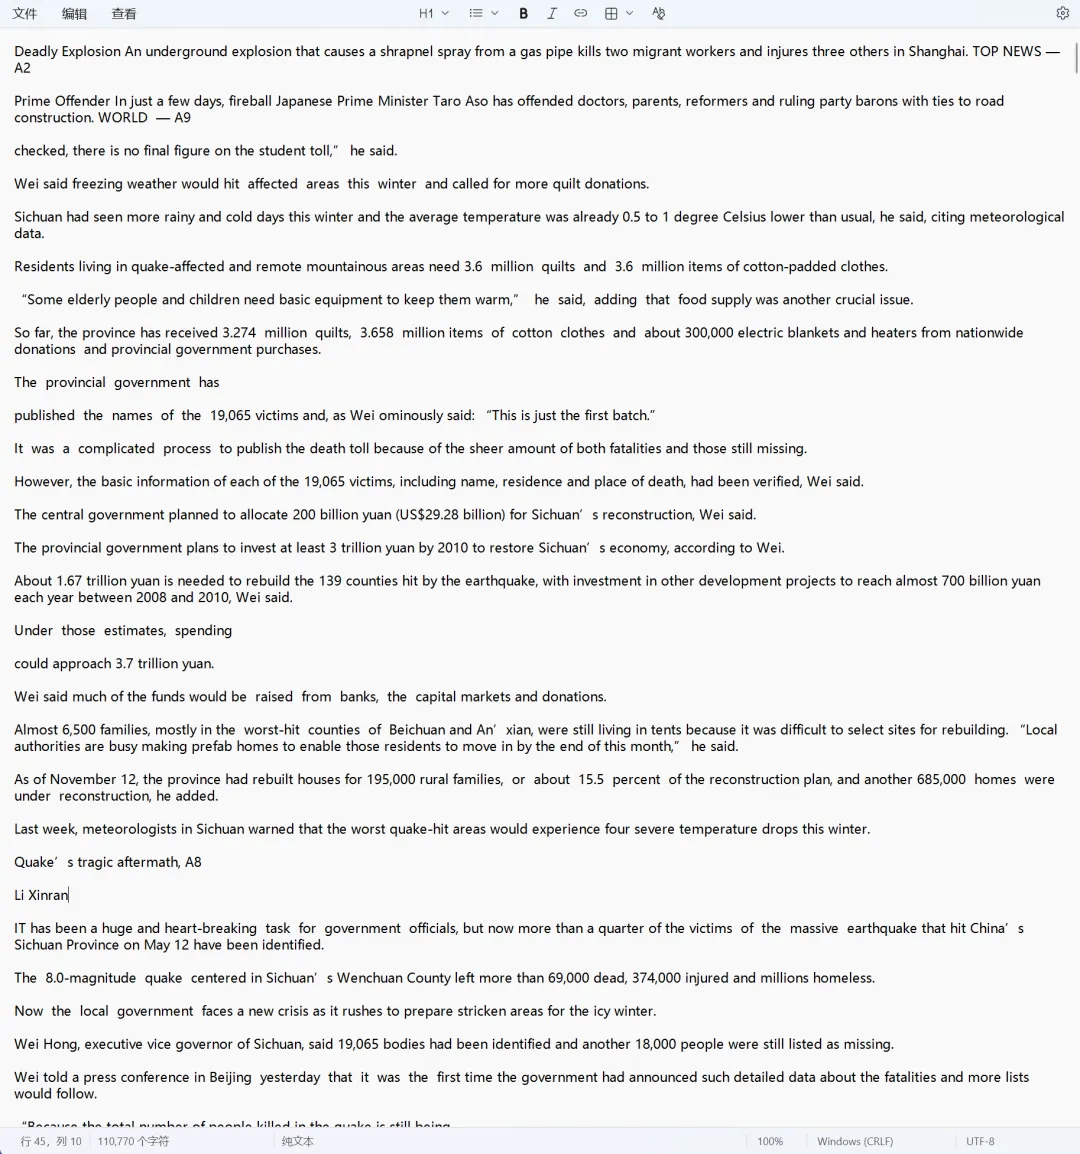
在做数字化归档或构建 AI 知识库时,最让人头疼的是**“多栏排版”**的旧资料。
想象一下:一份几十年前的旧报纸,一页纸分了三四栏。如果你用普通的提取工具,结果往往是“跨栏乱序”——左栏读一半,突然跳到了右栏。再加上烦人的报头、日期和页码干扰,提取出来的文本简直是一团乱麻。
今天分享一套基于 Python 的智能提取方案。它能像“手术刀”一样,精准切除噪音,把碎乱的旧报纸变成 AI 最喜欢的纯净文本。
核心痛点:为什么传统的提取不行?
处理这种复杂排版,主要有三个“坑”:
多栏乱序:程序如果不理解布局,提取出的文字顺序是乱的。
噪音干扰:每页顶部的日期、期号和底部的页码,如果不剔除,会严重干扰 AI 的检索质量。
断行碎句:历史文档为了对齐,经常会有强制换行或连字符(如 develop-ment),直接提取会导致语义断裂。
一、 环境准备
本工具基于 pdfminer.six 开发。请确保已安装 Python 环境,并在终端运行:
二、 完整代码实现 (batch_convert.py)
将以下代码保存为 batch_convert.py,放在 PDF 文件夹根目录下即可。
import osimport refrom pdfminer.high_level import extract_pagesfrom pdfminer.layout import LTTextContainer, LAParams# ================= 核心配置区域 =================# 1. 物理裁剪 (坐标过滤):用于切除页眉 (Header) 和页脚 (Footer)TOP_LIMIT = 0.85 # 只保留高度 85% 以下的内容BOTTOM_LIMIT = 0.10 # 只保留高度 10% 以上的内容# 2. 布局分析参数# line_margin: 行距容忍度,0.5 是处理多栏报纸的最佳实践,防止跨栏串行LAPARAMS = LAParams(line_margin=0.5, word_margin=0.1, boxes_flow=0.5)# ===========================================def is_noise_line(text): """过滤器:判断一行字是不是垃圾信息""" text = text.strip() # 1. 去掉虚拟报头元数据 (示例:VOL., NO. 等) if re.search(r'^(VOL\.|PRICE|NO\.|TRIAL NO)', text, re.IGNORECASE): return True # 2. 去掉网址 if "http://" in text or "www." in text: return True # 3. 去掉单独的页码指引 if re.match(r'^Page\s+\d+$', text, re.IGNORECASE): return True # 4. 去掉单独的日期行 if re.search(r'(Monday|Tuesday|Wednesday|Thursday|Friday|Saturday|Sunday)', text, re.IGNORECASE): if re.search(r'\d{4}', text): return True return Falsedef clean_and_merge_paragraphs(text): """重组器:将碎行拼接为完整段落""" if not text: return "" # 1. 修复连字符断词 (develop-\n ment -> development) text = re.sub(r'(\w+)-\s*[\n\r]+\s*(\w+)', r'\1\2', text) lines = text.split('\n') merged_text = "" for line in lines: line = line.strip() if not line: continue if merged_text == "": merged_text = line elif merged_text.endswith('-'): merged_text = merged_text[:-1] + line else: # 智能拼接逻辑 if merged_text[-1] not in ['.', '!', '?', '"']: merged_text += " " + line else: merged_text += " " + line return merged_textdef process_folder(folder_path): pdf_files = [f for f in os.listdir(folder_path) if f.lower().endswith(".pdf")] if not pdf_files: print("❌ 未找到 PDF 文件") return for filename in pdf_files: pdf_path = os.path.join(folder_path, filename) txt_path = os.path.splitext(pdf_path)[0] + ".txt" print(f"正在处理: {filename} ...") full_text_list = [] try: for page_layout in extract_pages(pdf_path, laparams=LAPARAMS): page_height = page_layout.height page_blocks = [] for element in page_layout: if isinstance(element, LTTextContainer): # --- 坐标过滤 --- block_y_center = (element.y0 + element.y1) / 2 relative_y = block_y_center / page_height if relative_y > TOP_LIMIT or relative_y < BOTTOM_LIMIT: continue # --- 内容清洗 --- raw_text = element.get_text() clean_lines = [line for line in raw_text.splitlines() if len(line.strip()) >= 2 and not is_noise_line(line)] if clean_lines: block_content = "\n".join(clean_lines) page_blocks.append(clean_and_merge_paragraphs(block_content)) full_text_list.append("\n\n".join(page_blocks)) with open(txt_path, "w", encoding="utf-8") as f: f.write("\n\n--- Page Break ---\n\n".join(full_text_list)) print(f"✅ 完成") except Exception as e: print(f"❌ 错误: {e}")if __name__ == "__main__": process_folder(os.getcwd()) input("按回车键退出...")
三、 使用指南
放置文件:确保脚本 batch_convert.py 与你的 PDF 文件放在同一个文件夹内。
运行脚本:
四、 高级调优手册 (Advanced Tuning)
如果你的档案排版比较特殊,可以通过修改代码顶部的参数来优化:
1. 裁剪范围调整 (Crop Limits)
用于切除页眉和页脚:
2. 垃圾信息过滤 (Noise Filter)
如果在正文中发现了反复出现的干扰信息,请修改 is_noise_line 函数。
if "咨询热线" in text: return True
五、 已知限制