使用Python进行事件驱动型量化回测(续6)
- 2026-09-02 20:31:32
在上一篇关于事件驱动回测系统的文章中,我们探讨了基础的ExecutionHandler(执行处理器)层次结构。本文将讨论如何利用Portfolio对象中先前构建的权益曲线DataFrame,评估策略在回测后的表现。
绩效指标我们在之前的文章中讨论过夏普比率。在那篇文章中,我概述了(年化)夏普比率的计算方法:
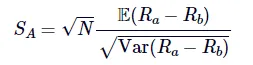
其中 Ra代表资产组合收益序列,Rb 为基准指标(如适用利率或股票指数)。
除夏普比率外,最大回撤与回撤持续时间是投资者评估组合风险的两项重要指标。前者量化了资产净值曲线从峰值到谷底的最大跌幅,后者则衡量该回撤过程持续的交易周期数。
本文将基于Python事件驱动回测框架,实现夏普比率、最大回撤及回撤持续时间的计算模块,用于量化投资组合绩效。
Python实现方案
首先创建新文件performance.py,用于存储计算夏普比率与回撤相关指标的函数。与多数计算密集型模块类似,我们需要导入NumPy和pandas库:
# performance.pyimport numpy as npimport pandas as pd
需要强调的是,夏普比率是衡量风险调整后收益的指标之一(事实上此类指标还有很多)。它包含一个关键参数——用于计算年化值的周期调整因子。
我这里以美股示例,因此将参数设定为252,对应美国市场每年的交易日数量。但如果您的策略以小时为单位进行交易,则需相应调整周期参数以实现准确年化。此时periods设定为252 *6.5 = 1638(美国市场年交易小时数)。若进行分钟级交易,则需调整为252* 6.5 *60 = 98280。
create_sharpe_ratio 函数接收名为 returns 的 pandas Series 对象作为参数,其核心计算逻辑为:将周期收益率均值除以其标准差后,再乘以周期调整因子periods进行年化处理:
# performance.pydef create_sharpe_ratio(returns, periods=252):"""Create the Sharpe ratio for the strategy, based on abenchmark of zero (i.e. no risk-free rate information).Parameters:returns - A pandas Series representing period percentage returns.periods - Daily (252), Hourly (252*6.5), Minutely(252*6.5*60) etc."""return np.sqrt(periods) * (np.mean(returns)) / np.std(returns)
夏普比率衡量的是每单位收益所承担的风险(以资产路径标准差定义),而“回撤”则被定义为资产净值曲线中从峰值到谷底的最大跌幅。
下文中的 create_drawdowns 函数将同时计算最大回撤值和最长回撤持续时间。前者即上述的最大峰谷跌幅,后者则指该跌幅持续出现的交易周期数。
需注意回撤持续时间的解读存在一定复杂性:由于它统计的是交易周期数,不能直接转换为“天数”等时间单位。
该函数的实现逻辑如下:首先创建两个 pandas Series 对象,分别记录每个交易时点的回撤幅度和持续周期数。然后通过判断当前净值是否超越历史峰值来动态更新“高水位线” (HWM) 。
回撤幅度即为当前高水位线与净值曲线的差值。当该差值为负时(即净值低于高水位线),回撤持续时间开始累积计数,直至净值突破新高形成新的高水位线。函数最终返回两个序列中的最大值:
# performance.pydef create_drawdowns(equity_curve):"""Calculate the largest peak-to-trough drawdown of the PnL curveas well as the duration of the drawdown. Requires that thepnl_returns is a pandas Series.Parameters:pnl - A pandas Series representing period percentage returns.Returns:drawdown, duration - Highest peak-to-trough drawdown and duration."""# Calculate the cumulative returns curve# and set up the High Water Mark# Then create the drawdown and duration serieshwm = [0]eq_idx = equity_curve.indexdrawdown = pd.Series(index = eq_idx, dtype=float)duration = pd.Series(index = eq_idx, dtype=float)# Loop over the index rangefor t in range(1, len(eq_idx)):cur_hwm = max(hwm[t-1], equity_curve[t])hwm.append(cur_hwm)drawdown[t]= hwm[t] - equity_curve[t]duration[t]= 0 if drawdown[t] == 0 else duration[t-1] + 1return drawdown.max(), duration.max()
要运用这些绩效指标,我们需要在完成回测后——即获得有效的资产净值曲线时——进行计算。
同时还需将这些计算与特定的对象层次结构关联。鉴于绩效指标是基于投资组合层面计算的,将其附加到我们在前文中讨论过的 Portfolio类层次结构的某个方法上是合理的选择。
首先,如前一篇文章所述,打开portfolio.py文件并导入绩效计算函数:
# portfolio.py.. # Other importsfrom performance import create_sharpe_ratio, create_drawdowns
由于Portfolio是抽象基类,我们需要将相关方法添加至其派生类中。这里以NaivePortfolio为例,我们将创建一个名为output_summary_stats的方法,该方法基于投资组合的资产净值曲线生成夏普比率和回撤信息。
该方法的实现较为直接:它直接调用两个绩效计算函数,对资产净值曲线的pandas DataFrame进行处理,并以格式清晰的元组列表形式输出统计结果:
# portfolio.py....class NaivePortfolio(object):....def output_summary_stats(self):"""Creates a list of summary statistics for the portfolio suchas Sharpe Ratio and drawdown information."""total_return = self.equity_curve['equity_curve'][-1]returns = self.equity_curve['returns']pnl = self.equity_curve['equity_curve']sharpe_ratio = create_sharpe_ratio(returns)max_dd, dd_duration = create_drawdowns(pnl)stats = [("Total Return", "%0.2f%%" % ((total_return - 1.0) * 100.0)),("Sharpe Ratio", "%0.2f" % sharpe_ratio),("Max Drawdown", "%0.2f%%" % (max_dd * 100.0)),("Drawdown Duration", "%d" % dd_duration)]return stats
显而易见,这仅是投资组合绩效分析的基础实现。它尚未涵盖交易层面的深入分析,也未纳入其他风险收益衡量指标。不过,我们可以通过在performance.py中添加更多分析方法,并根据需要将其整合到output_summary_stats中,轻松扩展这一功能。
