在企业财务数字化场景中,Python 已经成为连接业务系统数据库、构建财务分析模型、实现自动化报表的重要工具。
本文基于:* pandas* pymysql* matplotlib* seaborn构建一套完整的:
数据库读取 → 财务指标计算 → 可视化分析 → 风险建模 的技术流程
本文重点讲解代码实现逻辑与财务计算原理。
最终的数据分析全部源代码:
一、数据库连接与数据读取
1️⃣ 数据库连接配置
db_config = {
'host': 'localhost',
'user': 'root',
'password': 'root',
'database': 'cwfx2026',
'port': 3306,
'charset': 'utf8mb4'
}
charset=utf8mb4 解决中文字段乱码问题
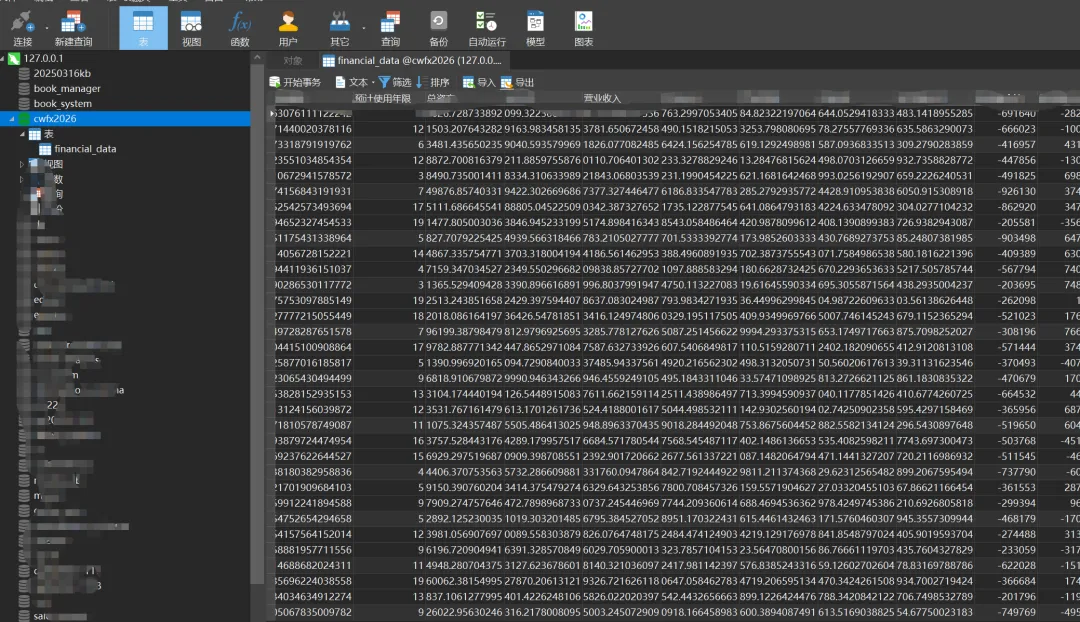
2️⃣ 从数据库读取数据
conn = pymysql.connect(**db_config)
df = pd.read_sql("SELECT * FROM financial_data", conn)
conn.close()
关键技术解释
① 为什么使用 pd.read_sql?
read_sql 可以直接将 SQL 查询结果转为 DataFrame:
这一步实现了:
数据库 → 数据分析引擎 的桥接
二、应收账款账龄结构分析
1️⃣ 账龄分组
bins = [0, 30, 90, 180, 365]
labels = ['1-30天', '31-90天', '91-180天', '180天以上']

df["账龄区间"] = pd.cut(df["账龄天"], bins=bins, labels=labels)
pd.cut() 用于连续变量离散化:
2️⃣ 汇总金额
age_sum = df.groupby("账龄区间")["应收账款"].sum()
核心逻辑
3️⃣ 可视化
sns.barplot(x=age_sum.index, y=age_sum.values)
条形图适合结构类指标展示。
三、收入成本回归分析
1️⃣ 绘制回归图
sns.regplot(
    data=df,
    x="营业收入",
    y="营业成本",
    scatter_kws={'alpha':0.3},
    line_kws={'color':'red'}
)
参数讲解
技术逻辑
四、资产负债率分析
1️⃣ 指标计算
df["资产负债率"] = df["总负债"] / df["总资产"]
技术说明
这比 Excel 高效数百倍。
2️⃣ 分布分析
sns.histplot(df["资产负债率"], kde=True)
plt.axvline(0.7, linestyle='--')
细节
五、盈利能力分析(ROA / ROE)
1️⃣ 构造中间变量
df["所有者权益"] = df["总资产"] - df["总负债"]
在财务系统中:
所有者权益通常不会直接存储,而是通过资产负债表自动计算
2️⃣ 计算指标
df["ROA"] = df["净利润"] / df["总资产"]
df["ROE"] = df["净利润"] / df["所有者权益"]
技术优势
3️⃣ 数据结构转换(Melt)
metrics = df[['ROA', 'ROE']].melt()
为什么使用 melt()?
Seaborn 需要“长表结构”:
melt() 将宽表转成长表。
六、投资决策模型
1️⃣ NPV 计算
npv = sum(cf / (1 + discount_rate)**i
for i, cf in enumerate(cash_flows))
技术解析
2️⃣ 盈亏平衡点
be_point = fixed_cost / (price - variable_cost)
工程意义:
七、杜邦分析(标准三层结构)
1️⃣ 指标拆解
df["净利率"] = df["净利润"] / df["营业收入"]
df["总资产周转率"] = df["营业收入"] / df["总资产"]
df["权益乘数"] = df["总资产"] / df["所有者权益"]
2️⃣ ROE 重构
df["ROE_杜邦"] = (
    df["净利率"] *
    df["总资产周转率"] *
    df["权益乘数"]
)
技术亮点
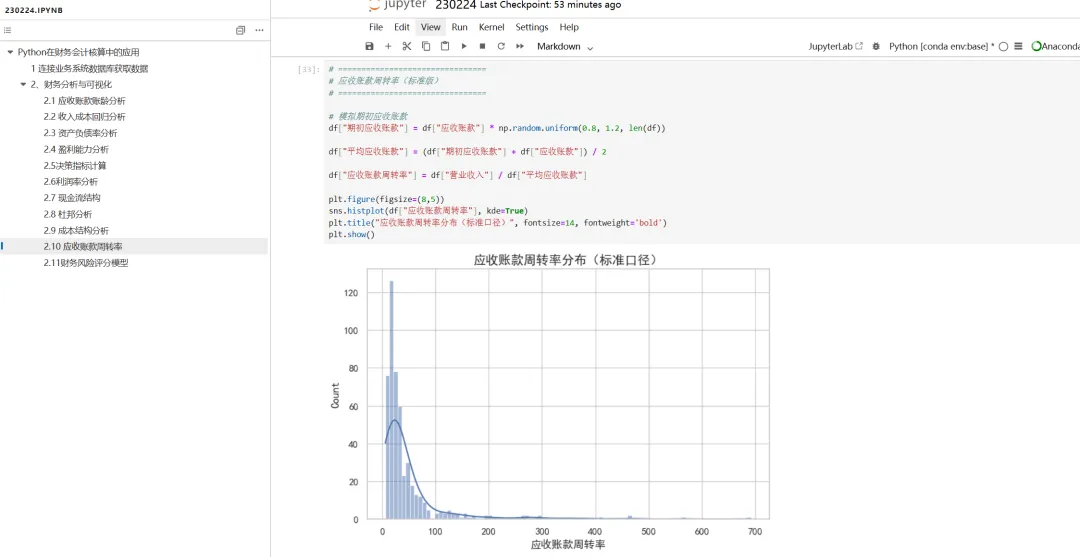
八、应收账款周转率
1️⃣ 构造平均值
df["平均应收账款"] = (
    df["期初应收账款"] + df["应收账款"]
) / 2
2️⃣ 计算周转率
df["应收账款周转率"] = (
    df["营业收入"] / df["平均应收账款"]
)
这是企业营运效率核心指标之一。
九、财务风险评分模型(规则引擎版)
1️⃣ 初始化评分
df["风险评分"] = 0
2️⃣ 条件加分
df.loc[df["资产负债率"] > 0.7, "风险评分"] += 1
df.loc[df["流动比率"] < 1, "风险评分"] += 1
df.loc[df["净利率"] < 0.05, "风险评分"] += 1
df.loc[df["经营现金流"] < 0, "风险评分"] += 1
技术核心
3️⃣ 风险等级分类
df["风险等级"] = df["风险评分"].apply(
lambda x: "高风险"if x >= 2else"正常"
)
🔮 获取和交流
需要源码和数据的同学,关注+三连,评论“6666“,加下面微信,发你!也可以拉你进群交流学习,加群备注:IT小本本学习
为了能随时获取最新动态,大家可以动动小手将公众号添加到“星标⭐”哦,点赞 + 关注,用时不迷路!!!!
关注公众号:IT小本本 👇
 10个月宝宝每天需要喝多少奶粉?