500 张参赛图手动判原创?1 个 Python 脚本搞定!县级小发明评选效率飙升 90%
- 2026-09-03 12:26:22
导语:谁懂啊!手动检测原创,累到怀疑人生…
作为县级小发明、小制作评选的工作人员,你是不是也遇到过这样的崩溃时刻?
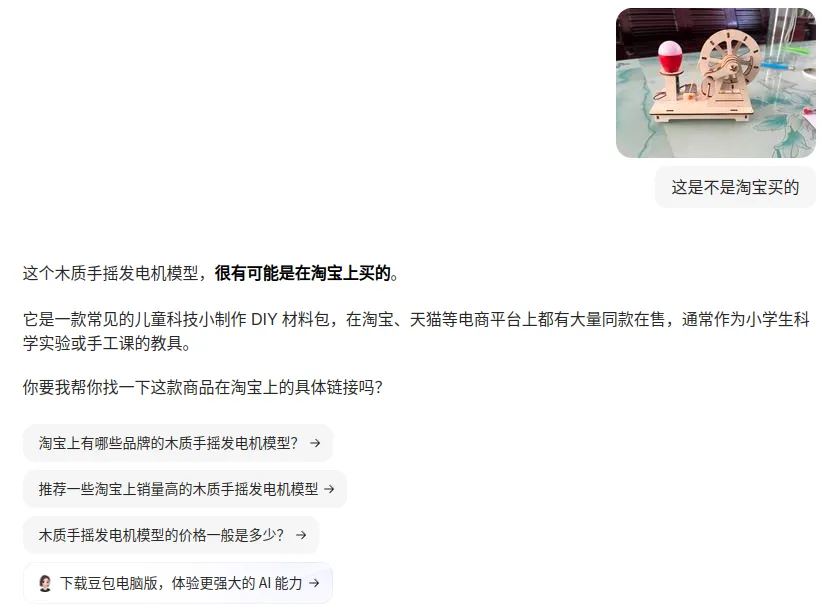
- 参赛图片堆成山,500 张 JPG/PNG 要逐张上传;
- 每张都要手动输入 “这是不是淘宝买的” 指令;
- 盯着屏幕逐一记录结果,眼睛酸、手抽筋,还容易漏判;
- 一整天下来,啥也没干就光跟图片 “较劲”,评选进度慢到离谱!
手动检测原创性,不仅耗时耗力,还可能因为疲劳导致判断失误,影响评选公平性。难道就没有更高效的方法吗?
答案是:当然有!今天给大家分享一个 “神器”——Python 自动化脚本,让 500 张参赛图的原创性检测,从 “一整天” 压缩到 “半小时”,全程自动运行,结果自动存档,彻底解放你的双手!
一、先看效果:自动化 vs 手动,差距一目了然
操作方式 | 500 张图耗时 | 操作步骤 | 出错率 |
手动上传 | 8-10 小时 | 打开页面→上传图片→输入指令→复制结果→记录存档 | 15%+(疲劳漏看) |
Python 脚本 | 30-60 分钟 | 运行脚本→等待结果→查看 CSV | <1%(程序自动处理) |
关键优势:
✅ 无需逐张上传:脚本自动读取文件夹内所有图片;
✅ 无需重复输入指令:预设 “是否淘宝购买” 判断逻辑;
✅ 无需手动记录:结果自动保存为 CSV,含选手编号、判断结果、理由;
✅ 支持批量 500 张:一次运行搞定,还能按选手编号排序。
二、核心原理:Python 脚本到底在帮你做什么?
这个自动化脚本就像一个 “智能助手”,全程模拟人工操作,还比人更高效:
- 自动找图片:精准读取 D 盘 “参赛图片” 文件夹,只筛选 JPG/PNG 格式,自动提取选手编号(如 001、212);
- 自动转格式:把图片转为 API 可识别的 Base64 编码,兼容所有参赛图片格式;
- 自动发请求:调用豆包 API,批量上传图片 + 发送判断指令,无需人工干预;
- 自动收结果:接收豆包返回的 “是 / 否 / 无法判断” 结果 + 理由,自动按选手编号排序;
- 自动存档案:把所有结果保存为 CSV 文件,打开就能直接用于评选审核。
三、3 步上手:零基础也能搞定的实操指南
不用懂复杂编程,跟着步骤走,5 分钟就能搭建好自动化工具!
第一步:准备工作(5 分钟)
- 安装必备工具:电脑上已安装 Python(建议 3.8 以上版本,官网可下);
- 安装依赖库:打开 “命令提示符”(Win+R 输入 cmd),复制粘贴以下代码,按回车:
- 获取 API 密钥:
- 打开【豆包开放平台】(https://www.doubao.com/platform),注册账号并创建应用;
- 应用创建后,在 “密钥管理” 中找到「API_KEY」和「API_SECRET」,复制保存好(后续要用)。
第二步:配置脚本(3 分钟)
- 新建一个文本文件,把下面的完整代码复制粘贴进去;
- 按自己的需求修改 3 个关键配置(其他不用动!):
- FOLDER_PATH = r"D:\参赛图片":确认图片文件夹路径是否正确;
- 运行脚本后,会自动生成「.env」文件,打开后填写 API 密钥:
- 把文本文件的后缀名改为「.py」(比如「原创性检测脚本.py」),保存到电脑桌面。
第三步:运行脚本(1 分钟)
- 确保所有参赛图片都已放在「D:\ 参赛图片」文件夹,且图片命名为选手编号(如 001.jpg、212.png);
- 双击运行「原创性检测脚本.py」,或打开命令提示符,输入以下代码运行:
- 等待脚本运行完成(500 张图约 30 分钟),桌面会生成「原创性检测结果.csv」文件;
- 打开 CSV 文件,就能看到所有选手的编号、判断结果(是 / 否 / 无法判断)和详细理由,直接用于评选审核!
四、核心代码:
from dotenv import load_dotenv
# 加载环境变量(密钥存在.env文件,安全不泄露)
load_dotenv()
API_KEY = os.getenv("DOUBAO_API_KEY")
API_SECRET = os.getenv("DOUBAO_API_SECRET")
# 核心配置(按实际情况修改这3行!)
FOLDER_PATH = r"D:\参赛图片"# 图片文件夹路径
RESULT_FILE = "原创性检测结果.csv"# 结果保存文件名
BATCH_SIZE = 500# 单次批量处理数量(最多500张)
defget_access_token():
"""自动获取API访问令牌(有效期24小时)"""
url = "https://open.doubao.com/oauth/2.0/token"
params = {
"grant_type": "client_credentials",
"client_id": API_KEY,
"client_secret": API_SECRET
}
try:
response = requests.get(url, params=params, timeout=30)
response.raise_for_status()
return response.json().get("access_token")
except Exception as e:
五、使用注意事项(避坑指南)
- 密钥安全:不要把 API_KEY 和 API_SECRET 直接写在脚本里,.env 文件要妥善保存;
- 图片要求:必须以选手编号命名(如 001.jpg、212.png),仅支持 JPG/PNG 格式;
- 限流处理:脚本已设置 0.5 秒间隔,若仍提示限流,可把time.sleep(0.5)改为time.sleep(1);
- 结果查看:CSV 文件可用 Excel 打开,“判断结果” 列直接筛选 “是”“否”,快速筛选非原创作品;
- 模型选择:默认使用doubao-pro模型,若需更精准结果,可在开放平台替换为其他模型(如doubao-max)。
结语:让技术为评选赋能,告别重复劳动!
县级小发明、小制作评选的核心是 “公平公正”,而 Python 自动化脚本不仅能帮你节省 90% 的时间,还能减少人工操作的失误,让你把更多精力放在作品本身的创意和价值上。
不用懂复杂编程,复制脚本、填写密钥、运行即可!500 张图片的原创性检测,从此不再是难题~
如果运行中遇到问题,欢迎在评论区留言,我们一起交流解决!
#Python 自动化 #评选工作效率 #原创性检测 #小发明评选
import os
import base64
import csv
import time
import requests
from dotenv import load_dotenv
# 加载环境变量(建议把密钥存在.env文件,避免硬编码)
load_dotenv()
API_KEY = os.getenv("DOUBAO_API_KEY")
API_SECRET = os.getenv("DOUBAO_API_SECRET")
# 配置项(根据你的实际情况修改)
FOLDER_PATH = r"D:\参赛图片" # 图片文件夹路径
RESULT_FILE = "原创性检测结果.csv" # 结果保存文件
BATCH_SIZE = 500 # 单次批量处理数量
TIMEOUT = 30 # 请求超时时间(秒)
RETRY_TIMES = 2 # 失败重试次数
def get_access_token():
"""获取豆包API的访问令牌(有效期通常24小时)"""
url = "https://open.doubao.com/oauth/2.0/token"
params = {
"grant_type": "client_credentials",
"client_id": API_KEY,
"client_secret": API_SECRET
}
try:
response = requests.get(url, params=params, timeout=TIMEOUT)
response.raise_for_status()
token_data = response.json()
return token_data.get("access_token")
except Exception as e:
print(f"获取令牌失败:{e}")
return None
def image_to_base64(image_path):
"""将图片转为Base64编码"""
try:
with open(image_path, "rb") as f:
base64_data = base64.b64encode(f.read()).decode("utf-8")
return base64_data
except Exception as e:
print(f"图片{image_path}转Base64失败:{e}")
return None
def check_originality(token, image_base64, player_id):
"""调用豆包API判断图片是否为淘宝购买(原创性检测)"""
url = "https://open.doubao.com/api/v1/chat/completions"
headers = {
"Authorization": f"Bearer {token}",
"Content-Type": "application/json"
}
# 构造请求体:传入图片和判断指令
data = {
"model": "doubao-pro", # 豆包专业版模型,也可根据需求换其他模型
"messages": [
{
"role": "user",
"content": [
{
"type": "text",
"text": "这是县级小发明小制作评选的参赛作品图片,请判断这个作品是不是从淘宝上购买的,仅回答「是」「否」或「无法判断」,并简要说明理由(不超过50字)。"
},
{
"type": "image_url",
"image_url": {
"url": f"data:image/jpeg;base64,{image_base64}" # 兼容jpg/png
}
}
]
}
],
"temperature": 0.1, # 降低随机性,让回答更稳定
"max_tokens": 200 # 限制回答长度
}
# 失败重试逻辑
for i in range(RETRY_TIMES + 1):
try:
response = requests.post(url, headers=headers, json=data, timeout=TIMEOUT)
response.raise_for_status()
result = response.json()
answer = result["choices"][0]["message"]["content"].strip()
return {
"选手编号": player_id,
"判断结果": answer.split(",")[0] if "," in answer else answer,
"理由": answer.split(",")[1] if "," in answer else "无"
}
except Exception as e:
print(f"第{i+1}次调用API失败(选手{player_id}):{e}")
if i == RETRY_TIMES:
return {"选手编号": player_id, "判断结果": "调用失败", "理由": str(e)}
time.sleep(1) # 重试前等待1秒
return {"选手编号": player_id, "判断结果": "调用失败", "理由": "重试次数用尽"}
def batch_process_images():
"""批量处理图片并检测原创性"""
# 1. 获取访问令牌
token = get_access_token()
if not token:
print("获取令牌失败,程序终止")
return
# 2. 遍历文件夹,筛选图片文件
image_files = []
for filename in os.listdir(FOLDER_PATH):
if filename.lower().endswith((".jpg", ".png")):
# 提取选手编号(去掉后缀)
player_id = os.path.splitext(filename)[0]
file_path = os.path.join(FOLDER_PATH, filename)
image_files.append({"player_id": player_id, "path": file_path})
# 按选手编号排序(确保顺序正确)
image_files.sort(key=lambda x: x["player_id"])
# 3. 批量处理(单次最多500条)
total = len(image_files)
print(f"共发现{total}张参赛图片,开始批量检测...")
# 初始化结果文件
with open(RESULT_FILE, "w", newline="", encoding="utf-8") as f:
writer = csv.DictWriter(f, fieldnames=["选手编号", "判断结果", "理由"])
writer.writeheader()
# 分批次处理(如果总数超过500,自动分多批)
for batch_start in range(0, total, BATCH_SIZE):
batch_end = min(batch_start + BATCH_SIZE, total)
batch_files = image_files[batch_start:batch_end]
print(f"处理第{batch_start+1}-{batch_end}张图片...")
# 逐个处理批次内的图片
for file_info in batch_files:
player_id = file_info["player_id"]
image_path = file_info["path"]
# 转Base64
base64_data = image_to_base64(image_path)
if not base64_data:
result = {"选手编号": player_id, "判断结果": "图片读取失败", "理由": "Base64转换失败"}
else:
# 调用API检测
result = check_originality(token, base64_data, player_id)
# 保存结果到CSV
with open(RESULT_FILE, "a", newline="", encoding="utf-8") as f:
writer = csv.DictWriter(f, fieldnames=["选手编号", "判断结果", "理由"])
writer.writerow(result)
# 避免请求过快触发限流
time.sleep(0.5)
print(f"批量检测完成!结果已保存至:{RESULT_FILE}")
if __name__ == "__main__":
# 创建.env文件(如果不存在),方便填写密钥
if not os.path.exists(".env"):
with open(".env", "w", encoding="utf-8") as f:
f.write('DOUBAO_API_KEY="你的API_KEY"\n')
f.write('DOUBAO_API_SECRET="你的API_SECRET"\n')
print("已创建.env文件,请填写你的API_KEY和API_SECRET后重新运行!")
else:
batch_process_images()
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 德国铁路系统因攻击瘫痪、工信部预警新型Linux恶意软件|一周特辑
- 保姆级VSCode入门指南,Python党直接抄作业
- 从零开始:一台空白 Linux 服务器部署 OpenClaw 完整教程
- 小白也能上手!Python打包EXE反编译全攻略,轻松还原源代码
- 嵌入式Linux文件系统制作丨从BusyBox到根文件系统
- Python库巡礼--DuckDB
- Linux权限:从“Permission denied"到游刃有余
- Linux服务器卡顿时,这六步就能找到罪魁祸首,新手建议收藏!
- 掌握Linux通配符,让你的效率翻倍!这些符号太有用了!
- Python3.8 TypedDict