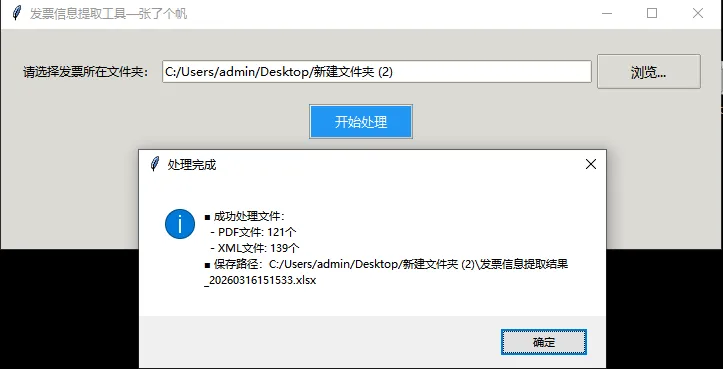
# 导入所需库import osimport tkinter as tkfrom tkinter import ttk, filedialog, messageboximport pdfplumberimport pandas as pdimport refrom unicodedata import normalizeimport xml.etree.ElementTree as ETfrom datetime import datetime# ================== 通用配置 ==================COMMON_COLUMNS = [ "数电票号码", "开票日期", "金额", "税额", "税率", "含税总额", "有效抵扣税额", "购买方识别号", "销售方名称", "发票类型"]# ================== PDF解析模块 ==================class PDFInvoiceParser: @staticmethod def preprocess_text(text): text = normalize('NFKC', text) text = re.sub(r'[\n\r]+', ' ', text) text = re.sub(r'\s{2,}', ' ', text) return text.strip() @staticmethod def extract_field(patterns, text): for pattern in patterns: match = re.search(pattern, text) if match: value = match.group(1).strip() if '¥' in value or '¥' in value: value = value.replace('¥', '').replace('¥', '').strip() return value return None @classmethod def parse_pdf(cls, pdf_path): try: with pdfplumber.open(pdf_path) as pdf: full_text = "" for page in pdf.pages: text = page.extract_text() if text: full_text += cls.preprocess_text(text) + "\n" patterns = { "数电票号码": [ r'发票号码\s*[::]\s*(\d{20})', r'(?:电子票号|票号)\s*[::]\s*(\d+)', ], "开票日期": [ r'开票日期\s*[::]\s*(\d{4}年\d{1,2}月\d{1,2}日)', r'日期\s*[::]\s*(\d{4}-\d{2}-\d{2})', ], "含税总额": [ r'¥\s*(\d+\.?\d*)\s*票价\s*[::]', r'票价\s*[::]\s*¥\s*(\d+\.?\d*)', r'¥\s*(\d+\.?\d*)', r'¥\s*(\d+\.\d{2})', r'\b(\d+\.\d{2})\s*元\b', ], "购买方识别号": [ r'统一社会信用代码\s*[::]\s*([0-9A-Z]{18})', r'纳税人识别号\s*[::]\s*(\S+)', ] } result = { "数电票号码": None, "开票日期": None, "金额": None, "税额": None, "税率": "9%", "含税总额": None, "有效抵扣税额": None, "购买方识别号": None, "销售方名称": "", "发票类型": "铁路电子客票" } for field in patterns: result[field] = cls.extract_field(patterns[field], full_text) # ----- 提取乘客姓名作为销售方名称(优化版)----- # 模式1:身份证号(10位数字 + 4星 + 4位(数字或X))后跟姓名 name_match = re.search(r'(\d{10})\*{4}([0-9X]{4})\s*([\u4e00-\u9fa5]{1,4})', full_text) if name_match: result["销售方名称"] = name_match.group(3) else: # 模式2:直接从票价信息后提取姓名 alt_match = re.search(r'票价[::]\s*¥\s*\d+\.?\d*\s*([\u4e00-\u9fa5]{1,4})', full_text) if alt_match: result["销售方名称"] = alt_match.group(1) else: # 模式3:单独出现的2-4个汉字(如无身份证号的情况) standalone_match = re.search(r'^\s*([\u4e00-\u9fa5]{2,4})\s*$', full_text, re.MULTILINE) if standalone_match: result["销售方名称"] = standalone_match.group(1) else: result["销售方名称"] = "" # ----------------------------------------- # 日期格式处理 if result["开票日期"] and '年' in result["开票日期"]: date_match = re.match(r'(\d{4})年(\d{1,2})月(\d{1,2})日', result["开票日期"]) if date_match: year, month, day = date_match.groups() result["开票日期"] = f"{year}-{month.zfill(2)}-{day.zfill(2)}" # 金额处理 if result["含税总额"]: try: total_str = result["含税总额"].replace(',', '') if '.' not in total_str: total_str += '.00' total = float(total_str) result["含税总额"] = round(total, 2) result["金额"] = round(total / 1.09, 2) result["税额"] = round(total - result["金额"], 2) result["有效抵扣税额"] = result["税额"] except Exception as e: print(f"PDF金额转换失败:{str(e)}") return None if all(result.get(f) for f in ["数电票号码", "开票日期", "含税总额"]): return result return None except Exception as e: print(f"PDF解析异常:{str(e)}") return None# ================== XML发票解析模块 ==================class XMLInvoiceParser: @staticmethod def parse_xml(xml_path): try: tree = ET.parse(xml_path) root = tree.getroot() data = { "数电票号码": root.findtext('.//EIid'), "开票日期": root.findtext('.//IssueTime'), "金额": root.findtext('.//TotalAmWithoutTax'), "税额": root.findtext('.//TotalTaxAm'), "税率": None, "含税总额": root.findtext('.//TotalTax-includedAmount'), "有效抵扣税额": root.findtext('.//TotalTaxAm'), "购买方识别号": root.findtext('.//BuyerInformation/BuyerIdNum'), "销售方名称": root.findtext('.//SellerName'), "发票类型": root.findtext('.//GeneralOrSpecialVAT/LabelName') } # 数值格式转换 for field in ['金额', '税额', '含税总额', '有效抵扣税额']: if data[field]: try: data[field] = float(data[field]) except ValueError: data[field] = None # 日期格式化处理 if data["开票日期"]: try: dt_str = data["开票日期"].split('T')[0] dt = datetime.strptime(dt_str, "%Y-%m-%d") data["开票日期"] = dt.strftime("%Y-%m-%d") except Exception as e: print(f"日期格式转换失败: {str(e)}") data["开票日期"] = None # 税率处理(转换为百分比) tax_rates = [rate.text for rate in root.findall('.//TaxRate')] if tax_rates: try: if len(tax_rates) > 1: rates = list(set([float(r) for r in tax_rates])) if len(rates) > 1: data["税率"] = "多税率" else: data["税率"] = f"{int(rates[0]*100)}%" else: data["税率"] = f"{int(float(tax_rates[0])*100)}%" except ValueError: data["税率"] = "6%" return {k: v if v is not None else "" for k, v in data.items()} except Exception as e: print(f"XML解析失败:{str(e)}") return None# ================== GUI主程序 ==================class InvoiceProcessorApp(tk.Tk): def __init__(self): super().__init__() self.title("发票信息提取工具—张了个帆") self.geometry("720x220") self.configure_ui() def configure_ui(self): self.style = ttk.Style() self.style.theme_use('clam') self.style.configure('TButton', font=('微软雅黑', 10)) self.style.configure('Accent.TButton', foreground='white', background='#2196F3') main_frame = ttk.Frame(self, padding=20) main_frame.pack(fill=tk.BOTH, expand=True) # 路径选择组件 path_frame = ttk.Frame(main_frame) path_frame.pack(fill=tk.X, pady=5) ttk.Label(path_frame, text="请选择发票所在文件夹:").pack(side=tk.LEFT) self.path_var = tk.StringVar() entry = ttk.Entry(path_frame, textvariable=self.path_var, width=50) entry.pack(side=tk.LEFT, padx=5, fill=tk.X, expand=True) ttk.Button(path_frame, text="浏览...", command=self.browse_directory).pack(side=tk.LEFT) # 操作按钮 btn_frame = ttk.Frame(main_frame) btn_frame.pack(pady=10) ttk.Button(btn_frame, text="开始处理", style='Accent.TButton', command=self.process_files).pack(side=tk.LEFT, padx=5) # 状态栏 self.status_var = tk.StringVar(value="就绪状态:等待操作") ttk.Label(main_frame, textvariable=self.status_var, foreground="#666").pack() def browse_directory(self): path = filedialog.askdirectory(title="选择发票文件夹") if path: self.path_var.set(path) self.status_var.set(f"已选择目录:{path}") def process_files(self): path = self.path_var.get() if not path: messagebox.showwarning("提示", "请先选择文件夹") return self.status_var.set("正在解析发票...") self.update() try: all_data = [] error_log = {'PDF': [], 'XML': []} # 处理PDF文件 pdf_data = [] for filename in os.listdir(path): if filename.lower().endswith(".pdf"): self.status_var.set(f"处理PDF: {filename[:20]}...") self.update() result = PDFInvoiceParser.parse_pdf(os.path.join(path, filename)) if result: pdf_data.append(result) else: error_log['PDF'].append(filename) all_data.extend(pdf_data) # 处理XML文件 xml_data = [] for filename in os.listdir(path): if filename.lower().endswith(".xml"): self.status_var.set(f"处理XML: {filename[:20]}...") self.update() result = XMLInvoiceParser.parse_xml(os.path.join(path, filename)) if result: xml_data.append(result) else: error_log['XML'].append(filename) all_data.extend(xml_data) # 生成带时间戳的文件名 if all_data: timestamp = datetime.now().strftime("%Y%m%d%H%M%S") excel_name = f"发票信息提取结果_{timestamp}.xlsx" excel_path = os.path.join(path, excel_name) df = pd.DataFrame(all_data)[COMMON_COLUMNS] # 设置数值格式 with pd.ExcelWriter(excel_path, engine='openpyxl') as writer: df.to_excel(writer, index=False) worksheet = writer.sheets['Sheet1'] # 设置金额列为数值格式 for col in ['C', 'D', 'F', 'G']: # C=金额, D=税额, F=含税总额, G=有效抵扣税额 for cell in worksheet[col]: cell.number_format = '0.00' report = [ f"■ 成功处理文件:", f" - PDF文件: {len(pdf_data)}个", f" - XML文件: {len(xml_data)}个", f"■ 保存路径:{excel_path}" ] if error_log['PDF'] or error_log['XML']: report.append("\n▼ 失败文件 ▼") if error_log['PDF']: report.append(f"PDF文件:\n• " + "\n• ".join(error_log['PDF'])) if error_log['XML']: report.append(f"XML文件:\n• " + "\n• ".join(error_log['XML'])) messagebox.showinfo("处理完成", "\n".join(report)) self.status_var.set(f"处理完成!生成文件:{excel_path}") else: messagebox.showwarning("警告", "没有找到可处理的发票文件") self.status_var.set("未找到有效文件") except Exception as e: messagebox.showerror("系统错误", f"处理异常:{str(e)}") self.status_var.set("处理异常") finally: self.status_var.set("就绪状态:等待新任务")if __name__ == "__main__": app = InvoiceProcessorApp() app.mainloop()
 10个月宝宝每天需要喝多少奶粉?