还在为复杂的业绩拆分烦恼吗?一行行手工计算既耗时又容易出错。今天分享一个Python自动化解决方案,5分钟搞定多人业绩拆分与汇总!一、业务场景:当业绩需要多人分配
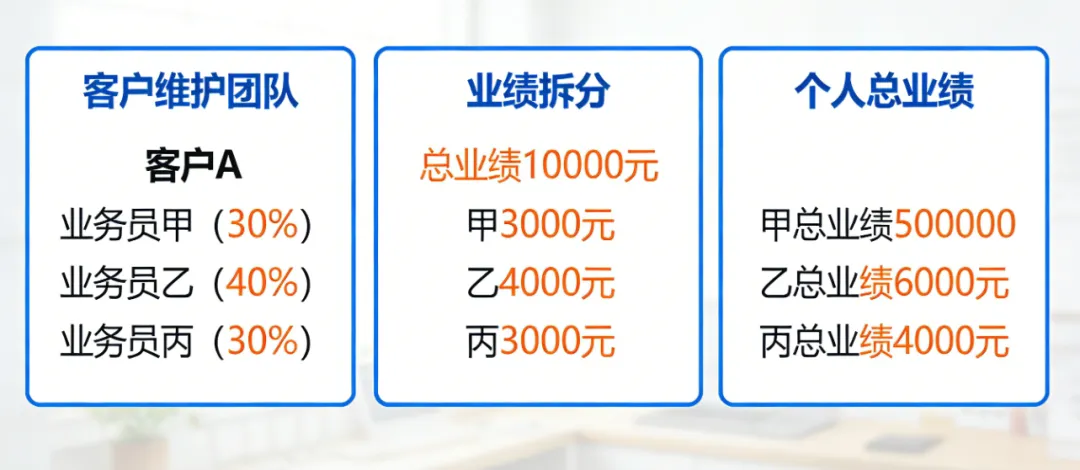
在销售、客服等团队中,经常遇到这样的场景:
传统的手工计算方法:
二、实际效果展示
输入数据示例
业绩比率对照表:
业绩明细表:
输出结果
业绩拆分明细:
业绩汇总:
三、Python解决方案:自动化处理
下面这个Python脚本,能一键完成从数据读取、拆分计算到结果输出的全过程。并附了详细的注释!
核心代码框架
# 导入pandas库,用于数据处理和Excel文件读写
import pandas as pd
# 导入os库,用于文件路径检查、目录操作等系统功能
import os

# ====================== 第一步:读取Excel文件 ======================
# 修改为您实际的文件名
# 定义输入Excel文件的路径(相对路径)
input_excel_path = '业绩数据.xlsx'# 或修改为实际文件名,如 '业绩数据.xls'

# 打印日志:开始读取Excel数据
print("1. 正在从Excel文件读取数据...")
# 打印日志:输出待读取的文件路径
print(f"   - 尝试读取文件: {input_excel_path}")

# 检查指定路径的文件是否存在
ifnot os.path.exists(input_excel_path):
# 文件不存在时打印错误提示
    print(f"   - 错误: 文件 '{input_excel_path}' 不存在!")
# 打印当前程序运行的工作目录
    print(f"   - 当前目录: {os.getcwd()}")
# 打印目录中的Excel文件列表,方便用户核对
    print(f"   - 目录中的文件:")
for file in os.listdir():
if file.endswith(('.xls', '.xlsx')):
            print(f"     - {file}")
# 退出程序,终止后续执行
    exit()

# 异常捕获:处理Excel读取过程中可能出现的所有错误
try:
# 方法1: 首先尝试读取工作表名称
    print("   - 正在检测文件格式和工作表...")
# 打开Excel文件,获取文件对象
    excel_file = pd.ExcelFile(input_excel_path)
# 获取Excel文件中所有工作表的名称列表
    sheet_names = excel_file.sheet_names
# 打印日志:输出文件中的所有工作表
    print(f"   - 文件中的工作表: {sheet_names}")

# 定义程序必须的两个工作表名称
    required_sheets = ['业绩比率对照表', '业绩明细表']
# 筛选出缺失的必要工作表
    missing_sheets = [sheet for sheet in required_sheets if sheet notin sheet_names]

# 如果存在缺失的工作表
if missing_sheets:
# 打印错误提示:缺少必要工作表
        print(f"   - 错误: 缺少必要的工作表: {missing_sheets}")
        print(f"   - 请确保Excel文件中包含: {required_sheets}")
# 退出程序
        exit()

# 初始化两个数据框,用于存储读取的表格数据
    ratio_df = None
    detail_df = None

# 根据文件扩展名选择合适的读取引擎
if input_excel_path.endswith('.xlsx'):
# 对于.xlsx文件,优先尝试openpyxl引擎读取
try:
# 读取业绩比率对照表
            ratio_df = pd.read_excel(input_excel_path, sheet_name='业绩比率对照表', engine='openpyxl')
# 读取业绩明细表
            detail_df = pd.read_excel(input_excel_path, sheet_name='业绩明细表', engine='openpyxl')
            print("   - 使用openpyxl引擎读取成功")
# openpyxl读取失败时捕获异常
except Exception as e1:
            print(f"   - openpyxl读取失败: {e1}")
# 降级尝试xlrd引擎读取
try:
                ratio_df = pd.read_excel(input_excel_path, sheet_name='业绩比率对照表', engine='xlrd')
                detail_df = pd.read_excel(input_excel_path, sheet_name='业绩明细表', engine='xlrd')
                print("   - 使用xlrd引擎读取成功")
# xlrd读取失败时捕获异常
except Exception as e2:
                print(f"   - xlrd读取失败: {e2}")
# 最终不指定引擎,使用pandas默认方式读取
                ratio_df = pd.read_excel(input_excel_path, sheet_name='业绩比率对照表')
                detail_df = pd.read_excel(input_excel_path, sheet_name='业绩明细表')
                print("   - 使用默认引擎读取成功")

elif input_excel_path.endswith('.xls'):
# 对于.xls旧版文件,优先使用xlrd引擎
try:
            ratio_df = pd.read_excel(input_excel_path, sheet_name='业绩比率对照表', engine='xlrd')
            detail_df = pd.read_excel(input_excel_path, sheet_name='业绩明细表', engine='xlrd')
            print("   - 使用xlrd引擎读取.xls文件成功")
# 读取失败时降级使用默认引擎
except Exception as e:
            print(f"   - xlrd读取失败: {e}")
            ratio_df = pd.read_excel(input_excel_path, sheet_name='业绩比率对照表')
            detail_df = pd.read_excel(input_excel_path, sheet_name='业绩明细表')
            print("   - 使用默认引擎读取成功")
else:
# 非Excel标准后缀,直接使用默认方式读取
        ratio_df = pd.read_excel(input_excel_path, sheet_name='业绩比率对照表')
        detail_df = pd.read_excel(input_excel_path, sheet_name='业绩明细表')

# 校验:两个核心表格必须成功读取
if ratio_df isNoneor detail_df isNone:
raise Exception("未能成功读取Excel文件")

# 数据预处理:统一关键列的数据类型,避免格式错误
    print("   - 正在处理数据类型...")
# 遍历两个数据框,统一字段类型
for df in [ratio_df, detail_df]:
# 将客户编码转为字符串类型,防止数字格式异常
if'客户编码'in df.columns:
            df['客户编码'] = df['客户编码'].astype(str)
# 将业务员名称转为字符串类型
if'业务员'in df.columns:
            df['业务员'] = df['业务员'].astype(str)

# 打印日志:数据读取完成
    print("   - 数据读取成功!")
# 打印两个表格的行列数(形状)
    print(f"   - 业绩比率对照表 形状: {ratio_df.shape}")
    print(f"   - 业绩明细表 形状: {detail_df.shape}")

# 打印预览:输出两个表格的前5行数据,方便核对
    print("\n   - 业绩比率对照表 前5行:")
    print(ratio_df.head())
    print("\n   - 业绩明细表 前5行:")
    print(detail_df.head())

# 捕获所有读取Excel过程中的异常
except Exception as e:
# 打印详细错误信息
    print(f"   - 读取Excel时出错: {e}")
    print(f"   - 错误类型: {type(e).__name__}")
# 打印错误解决方案,指导用户排查问题
    print("\n   - 可能的原因和解决方案:")
    print("     1. 确保文件是有效的Excel文件(.xls 或 .xlsx 格式)")
    print("     2. 安装必要的库:")
    print("        pip install openpyxl xlrd")
    print("     3. 检查Excel文件是否损坏")
    print("     4. 检查工作表名称是否正确(大小写敏感)")
# 退出程序
    exit()

# ====================== 第二步:核心数据处理与计算函数 ======================
defcalculate_performance_split(detail_df, ratio_df):
"""
    根据业绩比率对照表拆分业绩明细并计算每人所得
    参数:
        detail_df:业绩明细数据框
        ratio_df:业绩比率对照数据框
    返回:
        result_df:拆分后的业绩明细数据框
        summary_df:业务员业绩汇总数据框
    """
# 打印日志:开始核心计算
    print("\n2. 正在执行数据拆分与计算...")

# 1. 合并两张表:通过客户编码+业务员关联两张表
    print("   - 正在合并数据表...")
    merged_df = pd.merge(
        detail_df,
        ratio_df[['客户编码', '业务员', '业绩比率']],
        on=['客户编码', '业务员'],  # 关联键
        how='left',  # 左连接,保留所有明细数据
        suffixes=('', '_ratio')
    )

# 初始化列表,存储拆分后的所有行数据
    all_result_rows = []

# 2. 逐行处理合并后的数据
    print("   - 正在拆分业务员和计算分配比例...")
# 遍历每一行数据
for idx, row in merged_df.iterrows():
try:
# 按&符号拆分业务员名称(多业务员用&分隔)
            salespeople = str(row['业务员']).split('&')

# 按:符号拆分业绩比率,并转为整数
            ratios = list(map(int, str(row['业绩比率']).split(':')))
# 计算比率总和,用于换算实际占比
            total_ratio = sum(ratios)
# 计算每个业务员的实际分配比例
            actual_ratios = [r / total_ratio for r in ratios]

# 遍历每个业务员和对应的比例,生成新的行数据
for sp, ratio in zip(salespeople, actual_ratios):
                new_row = {
'客户编码': row['客户编码'],
'客户名称': row['客户名称'] if'客户名称'in row else'',
'当月实际业务量': float(row['当月实际业务量']),
'姓名': sp,
'比例': round(ratio, 4),  # 保留4位小数
'折算业务量': round(float(row['当月实际业务量']) * ratio, 2)  # 保留2位小数
                }
# 将新行添加到结果列表
                all_result_rows.append(new_row)
# 单行数据处理异常时,打印警告并跳过该行
except Exception as e:
            print(f"     警告: 处理第{idx+1}行时出错: {e}")
            print(f"     行数据: {row.to_dict()}")

# 3. 将结果列表转为DataFrame数据框
    result_df = pd.DataFrame(all_result_rows)

# 确保结果包含所有必要列,缺失列补空
    required_columns = ['客户编码', '客户名称', '当月实际业务量', '姓名', '比例', '折算业务量']
for col in required_columns:
if col notin result_df.columns:
            result_df[col] = ''

# 按指定顺序筛选列,保证格式统一
    result_df = result_df[required_columns]

# 4. 按业务员分组汇总总业绩
    print("   - 正在汇总业务员总业绩...")
    summary_df = result_df.groupby('姓名', as_index=False)['折算业务量'].sum()
# 重命名汇总列
    summary_df.columns = ['业务员', '总业绩']
# 按业务员名称排序
    summary_df = summary_df.sort_values('业务员')

# 打印日志:计算完成
    print("   - 计算完成!")
# 返回拆分明细和汇总结果
return result_df, summary_df

# ====================== 第三步:执行计算 ======================
# 调用核心函数,执行业绩拆分和汇总计算
result_df, summary_df = calculate_performance_split(detail_df, ratio_df)

# 显示处理结果统计信息
print(f"\n3. 处理结果统计:")
print(f"   - 原始业绩明细记录数: {len(detail_df)}")
print(f"   - 拆分后明细记录数: {len(result_df)}")
# 计算平均每条记录拆分的人数
if len(detail_df) > 0:
    print(f"   - 平均每条记录拆分人数: {len(result_df)/len(detail_df):.2f}")

# 预览计算结果
if len(result_df) > 0:
    print("\n拆分后的业绩明细 (前10行):")
    print(result_df.head(10))

    print("\n各业务员业绩汇总:")
    print(summary_df)
else:
    print("   - 警告: 没有生成任何结果记录!")

# ====================== 第四步:将结果写入Excel ======================
# 定义输出Excel文件的路径
output_path = '业绩拆分与汇总结果.xlsx'
print(f"\n4. 正在将结果写入Excel文件: {output_path}")

# 异常捕获:处理文件写入错误
try:
# 使用openpyxl引擎创建Excel写入对象
with pd.ExcelWriter(output_path, engine='openpyxl') as writer:
# 写入拆分后的业绩明细,不保留索引
        result_df.to_excel(writer, sheet_name='业绩拆分明细', index=False)
# 写入业绩汇总表
        summary_df.to_excel(writer, sheet_name='业绩汇总', index=False)

# 打印日志:写入成功
    print("   - 结果输出成功!")
# 输出文件绝对路径
    print(f"   - 结果文件路径: {os.path.abspath(output_path)}")
if len(result_df) > 0:
        print(f"   - 文件包含:")
        print(f"     1. '业绩拆分明细': {len(result_df)}条拆分后的明细记录")
        print(f"     2. '业绩汇总': {len(summary_df)}个业务员的汇总业绩")

# 写入失败时捕获异常
except Exception as e:
    print(f"   - 写入结果文件时出错: {e}")
# 降级尝试使用xlwt引擎写入
try:
with pd.ExcelWriter(output_path, engine='xlwt') as writer:
            result_df.to_excel(writer, sheet_name='业绩拆分明细', index=False)
            summary_df.to_excel(writer, sheet_name='业绩汇总', index=False)
        print("   - 使用xlwt引擎写入成功")
# 所有引擎都写入失败,提示用户排查问题
except:
        print("   - 请检查文件是否被其他程序打开,或尝试安装openpyxl: pip install openpyxl")

# ====================== 第五步:数据验证 ======================
# 仅在有结果数据时执行验证
if len(result_df) > 0:
    print("\n5. 数据验证:")

# 验证1:总业务量金额一致性检查
try:
# 计算原始总业务量
        original_total = detail_df['当月实际业务量'].astype(float).sum()
# 计算拆分后总业务量
        split_total = result_df['折算业务量'].astype(float).sum()
        print(f"   - 原始总业务量: {original_total:,.2f}")
        print(f"   - 拆分后总业务量: {split_total:,.2f}")
# 计算误差
        diff = abs(original_total - split_total)
# 误差小于0.01视为一致
if diff < 0.01:
            print(f"   - 金额一致性检查: ✓ 一致 (误差: {diff:.10f})")
else:
            print(f"   - 金额一致性检查: ⚠ 有差异 (误差: {diff:.2f})")
# 金额验证异常时打印错误
except Exception as e:
        print(f"   - 金额验证时出错: {e}")

# 验证2:检查是否有缺失业绩比率的客户-业务员组合
    missing_info = pd.merge(
        detail_df[['客户编码', '业务员']].drop_duplicates(),
        ratio_df[['客户编码', '业务员']],
        on=['客户编码', '业务员'],
        how='left',
        indicator=True
    )
# 筛选出仅在左表存在(无对应比率)的数据
    missing_ratio = missing_info[missing_info['_merge'] == 'left_only']
if len(missing_ratio) > 0:
        print(f"   - 警告: 有{len(missing_ratio)}个客户-业务员组合未找到对应的业绩比率")
        print(missing_ratio[['客户编码', '业务员']].head())
else:
        print("   - 所有客户-业务员组合都有对应的业绩比率")

# 打印分隔线和完成提示
print("\n" + "="*60)
print("处理完成!")
print(f"输入文件: {input_excel_path}")
print(f"输出文件: {output_path}")
print("="*60)
四、方案的五大优势
1. 高效准确
2. 灵活扩展
# 轻松扩展:支持更多业务员
# 原始:A&B&C (1:2:3)
# 扩展:A&B&C&D&E (1:2:3:4:5)
# 代码无需修改,自动适应
3. 自动化流程
4. 易于维护
5. 数据验证
脚本自动验证:
五、使用指南
环境准备
# 安装必要的Python库
pip install pandas openpyxl
数据准备
- 业绩比率对照表:客户编码、客户名称、业务员、业绩比率
- 业绩明细表:客户编码、客户名称、业务员、当月实际业务量
运行步骤
# 只需三步
1. 准备好Excel数据文件
2. 运行Python脚本
3. 查看生成的"结果.xlsx"
这个Python解决方案相比传统手工方法:
核心价值:将复杂的业绩拆分工作从手动劳动转化为自动化流程,解放人力,提高准确性,让数据工作者专注于更有价值的分析工作。
立即行动:
有相关问题或改进建议,欢迎留言交流!
获取和交流
需要本章或其他文章的源码和数据的同学,关注+三连,在对应文章下评论“6666“,加下面微信,发你!也可以拉你进群交流学习,加群备注:IT小本本学习
为了能随时获取最新动态,大家可以动动小手将公众号添加到“星标⭐”哦,点赞 + 关注,用时不迷路!!!!
关注公众号:IT小本本 👇
 10个月宝宝每天需要喝多少奶粉?