当搜索引擎的“蜘蛛”爬虫第一次造访你的网站时,它做的第一件事是什么?不是抓取首页,也不是分析内容,而是寻找一个名为 robots.txt 的小文件。
这个看似不起眼的文本文件,却是网站与搜索引擎之间最重要的沟通桥梁,它决定了哪些内容可以“见光”,哪些需要“藏起来”。
robots.txt 是一个存放在网站根目录下的纯文本文件(例如 https://www.example.com/robots.txt)。它遵循“机器人排除协议”(Robots Exclusion Protocol),用于告知搜索引擎的爬虫程序(如Googlebot、Baiduspider)哪些页面或目录可以抓取,哪些应该忽略。
避免爬虫抓取无SEO价值的页面(如后台、登录页、重复内容),将有限的“抓取预算”集中在核心内容上,提升收录效率。
防止管理后台、配置文件、用户数据等敏感目录被索引和公开。
减少爬虫对服务器资源的无效消耗,特别是对于大型网站或资源有限的服务器。
重要认知:它是一份“君子协议”,而非防火墙。
robots.txt 更像是一份写给“礼貌”爬虫的请求书,而非强制执行的法律。正规的搜索引擎爬虫(如Google、百度)会遵守它,但恶意爬虫完全可以无视。因此,它不能用于隐藏真正敏感的信息(如信用卡号),这类信息应通过密码保护或服务器权限来控制。
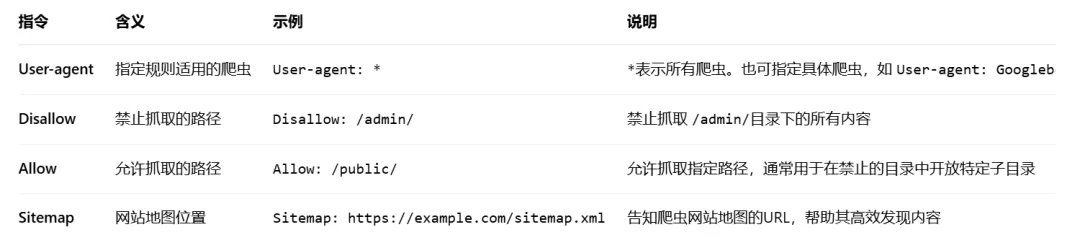
一个标准的 robots.txt 文件由一条或多条“规则组”构成。每组规则包含以下核心指令:
必须以斜杠 /开头。Disallow: /admin会屏蔽所有以 /admin开头的URL(如 /admin.html和 /admin/),而 Disallow: /admin/则只屏蔽 /admin/目录下的内容。
规则按从上到下的顺序执行。更具体的路径规则优先。
Allow指令可以覆盖同组中更宽泛的 Disallow规则
。例如,禁止整个 /blog/目录,但允许其中的 /blog/public/子目录。
使用 #号添加注释。
# 示例1:允许所有爬虫抓取整个网站(默认行为,等同于没有robots.txt)User-agent: *Allow: /# 示例2:禁止所有爬虫抓取任何内容(常用于网站开发或维护阶段)User-agent: *Disallow: /# 示例3:禁止所有爬虫访问特定目录和文件User-agent: *Disallow: /wp-admin/ # WordPress后台Disallow: /cgi-bin/ # CGI脚本目录Disallow: /tmp/ # 临时文件Disallow: /private.html # 特定私密文件# 示例4:针对特定爬虫设置规则(仅禁止BadBot)User-agent: BadBotDisallow: /User-agent: *Allow: /
对于使用 WordPress 的网站,一个优化的 robots.txt 可以显著提升SEO效率:
User-agent: *Disallow: /wp-admin/Disallow: /wp-includes/Disallow: /wp-login.phpDisallow: /wp-content/plugins/Disallow: /wp-content/themes/Disallow: /search/Disallow: /?s=*Disallow: /author/ # 如果网站只有单一作者,可禁止作者存档页避免重复内容Disallow: /*?replytocom=* # 禁止评论分页参数# 允许对网站功能重要的文件Allow: /wp-admin/admin-ajax.php # 许多主题和插件的AJAX功能依赖此文件Allow: /wp-content/uploads/ # 允许抓取上传的图片、PDF等媒体文件# 指明网站地图,帮助爬虫Sitemap: https://www.yoursite.com/sitemap_index.xml
# 禁止抓取所有动态URL(包含问号?)Disallow: /*?*# 禁止抓取所有 .pdf 文件Disallow: /*.pdf$# 禁止抓取所有 /private- 开头的路径Disallow: /private-*
注意:$表示URL的结束。/*.pdf$只匹配以 .pdf结尾的URL。
配置 robots.txt 时,一个微小的错误就可能导致整个网站从搜索引擎消失。请务必避开以下陷阱:
robots.txt必须放在网站根目录(如 https://example.com/robots.txt)。放在子目录下无效
。
在 Disallow和 Allow指令中应使用相对路径(以 /开头),而非完整的 https://链接。
Allow指令若写在 Disallow前面,且范围更广,会导致后面的 Disallow失效。
# ❌ 错误:Allow在前且范围更广,Disallow无效User-agent: *Allow: /Disallow: /admin/# ✅ 正确:Disallow在前,或Allow范围更具体User-agent: *Disallow: /admin/Allow: /
Crawl-delay:用于设置爬虫抓取延迟(单位:秒)。但Google已明确不再支持此指令
。如需控制Googlebot的抓取速度,应在Google Search Console中设置。
Noindex:切勿在 robots.txt 中使用 Noindex指令。Google已于2019年宣布停止支持此用法
。如果想阻止页面被索引,应使用 <meta name="robots" content="noindex">元标签或 X-Robots-TagHTTP 标头
。
网站在开发阶段常用 Disallow: /屏蔽所有抓取。上线后务必移除或修改此规则,否则网站将无法被收录。
如果禁止爬虫抓取 .css和 .js文件,Googlebot 将无法看到网站的完整渲染样式,可能影响页面内容的理解和排名。
(7)最大的误解:robots.txt 能隐藏页面
这是最危险的误区!即使使用 Disallow屏蔽了某个页面,如果其他网站链接到了该页面,Google 仍可能发现该URL并将其编入索引(只是没有描述内容)。要彻底阻止页面出现在搜索结果中,必须使用 noindex元标签或密码保护。
在文件末尾添加 Sitemap:指令,帮助搜索引擎更快、更全面地发现你的重要页面。
你可以为不同的搜索引擎设置不同的规则。
# 只禁止Google图片搜索抓取特定目录User-agent: Googlebot-ImageDisallow: /images/private/# 其他所有爬虫规则照常User-agent: *Disallow: /admin/
修改 robots.txt 后,务必使用 Google Search Console 的 robots.txt 测试工具 进行验证,确保没有意外屏蔽重要页面。
example.com的 robots.txt 对 blog.example.com无效。每个子域名都需要自己的 robots.txt 文件。
对于页面级的精细控制,应在HTML的 <head>部分使用 robotsmeta标签,例如 <meta name="robots" content="noindex, nofollow">。
使用任何文本编辑器(如记事本、VS Code)创建一个名为 robots.txt的纯文本文件,使用UTF-8编码保存。
通过FTP或网站后台文件管理器,将其上传到网站的根目录(通常是与 index.html或 wp-config.php同级的位置)。
直接在浏览器中访问 https://你的网站.com/robots.txt,查看内容是否正确显示。
🔸 守规矩:爬前先看 robots.txt,尊重网站规则。
🔸 有礼貌:设置访问间隔(如 time.sleep),别把服务器挤爆。
🔸 装得像:带上合理 User-Agent和请求头,模拟真人浏览器。
🔸 不越界:绝不爬取个人隐私、机密或明确禁止的数据。
🔸 存得好:妥善处理数据,注明来源,注意脱敏。