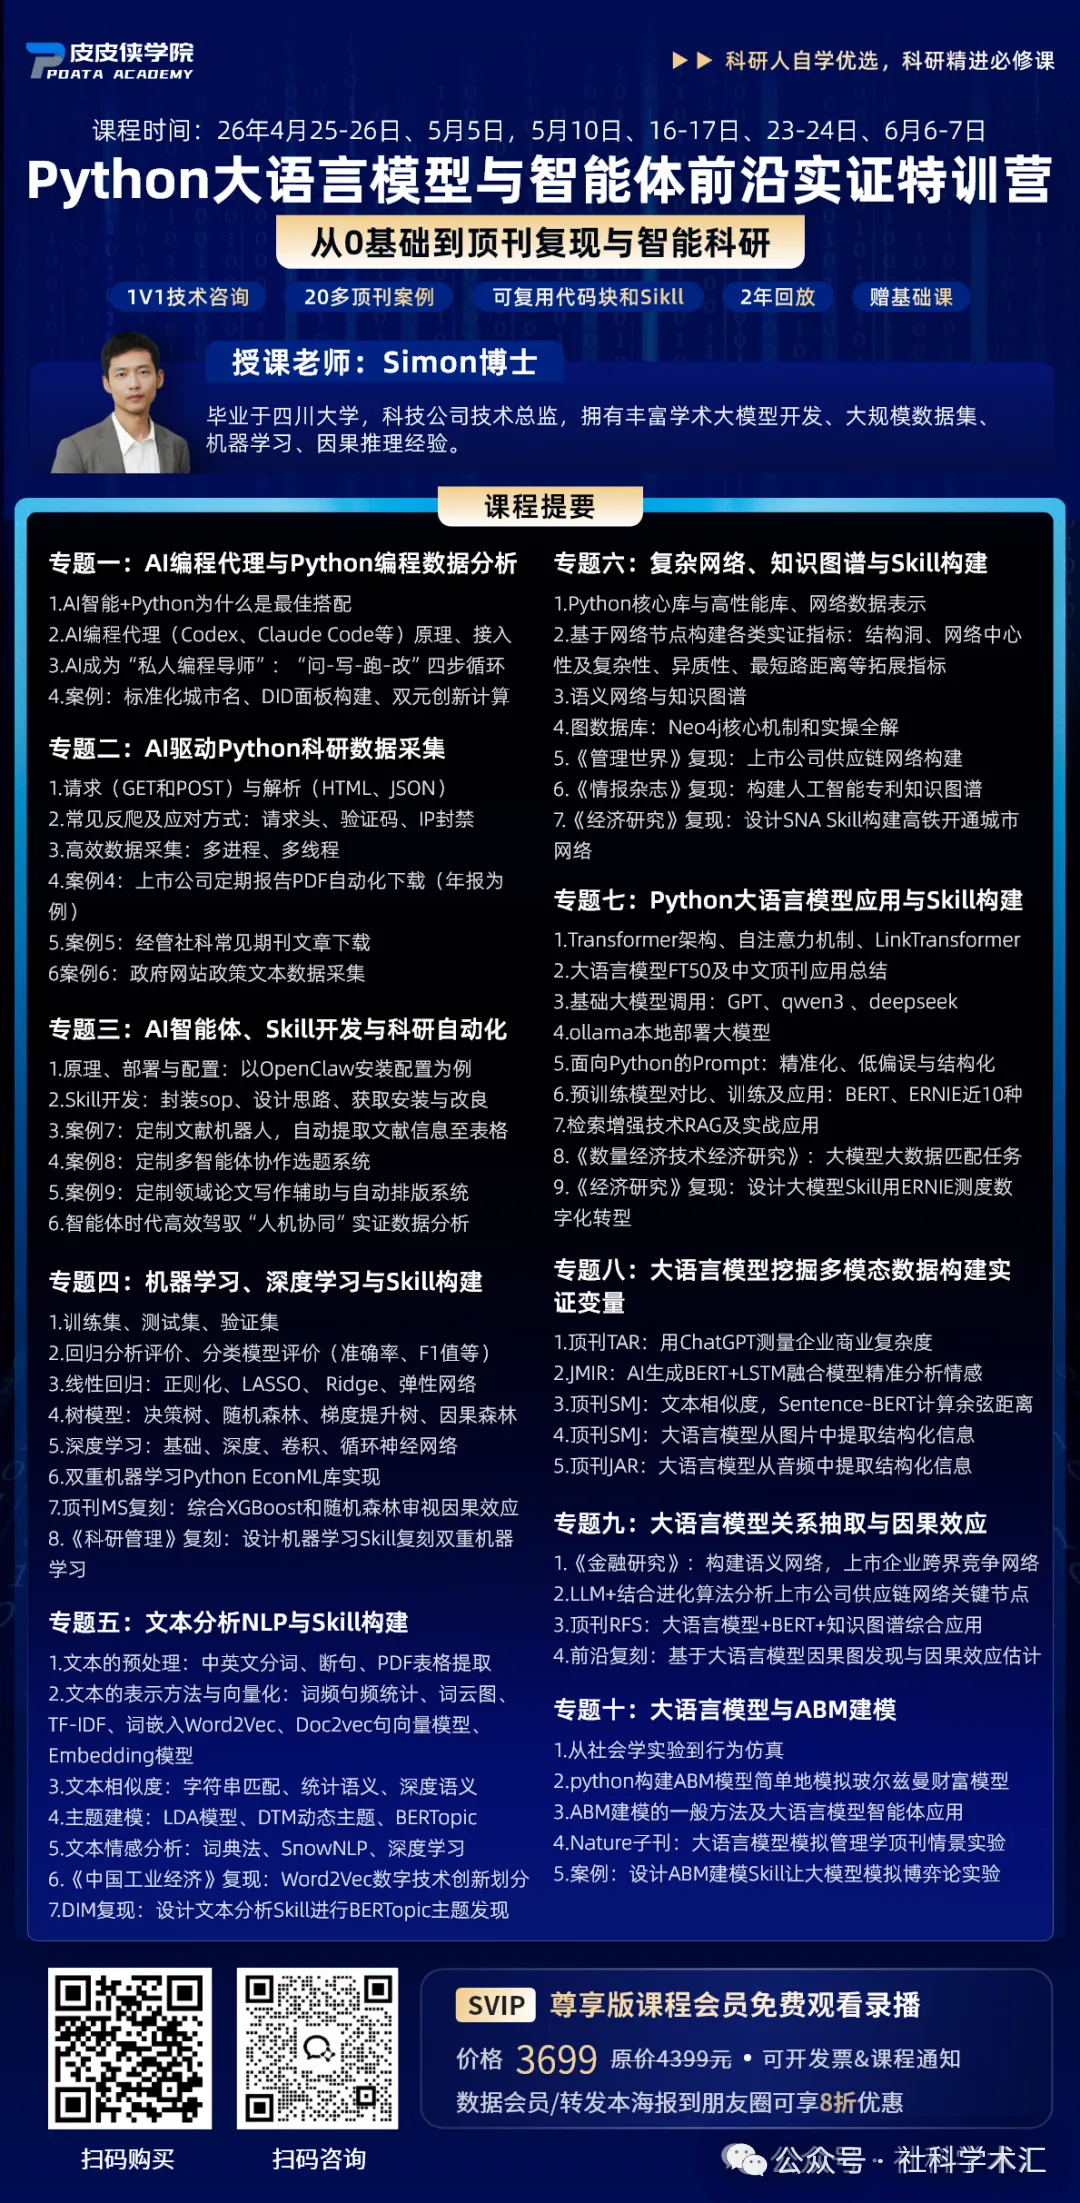
专题一:AI编程代理与Python编程数据分析
1.AI智能+Python为什么是最佳搭配:科研效率、自动化程度、数据精度、批量处理能力、可控性与稳定性全面提升
2.AI编程代理工具(Codex、Claude Code等)原理:颠覆性本地编程范式
3.Codex、Claude Code等主流编程代理接入方式
4.人机协作让新手快速上手编程:“问-写-跑-改”四步循环法用自然语言零代码指挥AI完成数据分析任务
5.让AI成为你的“私人编程导师”:一句话解决Python学习困惑
6.零代码Python实战案例:
实战案例1:“市”还是“不市”,用Python代码标准化城市名称:
实战案例2:DID面板数据构建:县域城乡融合发展试点DID数据2010-2025构建
实战案例3:基于专利数据计算利用式创新和探索式创新
方法复刻参考文献:Guan J, Liu N. Exploitative and exploratory innovations in knowledge network and collaboration network: A patent analysis in the technological field of nano-energy[J]. Research policy, 2016, 45(1): 97-112.
专题二:AI驱动Python科研数据采集
1.网页信息请求:GET请求和POST请求
2.网页常见返回数据解析:纯文本、HTML、JSON格式解析
3.返回数据保存到本地路径:CSV、Excel、MySQL
4.常见反爬手段及其应对方式:请求头、验证码、IP封禁
5.高效数据采集手段:多进程、多线程
案例4:上市公司定期报告PDF自动化下载(年报为例)
案例5:经管社科常见期刊文章下载
案例6:政府网站政策文本数据采集
专题三:AI智能体、Skill开发与科研自动化
1.AI Agent原理、部署与配置:以OpenClaw安装与基础配置为例,手把手教你适配Mac / Windows环境
2.Skill开发:将常见任务封装为可复用模块的流程与使用方式,Skill工作流程设计思路;如何从社区中(clawhub、skillhub)获取实用skill,如何个性化改良已有skill
3.Skill + Python打造高效科研论文工作流
案例7:定制专属文献梳理机器人:结合个人研究领域,从多渠道文献数据库检索论文,提取论文研究问题、自变量因变量测量方式、研究结论、使用技术方法、研究贡献、局限性,并自动整理为表格。
案例8:定制多智能体协作选题系统:自动分析最新论文、关键词趋势和研究热点,生成候选主题配置智能体,一个负责生成选题,一个负责评估,一个负责整合,最终输出候选列表。
案例9:论文写作辅助与自动排版系统:自动整合文献、生成论文结构、完成引用整理并输出LaTeX或Word格式。
4.智能体时代,学者如何快速掌握计算社会科学、数据科学基础技术本质、内核,高效驾驭“人机协同”实证数据分析。
专题四:机器学习、深度学习与Skill构建
1.机器学习基本概念
(1)什么是机器学习?监督学习vs 无监督学习
(2)回归(Regression)与分类(Classification)的区别
(3)训练集、测试集、验证集
(4)常用机器学习模型评价指标
a)回归分析评价指标:MAE、MSE、RMSE、R²等
b)分类模型评价指标:准确率、精确率、召回率、F1值等
2. 数据准备与特征工程基础
(1)特征与标签
(2)使用Pandas 构造特征矩阵 X 和目标向量 y
(3)简单缺失值处理与数据标准化
3. 常见回归模型介绍与Python实现
(1)线性回归(LinearRegression)Python实现
a)带正则化的回归:
b惩罚性回归(LassoL1 正则,自动特征选择; Ridge)
c)弹性网络(ElasticNet,L1+L2 混合)
(2)树模型Python实现
a)决策树
b)随机森林
c)梯度提升树(GBDT)
d)因果森林(causal forests)
e)广义随机森林(GRF)
4.深度学习基础Python实现
神经网络基础
深度神经网络(DNN)
卷积神经网络(CNN,主要用于图像处理领域)
循环神经网络(RNN,处理序列数据如文本、音频、视频等)
5.双重机器学习原理与应用
双重机器学习原理及优势
基于EconML库实现双重机器学习(DDML)
学术图表输出:Python直接导出回归结果三线表
实战案例10:综合运用正则化回归、优化分布式梯度提升(XGBoost)和随机森林、神经网络审视因果效应
参考文献:
Hajime Shimao; , Sung Joo Kim; , Warut Khern-Am-Nuai, Maxime C. Cohen (2025) Revisiting the CEO Effect Through a Machine Learning Lens. Management Science 71(6):5396-5408.
实战案例11:机器学习Skill开发,自动复现顶刊双重机器学习因果推断部分
参考文献:
程中华,韩乐乐,李廉水.数据交易对企业数字创新的影响研究[J].科研管理,2025,46(10):31-39.
专题五:文本分析NLP与Skill构建
1.文本的预处理
a)从pdf文件(文字版/图片版)中提取文本和表格
b)jieba中文分词与深度学习分词模型pkuseg
c)nltk英文分词
d)文本断句
2.文本的表示方法与向量化
a)词频统计与句频统计
b)词云图
c)TF-IDF
d)词嵌入技术Word2Vec
e)Embedding模型:大语言模型和检索系统的核心技术基石
3.文本相似度计算(可计算信息含量差异性等)
a)基于字符串匹配的传统方法:余弦相似度、Jaccard 相似系数
b)基于统计与浅层语义的方法:TF-IDF 余弦相似度、Word Embedding加权平均
C)基于深度学习与深度语义的方法:Sentence Embeddings获取句子级别的向量表示
4.文本主题建模
a)LDA模型
b)DTM动态主题模型
c)BERTopic主题模型:超实用和强大的主题建模
5.文本情感分析
a)基于情感词典与规则的方法:词典法
b)基于机器学习的方法:朴素贝叶斯、支持向量机、逻辑回归、随机森林等
c)基于深度学习的方法:Word2Vec预训练词向量作为输入
实战案例12:使用Word2Vec算法构建数字专利词库,采用有监督机器学习(GBDT模型)将划分数字专利,同时对比Word2Vec、Embedding模型效果
参考文献:
周鹏,王卓,谭常春等.数字技术创新的价值——基于并购视角和机器学习方法的分析[J].中国工业经济,2024,(02):137-154.
实战案例13:文本分析Skill开发,自动基于BERTopic实现计算社会科学主题发现
参考文献:
Gupta P, Ding B, Guan C, Ding D. Generative AI: A systematic review using topic modelling techniques[J]. Data and Information Management, 2024, 8(1): 100066.
专题六:复杂网络、知识图谱与Skill构建
1.社会网络分析Python核心库简介:Networkx
2.网络构建与可视化:从矩阵、DataFrame等常见数据结构中构建网络
3.网络结构分析:社区划分(CDlib社区发现算法集合)、子群、模块度
4.网络节点分析
(1)常用指标:网络中心性(出/入度中心度、中介中心度、接近中心度、特征向量中心度)、结构洞指数、PageRank、TextRank等
(2)拓展指标:最短路距离、离心度、自我中心网络指标、网络直径、网络密度等
5.语义网络与知识图谱
6.图数据库:Neo4j核心机制和实操全解
实战案例14:上市公司供应链网络构建
参考文献:
陈雯,范茵子.企业供应链风险感知与合作关系稳定性[J].管理世界,2024,40(11):209-228.
实战案例15:基于GPT模型与neo4j图数据库构建人工智能专利知识图谱
参考文献:
周贞云,黄昭昭,邱均平.基于LLM与可视化的图数据库专利知识图谱构建及分析[J].情报杂志,1-9.
实战案例16:社会网络分析Skill开发,自动调用2010-2022高铁开通线路数据构建城市高铁网络
参考文献:
陈旭,邱斌,纪展鹏.城市网络嵌入、信息可得性与企业创新边界[J].经济研究,2025,60(06):57-76.
专题七:Python大语言模型应用与Skill构建
1.基于Transformer架构的大语言模型
a)Transformer的基本原理和结构、注意力机制;
b)编码器和解码器的结构;
c)Transformer大语言模型:Generative (decoder) models、Masked (encoder) language models
2.大语言模型FT50及中文顶刊应用总结
3.顶刊中基础大模型特点及Python调用:GPT、通义千问qwen3 模型、DeepSeek
4.ollama本地部署大模型
5.Prompt工程技术:
面向Python的AI高质量输出技巧
(1)精准输出技巧:如何人机结合用好AI,最大化减少偏误?
参考文献:Baumann, J., Röttger, P., Urman, A., Wendsjö, A., Plaza-del-Arco, F. M., Gruber, J. B., & Hovy, D. (2025).Large language model hacking: Quantifying the hidden risks of using LLMs for text annotation. arXiv.
(2)结构化输出技巧:输出Python代码可处理的数据结构
6.预训练模型的对比、训练及应用:BERT、Sentence BERT、Fin BERT、RoBERTa、DistilBERT、SciBERT、PatentSBERTa、HeBERT、ERNIE、RoBERTa
7.检索增强技术RAG及实战应用
实战案例17:结构化数据的记录连接(匹配)
大模型在不同数据集中匹配个体、地点、公司、组织、产品描述或学术论文等信息,大模型在记录连接方面表现出了巨大的潜力,以大语言模型完成大数据匹配任务:招聘数据与中国职业分类大典匹配为例进行讲解
参考文献:
张星民,张建清,刘小慧,等.外部技术断供、工作任务与企业劳动力需求结构——基于Transformer架构大数据文本挖掘的微观证据[J].数量经济技术经济研究,2025,42(09):72-93.
实战案例18:大模型工作流Skill开发,自动调用ERNIE模型测度企业数字化转型变量
参考文献:
金星晔,左从江,方明月,等.企业数字化转型的测度难题:基于大语言模型的新方法与新发现[J].经济研究,2024,59(03):34-53.
专题八:大语言模型挖掘多模态数据构建实证变量
1.大语言模型构建实证变量
实战案例19:用ChatGPT测量企业商业复杂度
参考文献:
Bernard, D., Blankespoor, E., de Kok, T., & Toynbee, S. (2026). Using GPT to measure business complexity. The Accounting Review, 1-36.
2.大语言模型进行情感分析
实战案例20:利用AI生成BERT+LSTM融合模型精准分析情感变化
核心方法参考文献:Ou Y, de Bruijn G, Schulz P. Social media as an emotional barometer: Bidirectional encoder representations from transformers–long short-term memory sentiment analysis on the evolution of public sentiments during influenza A on Sina Weibo[J]. Journal of Medical Internet Research, 2025, 27: e68205.
3.大语言模型测量文本相似度
实战案例21:采用无监督词嵌入方法Sentence-BERT计算余弦距离
核心方法参考文献:Bao, Jiayi. "Do makerspaces affect entrepreneurship? If so, who, how, and when?."Strategic Management Journal46.2 (2025): 502-533.
4.大语言模型从图片中提取结构化数据
实战案例22:大语言模型识别图片表情信息
核心方法参考文献:Momtaz P P. CEO emotions and firm valuation in initial coin offerings: an artificial emotional intelligence approach[J]. Strategic Management Journal, 2021, 42(3): 558-578.
5.大语言模型从音频中提取结构化数据
实战案例23:大语言模型识别公开音频信息
核心方法相关文献:CHENG, S.-Y. and GOLSHAN, N.M. (2025), Silent Suffering: Using Machine Learning to Measure CEO Depression. Journal of Accounting Research, 63: 689-767.
专题九:大语言模型关系抽取与因果效应
1.大语言模型构建语义网络
实战案例24:基于Embedding模型企业跨界竞争网络构建
参考文献:
牛晓健,强皓凡,吕斌,等.企业跨界竞争与债务违约风险——基于机器学习与复杂网络方法[J].金融研究,2024,(03):150-168.
2.大语言模型动态生成节点重要性评估算法
实战案例25:LLM+结合进化算法分析上市公司供应链网络关键节点
参考文献:
Mao, Jinzhu, et al. "Identify critical nodes in complex network with large language models." arXiv preprint arXiv:2403.03962 (2024).
3.大语言模型+BERT+知识图谱综合应用
实战案例26:通过大模型与思维链提示法(CoT)和检索增强生成(RAG)技术,识别复杂语境中隐含关系,转化为结构化知识图谱
参考文献:Kai Li, Feng Mai, Rui Shen, Chelsea Yang, Tengfei Zhang, Dissecting Corporate Culture Using Generative AI,The Review of Financial Studies, Volume 39, Issue 1, January 2026, Pages 253–296, https://doi.org/10.1093/rfs/hhaf081.
4.基于大语言模型因果图发现与因果效应估计
案例27:基于因果图方法揭示特征变量与结果变量之间的因果关系
利用大语言模型(LLM)丰富知识和强大语义理解推理能力,基于贝叶斯网络,表示DAG节点及边,构建因果图结构,并进行因果图检验与因果效应估计
核心方法参考来源:张宁,林黄奕,聂小成.信用违约与机器学习:数据驱动的大语言模型因果推断方法[J].北方民族大学学报,2026,(01):158-167.
专题十:大语言模型与ABM建模
1.从社会学实验到行为仿真:系统、复杂系统,系统建模、复杂系统建模,主体建模(Agent-based Modeling,ABM)适用情境
2.python构建ABM模型简单地模拟玻尔兹曼财富模型:假设所有人生而平等,即持有相同的1单位资本,将1单位资本随机给一个其他的人,一个社会按这种规则不断演化产生的结果
3.ABM建模的一般方法
(1)构建环境:交互地图、数据收集器、智能体调度器
(2)构建智能体:智能体交互规则、智能体行为
(3)大语言模型和AI智能体在ABM建模中可以做什么
4.大语言模型模拟管理学情景实验
实战案例28:选择管理学顶刊经典实验,用GPT、Qwen和DeepSeek进行“硅基复制”,模拟实验
Cui, Z., Li, N. & Zhou, H. A large-scale replication of scenario-based experiments in psychology and management using large language models. Nat Comput Sci 5, 627–634 (2025).
5.大语言模型模拟经济学博弈论实验
实战案例29:经济学ABM建模Skill开发,大型语言模型在博弈论实验中复现并预测人类合作
核心方法参考文献:Palatsi, A. C., Martin-Gutierrez, S., Cardenal, A. S., & Pellert, M. (2024).Large language models replicate and predict human cooperation across experiments in game theory. arXiv.
 10个月宝宝每天需要喝多少奶粉?