专题一、文本分析总论与LLM技术基础
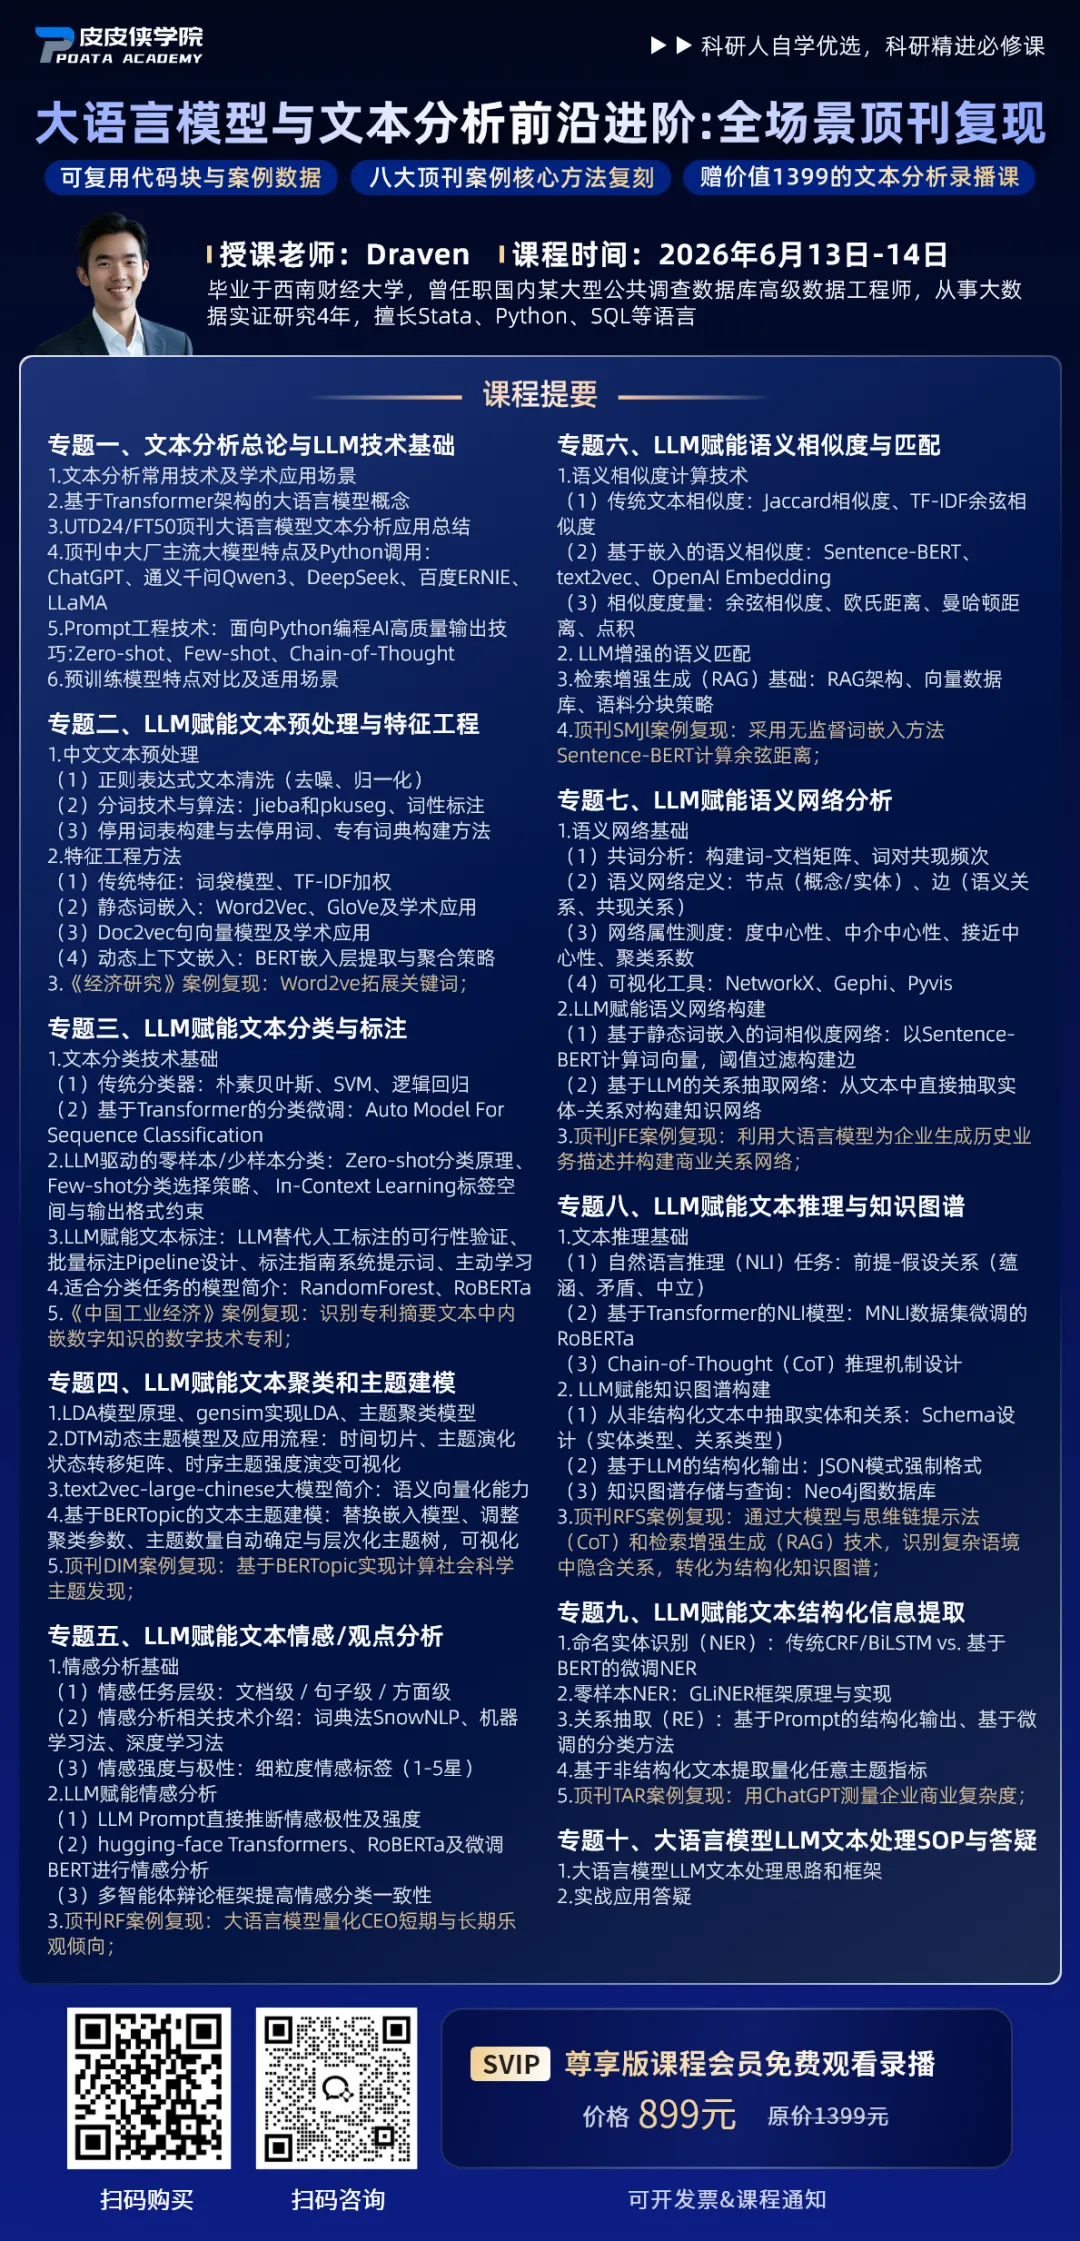
1.文本分析常用技术及学术应用场景:预处理与特征工程、分类与标注 、聚类与主题建模、情感/观点分析、语义相似度与匹配、语义网络分析、推理与知识图谱、摘要与信息提取。
2.基于Transformer架构的大语言模型概念
3.UTD24/FT50顶刊大语言模型文本分析应用总结
4.顶刊中大厂主流大模型特点及Python调用:ChatGPT、通义千问Qwen3、DeepSeek、百度ERNIE、LLaMA
5.Prompt工程技术:面向Python编程AI高质量输出技巧:Zero-shot、Few-shot、Chain-of-Thought
6.预训练模型特点对比及适用场景:BERT、Sentence BERT、Fin BERT、RoBERTa、DistilBERT、SciBERT、PatentSBERTa、HeBERT、text2vec-large-chinese
专题二、LLM赋能文本预处理与特征工程
1.中文文本预处理
(1)正则表达式文本清洗(去噪、归一化)
(2)分词技术与算法:Jieba和pkuseg、词性标注
(3)停用词表构建与去停用词、专有词典构建方法
2.特征工程方法
(1)传统特征:词袋模型(CountVectorizer)、TF-IDF加权(TfidfVectorizer)
(2)静态词嵌入:Word2Vec(gensim)、GloVe及学术应用
(3)Doc2vec句向量模型及学术应用
(4)动态上下文嵌入:BERT嵌入层提取与聚合策略
3.顶刊案例复现1:Word2ve拓展关键词;参考:陆瑶,施函青,周欣怡.中国企业数字技术风险暴露对企业价值的影响——来自大语言模型的文本分析证据[J].经济研究,2025,60(02):73-89.
专题三、LLM赋能文本分类与标注
1.文本分类技术基础
(1)传统分类器:朴素贝叶斯、SVM、逻辑回归(scikit-learn)
(2)基于Transformer的分类微调:Auto Model For Sequence Classification
2.LLM驱动的零样本/少样本分类:Zero-shot分类原理、Few-shot分类选择策略、
、In-Context Learning标签空间与输出格式约束
3.LLM赋能文本标注:LLM替代人工标注的可行性验证、批量标注Pipeline设计、标注指南系统提示词、主动学习
4.适合分类任务的模型简介:RandomForest、RoBERTa
5.顶刊案例复现2:识别专利摘要文本中内嵌数字知识的数字技术专利;参考:马述忠,张道涵,胡增玺.数字知识流动如何促进区域协调发展——兼论经济增长和平衡发展双重目标[J].中国工业经济,2025,(02):80-98.
专题四、LLM赋能文本聚类和主题建模
1.传统主题建模工具介绍
(1)LDA模型原理:文档-主题-词的三层贝叶斯生成过程
(2)gensim实现LDA:语料库构建、词典、模型训练、主题一致性(Coherence)评估
(3)主题聚类模型:基于K-Means等
2.DTM动态主题模型及应用流程:时间切片、主题演化状态转移矩阵、时序主题强度演变可视化
3.text2vec-large-chinese大模型简介:语义向量化能力
4.基于BERTopic的文本主题建模:核心架构、替换嵌入模型(如text2vec)、调整聚类参数、主题数量自动确定与层次化主题树,可视化
5.顶刊案例复现13:基于BERTopic实现计算社会科学主题发现;参考:Gupta P, Ding B, Guan C, Ding D. Generative AI: A systematic review using topic modelling techniques[J]. Data and Information Management, 2024, 8(1): 100066.
专题五、LLM赋能文本情感/观点分析
1.情感分析基础
(1)情感任务层级:文档级 / 句子级 / 方面级
(2)情感分析相关技术介绍:词典法SnowNLP、机器学习法、深度学习法
(3)情感强度与极性:细粒度情感标签(1-5星)
2.LLM赋能情感分析
(1)LLM Prompt直接推断情感极性及强度
(2)hugging-face Transformers、RoBERTa及微调BERT进行情感分析
(3)多智能体辩论框架提高情感分类一致性
3.顶刊案例复现4:大语言模型量化CEO短期与长期乐观倾向;参考:Jiayin Hu, Laura Xiaolei Liu, Chloe Yue Liu, Hao Qu, Yingguang Zhang, CEO turnover, sequential disclosure, and stock returns, Review of Finance, 2025;,rfaf015.
专题六、LLM赋能语义相似度与匹配
1.语义相似度计算技术
(1)传统文本相似度:Jaccard相似度、TF-IDF余弦相似度
(2)基于嵌入的语义相似度:Sentence-BERT、text2vec、OpenAI Embedding
(3)相似度度量:余弦相似度、欧氏距离、曼哈顿距离、点积
2. LLM增强的语义匹配:基于LLM的零样本语义相关性判定(二分类Prompt),大模型在不同数据集中匹配个体、地点、公司、组织、产品描述或学术论文等信息,大模型在记录连接方面表现出了巨大的潜力,以大语言模型完成大数据匹配任务:招聘数据与中国职业分类大典匹配为例进行讲解,参考(数量经济技术经济研究,2025)
3.检索增强生成(RAG)基础:RAG架构、向量数据库、语料分块策略
4.顶刊案例复现5:采用无监督词嵌入方法Sentence-BERT计算余弦距离;参考:Bao, Jiayi. "Do makerspaces affect entrepreneurship? If so, who, how, and when?."Strategic Management Journal46.2 (2025): 502-533.
专题七、LLM赋能语义网络分析
1.语义网络基础
(1)共词分析:构建词-文档矩阵、词对共现频次
(2)语义网络定义:节点(概念/实体)、边(语义关系、共现关系)
(3)网络属性测度:度中心性、中介中心性、接近中心性、聚类系数
(4)可视化工具:NetworkX、Gephi、Pyvis
2.LLM赋能语义网络构建
(1)基于静态词嵌入的词相似度网络:以Sentence-BERT计算词向量,阈值过滤构建边
(2)基于LLM的关系抽取网络:从文本中直接抽取实体-关系对构建知识网络
3.顶刊案例复现6:利用大语言模型为企业生成历史业务描述并构建商业关系网络;参考:Breitung, C., & Müller, S. (2025). Global business networks. Journal of Financial Economics, 166, 104007.
专题八、LLM赋能文本推理与知识图谱
1.文本推理基础
(1)自然语言推理(NLI)任务:前提-假设关系(蕴涵、矛盾、中立)
(2)基于Transformer的NLI模型:MNLI数据集微调的RoBERTa
(3)Chain-of-Thought(CoT)推理机制设计
2. LLM赋能知识图谱构建
(1)从非结构化文本中抽取实体和关系:Schema设计(实体类型、关系类型)
(2)基于LLM的结构化输出:JSON模式强制格式
(3)知识图谱存储与查询:Neo4j图数据库
3.顶刊案例复现7:通过大模型与思维链提示法(CoT)和检索增强生成(RAG)技术,识别复杂语境中隐含关系,转化为结构化知识图谱;参考:Kai Li, Feng Mai, Rui Shen, Chelsea Yang, Tengfei Zhang, Dissecting Corporate Culture Using Generative AI,The Review of Financial Studies, Volume 39, Issue 1, January 2026, Pages 253–296,
专题九、LLM赋能文本结构化信息提取
1.命名实体识别(NER):传统CRF/BiLSTM vs. 基于BERT的微调NER
2.零样本NER:GLiNER框架原理与实现
3.关系抽取(RE):基于Prompt的结构化输出、基于微调的分类方法
4.基于非结构化文本提取量化任意主题指标
5.顶刊案例复现8:用ChatGPT测量企业商业复杂度;参考:Bernard, D., Blankespoor, E., de Kok, T., & Toynbee, S. (2026). Using GPT to measure business complexity. The Accounting Review, 1-36.
专题十、大语言模型LLM文本处理SOP与答疑
1.大语言模型LLM文本处理思路和框架
2.实战应用答疑