【零基础玩透Python】Day46:透视表与交叉表 – pivot_table, crosstab,一键实现数据透视
大家好,我是[知识充电宝的灵感日记]。
今天我们来学习 Pandas 中两个非常强大且直观的功能:透视表(pivot_table)和交叉表(crosstab)。它们类似于 Excel 中的数据透视表,可以帮助你快速对数据进行分组汇总、交叉统计,是探索性数据分析的利器。
今天的目标:
难度:⭐⭐(参数稍多,但逻辑清晰)
一、准备工作
import pandas as pd
import numpy as np

# 示例数据:销售记录
df = pd.DataFrame({
'日期': ['2025-01-01', '2025-01-01', '2025-01-02', '2025-01-02', '2025-01-03'],
'产品': ['A', 'B', 'A', 'C', 'B'],
'地区': ['东', '西', '东', '东', '西'],
'销售额': [100, 150, 120, 90, 130]
})
print(df)
           日期 产品 地区  销售额
0  2025-01-01  A  东  100
1  2025-01-01  B  西  150
2  2025-01-02  A  东  120
3  2025-01-02  C  东   90
4  2025-01-03  B  西  130
二、pivot_table 基础
1. 最简单的透视:一个行字段,一个值字段
# 按产品汇总销售额(求和)
pivot = pd.pivot_table(df, values='销售额', index='产品', aggfunc='sum')
print(pivot)
    销售额
产品
A   220
B   280
C    90
等价于 df.groupby('产品')['销售额'].sum()。
2. 行和列:两个维度
# 行:产品,列:地区,值:销售额,聚合:求和
pivot = pd.pivot_table(df, values='销售额', index='产品', columns='地区', aggfunc='sum', fill_value=0)
print(pivot)
地区    东    西
产品
A   220    0
B     0  280
C    90    0
fill_value=0将缺失填充为0。
3. 多级行索引
pivot = pd.pivot_table(df, values='销售额', index=['产品', '地区'], aggfunc='sum')
print(pivot)
       销售额
产品 地区
A  东   220
B  西   280
C  东    90
4. 多级列索引
pivot = pd.pivot_table(df, values='销售额', index='产品', columns=['地区', '日期'], aggfunc='sum', fill_value=0)
5. 多个聚合函数
pivot = pd.pivot_table(df, values='销售额', index='产品', aggfunc=['sum', 'mean', 'count'])
print(pivot)
    sum   mean count
    销售额    销售额   销售额
产品
A   220  110.0     2
B   280  140.0     2
C    90   90.0     1
6. 对不同的值列使用不同的聚合函数
# 假设有销售额和利润两列
df['利润'] = df['销售额'] * 0.2
pivot = pd.pivot_table(df, values=['销售额', '利润'], index='产品', aggfunc={'销售额': 'sum', '利润': 'mean'})
print(pivot)
      利润  销售额
产品
A   22.0  220
B   28.0  280
C   18.0   90
7. 添加总计(margins)
pivot = pd.pivot_table(df, values='销售额', index='产品', columns='地区', aggfunc='sum', margins=True, margins_name='总计')
print(pivot)
地区      东      西   总计
产品
A   220.0    NaN  220
B     NaN  280.0  280
C    90.0    NaN   90
总计  310.0  280.0  590
margins=True会添加行/列总计。
三、crosstab:交叉表(频数统计)
crosstab 主要用于计算两个(或多个)因子之间的频数,也可以做加权汇总。
1. 基本频数统计
# 统计不同产品在不同地区的出现次数
cross = pd.crosstab(df['产品'], df['地区'])
print(cross)
地区  东  西
产品
A   2  0
B   0  2
C   1  0
2. 添加行/列总计
cross = pd.crosstab(df['产品'], df['地区'], margins=True)
print(cross)
地区   东  西  All
产品
A    2  0    2
B    0  2    2
C    1  0    1
All  3  2    5
3. 归一化(比例)
# 按行归一化(每行总和为1)
cross_row = pd.crosstab(df['产品'], df['地区'], normalize='index')
# 按列归一化
cross_col = pd.crosstab(df['产品'], df['地区'], normalize='columns')
4. 加权交叉表(类似透视表但默认计数)
# 按销售额加权汇总
cross_weighted = pd.crosstab(df['产品'], df['地区'], values=df['销售额'], aggfunc='sum', fill_value=0)
print(cross_weighted)
这个结果与 pivot_table一样。区别在于:crosstab默认计数,pivot_table默认求和。
四、实战小案例
案例1:销售数据透视分析
sales = pd.DataFrame({
'季度': ['Q1', 'Q1', 'Q2', 'Q2', 'Q2'],
'产品': ['A', 'B', 'A', 'B', 'C'],
'销售额': [120, 90, 150, 110, 70],
'利润': [30, 20, 40, 25, 15]
})

# 按季度和产品查看总销售额
pivot = pd.pivot_table(sales, values='销售额', index='季度', columns='产品', aggfunc='sum', fill_value=0)
print("各季度各产品销售额:\n", pivot)

# 同时显示销售额和利润(多值列)
pivot2 = pd.pivot_table(sales, values=['销售额', '利润'], index='季度', aggfunc='sum')
print("\n各季度总额:\n", pivot2)
各季度各产品销售额:
 产品    A    B   C
季度
Q1  120   90   0
Q2  150  110  70

各季度总额:
     利润  销售额
季度
Q1  50  210
Q2  80  330
案例2:用户调查满意度交叉分析
survey = pd.DataFrame({
'性别': ['男', '男', '女', '女', '男', '女'],
'年龄段': ['青年', '中年', '青年', '青年', '中年', '中年'],
'满意度': ['满意', '一般', '满意', '不满意', '一般', '满意']
})

# 统计性别与满意度的频数
cross = pd.crosstab(survey['性别'], survey['满意度'], margins=True)
print("性别-满意度分布:\n", cross)

# 按年龄段和性别统计满意度比例(归一化)
cross_norm = pd.crosstab(survey['年龄段'], survey['性别'], normalize='columns')
print("\n年龄段在各性别中的比例:\n", cross_norm)
性别-满意度分布:
 满意度  一般  不满意  满意  All
性别
女     0    1   2    3
男     2    0   1    3
All   2    1   3    6

年龄段在各性别中的比例:
 性别          女         男
年龄段
中年   0.333333  0.666667
青年   0.666667  0.333333
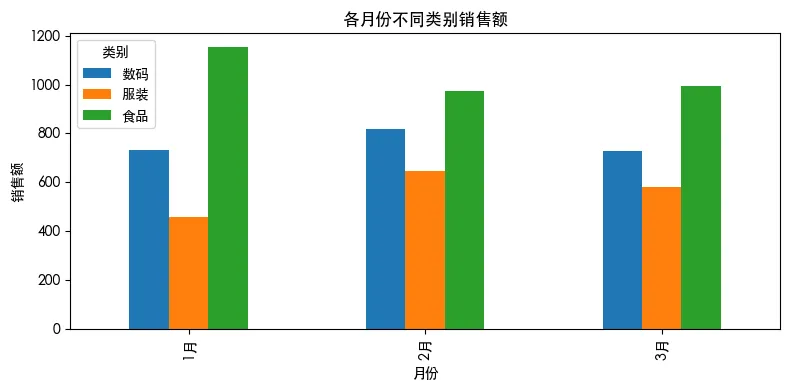
案例3:透视表与绘图结合(简单示例)
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['Heiti TC', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 模拟电商数据
np.random.seed(42)
df = pd.DataFrame({
'月份': np.repeat(['1月','2月','3月'], 20),
'类别': np.random.choice(['服装','数码','食品'], 60),
'销售额': np.random.randint(50, 200, 60)
})

# 透视:月份为行,类别为列,销售额为值
pivot = pd.pivot_table(df, values='销售额', index='月份', columns='类别', aggfunc='sum')
pivot.plot(kind='bar', figsize=(8,4))
plt.title('各月份不同类别销售额')
plt.ylabel('销售额')
plt.tight_layout()
plt.show()
五、今日练习
练习1:创建收入透视表
使用以下数据创建透视表:
import pandas as pd
df = pd.DataFrame({
'部门': ['销售', '技术', '销售', '技术', '市场'],
'季度': ['Q1', 'Q1', 'Q2', 'Q2', 'Q1'],
'收入': [100, 200, 150, 180, 120]
})
要求:以 部门 为行,季度 为列,显示 收入 的总和,填充缺失为0,并添加总计行列。
- 用 crosstab 统计以下数据中 学历 与 是否购买 的频数:
df = pd.DataFrame({
'学历': ['本科','硕士','本科','大专','硕士','本科'],
'是否购买': ['是','否','是','是','否','是']
})
并计算按学历的购买比例(行归一化)。
visits = pd.DataFrame({
'日期': ['周一','周一','周二','周二','周三'],
'用户类型': ['新用户','老用户','新用户','老用户','老用户'],
'访问时长': [120, 80, 90, 110, 100]
})
用 pivot_table 计算每种用户类型在不同日期的平均访问时长。 `
- (挑战)加载泰坦尼克数据集(df = sns.load_dataset('titanic')
或从 URL 读取),用 crosstab 分析 Pclass(舱位)与 Survived(存活)的关系,并计算存活率(按舱位归一化)。再用pivot_table` 计算不同舱位和性别的平均年龄。
六、常见错误与提示
pivot_table默认 aggfunc='mean':如果想求和需要显式指定 aggfunc='sum'。fill_value只填充缺失的聚合结果,不是填充原始数据。- 多级索引时,
margins=True可能产生不期望的总计,尤其当聚合函数不是可加性时(如中位数)。 crosstab中的 values和 aggfunc一起使用:可实现加权汇总,类似 pivot_table。- 性能:大数据集上透视表可能较慢,可考虑先筛选再透视。
七、明日预告
Day47:数据可视化开篇 – Matplotlib基本绘图 (plot, scatter, bar)
我们将进入可视化部分,学习 Matplotlib 的基础图表绘制,让数据说话。