前几篇文章把linux系统环境中磁盘分区、文件系统格式化、性能优化等方面的介绍,本文继续讲述日常使用中常用的磁盘I/O的监控方法。
通过本文内容,可以了解到通过哪些工具可以查看、监控磁盘的运行状态、是否存在性能瓶颈、是否存在硬件故障等信息。
一、磁盘监控的五个主要指标
1.磁盘I/O使用率:表示在一段时间范围内磁盘处理I/O的时间百分比;也就是磁盘IO处于读写工作的时间/总采样时间×100%。
2.磁盘饱和度:表示磁盘处理I/O的繁忙程度;直观说法就是请求磁盘I/O的队列拥堵程度,代表超出磁盘处理能力的积压请求量。当磁盘 I/O请求来得比磁盘处理速度快时,I/O会进入等待队列。饱和度数值越高,队列堆积越严重。当磁盘响应时间飙升时,若同步伴随高饱和度,确定是磁盘处理能力不足。
通常来说在磁盘顺序读写场景下饱和度低,随机读写场景下最为容易出现高饱和度。
3.磁盘IOPS:每秒的磁盘I/O请求数。通常机械磁盘的IOPS是两千IOPS;SATA SSD是几万IOPS;NVMe SSD可以达到几十万IOPS。
通常在磁盘I/O多的场景下,优先看IOPS上限,而非吞吐量;大文件场景下吞吐量较高,但IOPS很低;海量小文件IOPS高,吞吐量较低。
4.磁盘吞吐量:每秒请求磁盘I/O传输的数据总量(带宽)。
5.磁盘响应时间:磁盘I/O从发出请求到收到响应的时间间隔(队列排队等待时间+ 磁盘物理处理时间)。
二、磁盘监控的主要工具和方法
Linux系统环境中用于对磁盘运行状态监控的工具和方法很多,以下主要简单介绍常用的磁盘运行状态监控工具:iostat、vmstat。
1.iostat
主要监控磁盘读写性能(如吞吐量、IOPS、延迟等),同时也显示CPU利用率和磁盘负载;iostat属于sysstat工具包,多数Linux系统都自带安装此软件包。
用法示例:iostat -xm 2 (每两秒输出磁盘采样结果,以MB为单位)
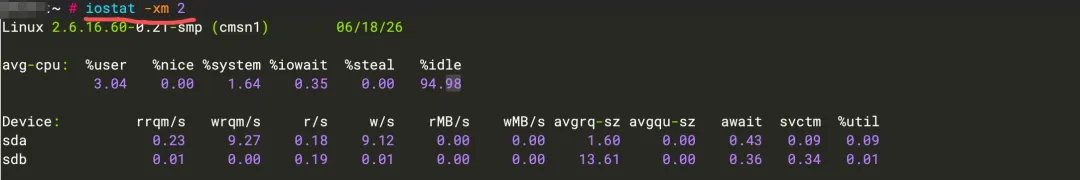
字段参数说明:
(1)avg-cpu:这段主要显示cpu运行信息。
%user:表示用户态进程占用CPU的百分比。
%nice:表示用户态中具有nice优先级的进程占用CPU 的百分比。
%system:表示内核态进程占用CPU的百分比。
%iowait:表示CPU等待I/O操作完成所花费的时间百分比。如果该值较高,说明系统I/O操作较为繁忙,可能存在I/O瓶颈。
%steal:表示被虚拟机管理程序偷走的CPU时间百分比,通常在虚拟机环境中才有意义。
%idle:表示CPU处于空闲状态的时间百分比。
(2)Device:这段主要显示系统中的各种存储设备运行信息。
rrqm/s:每秒合并的读请求数。就是当系统有多个读I/O请求发往同一磁盘扇区时,内核会将这些请求合并为一个请求,以提高I/O效率。
wrqm/s:每秒合并的写请求数,原理与rrqm/s类似。
r/s:每秒磁盘I/O读请求数(IOPS指标)
w/s:每秒磁盘I/O写请求数(IOPS指标)
rMB/s:每秒磁盘I/O读取的数据量(实际吞吐量、带宽指标)。
wMB/s:每秒磁盘I/O写入的数据量(实际吞吐量、带宽指标)。
avgrq - sz:平均每次磁盘I/O请求的扇区数,反映了I/O 请求的大小。
avgqu - sz:平均磁盘I/O 队列长度(饱和度指标),显示了等待处理的I/O请求。的平均队列数量。如果该值持续走高,说明磁盘I/O存在性能瓶颈。
await:平均每次磁盘I/O请求的等待时间(响应指标),包括在队列中的等待时间和实际I/O 操作的时间,单位是毫秒。
svctm:平均每次磁盘I/O操作的服务时间(响应指标),也就是实际执行I/O操作所花费的时间,单位是毫秒。
%util:设备的I/O使用率(使用率指标),表示设备处于忙碌状态的时间百分比。如果该值接近100%,说明设备已经接近饱和,可能会影响系统性能。
核心要点:如果await和svctm的差值不大, 说明磁盘I/O几乎没有等待时间;如果await远大于svctm,说明磁盘I/O队列太长,磁盘I/O响应太慢,这种情况就需要优化磁盘了。
2.vmstat
主要是系统整体资源监控,可查看系统级的CPU、内存、I/O,判断系统负载类型、内存交换swap等问题。vmstat属于系统自带的procps工具包。
用法实例:vmstat 2 5 (每两秒输出一次结果,输出5次)
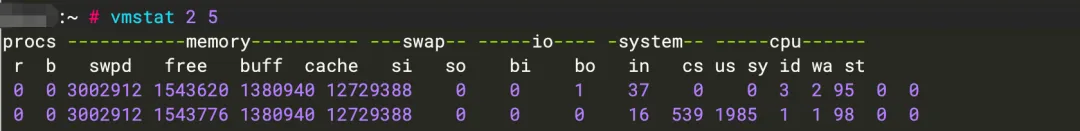
字段参数说明:
(1)procs(进程)
(2)memory内存(单位KB)
(3)swap交换IO(核心判断内存是否不足)
如果si/so这两个值长期不为0,说明物理内存压力大,系统频繁换页,会造成系统性能严重下降。
(4)io 磁盘IO(单位块,1 块=512字节)
(5)system系统中断及上下文切换
如果cs突增,说明多线程频繁切换以及锁竞争激烈
(6)cpu整机CPU 占用(总和100%)
如果wa持续大于10%并且b大于0、bi/bo持续高,说明磁盘I/O出现瓶颈问题。
核心要点:
三、五个指标综合运用的参考
- 1. 高使用率+高IOPS +低延迟,属于正常的业务运行负载。
- 2. 高使用率+高吞吐量+低IOPS,属于正常顺序读写负载。
- 3. 高使用率+高饱和度+高延迟,属于磁盘性能不足,存在IO瓶颈。
- 4.使用率不高+高延迟,属于磁盘硬件异常或者故障。
- 5. 延迟高+高饱和度,属于磁盘I/O资源不足。
- 6. 延迟高但饱和度低,也可能磁盘硬件异常或者故障。
四、写在最后
磁盘监控的主要五个指标(I/O使用率、饱和度、IOPS、吞吐量、响应时间)是评估linux系统的磁盘存储运行状态的多维度因素,同时结合这五个指标通过常用的磁盘监控工具iostat、vmstat对磁盘运行状态采样结果,为我们做好计算机存储系统正常、高效运行提供基础铺垫。
iostat和vmstat这两个工具是很常用的监控磁盘设备、磁盘性能、分析存储瓶颈的工具,这两个工具已经能解决大部分场景。而监控磁盘的监控工具还有很多,比如atop可以分磁盘和分进程精细化统计、iotop可以精准定位哪个进程产生大量I/O等等,可以结合实际场景进行综合选择和运用。
 10个月宝宝每天需要喝多少奶粉?