上一章我们讲了 random 和 datetime,你已经能明显感觉到标准库不是摆设,而是真能立刻帮你做出更像真实工具的小功能。那这一章,我们继续往前走,再认识三个非常值得尽早建立感觉的标准库模块:
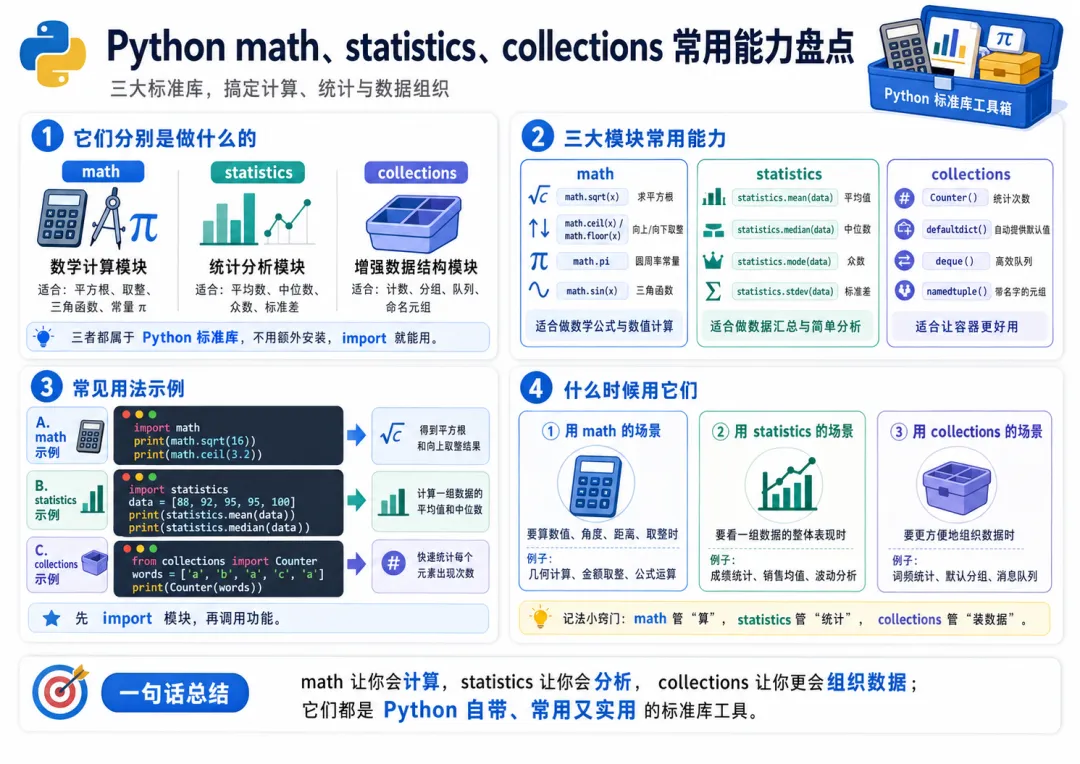
mathstatisticscollections
这三个模块放在一起讲,非常合适。因为它们都属于那种:
平时不用时好像存在感不强 一旦遇到对应场景,就会非常顺手
它们解决的问题分别很典型:
math 更偏数学计算statistics 更偏基础统计collections 更偏更好用的数据结构
也就是说,这一章你会明显感觉到,标准库不是只会“和系统打交道”,它也在帮你把日常数据处理写得更专业、更省事。
一、先说 math:为什么有时候不用自己硬算
先看最直白的理解:
math 模块是 Python 里专门提供常见数学计算能力的工具箱。
比如你可能会遇到这些需求:
求平方根 向上取整 向下取整 算三角函数 算幂 获取圆周率 求绝对值之外的一些更标准数学能力
这些事情,当然有些你也可以自己写。 但如果标准库已经给了成熟工具,那很多时候就没必要自己重复造轮子。
先导入:
import math
后面常见能力几乎都从这里拿。
二、最常见的一个函数:sqrt()
这是 math 里最经典的入门函数之一。
import mathprint(math.sqrt(25))
输出结果:
5.0
sqrt() 的意思就是求平方根。
这个函数特别适合用来帮你快速建立感觉: 很多你以为得自己写算法的数学动作,标准库其实已经准备好了。
比如:
print(math.sqrt(16))print(math.sqrt(81))
输出:
4.09.0
你会发现,这种写法比自己瞎折腾循环或猜测逼近法要直接得多。
三、第二组特别常见的函数:ceil() 和 floor()
有时候你想处理小数时,不只是四舍五入,而是需要:
向上取整 或者 向下取整
这时候就会用到:
import mathprint(math.ceil(3.2))print(math.floor(3.8))
输出结果:
43
这里:
ceil() 是向上取整floor() 是向下取整
这两个函数在很多场景里都很实用。
比如:
分页计算 价格区间计算 需要“至少多少个”的数量问题 按容量分组时的最少组数计算
比如一个特别常见的小题目:
一个箱子最多装 8 个苹果,37 个苹果至少需要几个箱子?
这时候就特别适合用:
import mathapples = 37box_size = 8print(math.ceil(apples / box_size))
输出结果:
5
因为 37 除以 8 等于 4.625,但箱子数量不能有半个,所以必须向上取整。
这种题目一旦用 ceil(),会特别自然。
四、第三个常见内容:pow() 和 pi
虽然 Python 自带 ** 也能做幂运算,但 math 里同样有:
import mathprint(math.pow(2, 3))
输出结果:
8.0
另外一个很经典的常量是:
import mathprint(math.pi)
输出结果大概是:
3.141592653589793
这就很有代表性。
你不需要自己手写圆周率近似值。 标准库已经准备好了。
所以以后只要你碰到和圆、面积、周长、角度转换相关的问题,脑子里就可以先想到 math.pi。
五、math 模块的整体感觉应该怎么建立
你现在不用一下子把里面所有函数都学完。 更重要的是先建立一种场景感:
只要事情和“更正式一点的数学计算”有关,就先想一想 math。
比如:
平方根 圆周率 取整 幂 三角函数 对数
你不一定现在都要会写,但至少脑子里知道: 这些不是只能自己从零算,标准库里有现成工具。
这就够重要了。
六、现在转到 statistics:为什么数据一多,统计就很自然会出现
前面学列表时,你已经会 sum(),也会 len()。 所以很多人会想,平均值我自己算不就行了吗:
scores = [80, 90, 85]avg = sum(scores) / len(scores)print(avg)
当然可以。 但如果统计需求稍微多一点,比如:
平均值 中位数 众数 方差 标准差
你就会发现,自己手搓很麻烦。
这时候就轮到 statistics 模块出场了。
你可以把它理解成:
Python 标准库里专门做基础统计计算的小工具箱。
导入方式:
import statistics
七、最常见的函数:mean()
如果你想求平均值,可以直接这样写:
import statisticsscores = [80, 90, 85, 95, 70]print(statistics.mean(scores))
输出结果:
84
这个函数的价值不只是“少写一点代码”,更重要的是它的语义非常明确。
别人一看:
statistics.mean(scores)
就知道你在求平均值。
而不是先看到:
sum(scores) / len(scores)
再自己脑补你是想求平均值。
所以这也是标准库很大的一个价值:
不仅帮你省事,也让代码表达更直接。
八、第二个高频函数:median()
如果你想求中位数,可以用:
import statisticsnums = [1, 3, 5, 7, 100]print(statistics.median(nums))
输出结果:
5
中位数特别适合什么场景?
当一组数据里有明显异常值时,中位数往往比平均值更能反映“中间水平”。
比如上面那组数,100 明显偏大。 如果你只看平均值,可能会被它拉高很多。 但中位数还是稳定地落在 5。
这就说明,statistics 模块不仅是在帮你算数,它还在帮你更合理地看数据。
九、第三个常见函数:mode()
如果你想找一组数据里出现最频繁的值,也就是众数,可以用:
import statisticsnums = [1, 2, 2, 3, 3, 3, 4]print(statistics.mode(nums))
输出结果:
3
因为 3 出现次数最多。
这个能力在很多场景里都很有意思,比如:
统计最常见成绩段 统计用户最常见选择 统计文本里最频繁类型 找一组记录里最集中出现的值
它不像平均值那么“天天都用”,但一旦遇到对应问题,就很顺手。
十、statistics 模块真正值钱的地方是什么
不是帮你少写两行公式,而是帮你把“基础统计”这件事写得更清楚。
比如:
statistics.mean(data)statistics.median(data)statistics.mode(data)
这些代码一看就知道在干什么。 这和很多标准库一样,价值不仅在于结果,还在于表达力。
所以你现在对 statistics 的第一感觉应该是:
一旦开始处理一组数字,并且想做基础统计,就先想到它。
十一、现在进入 collections:为什么有时候内置 list 和 dict 还不够顺手
前面你已经学过:
列表 list字典 dict元组 tuple集合 set
这些当然非常重要,而且很多时候已经够用了。 但真实开发里,有些小需求如果你硬用原生列表和字典来写,会有点别扭。
比如:
我想统计每个元素出现了多少次 我想让字典的默认值自动就是 0 我想要一个两端都方便增删的队列 我想把多个值按键分组收集起来
这些时候,collections 就会特别好用。
你可以把它理解成:
标准库里对常见数据结构的增强版工具箱。
导入方式通常是按需拿具体对象,比如:
from collections import Counter, defaultdict, deque
十二、collections 里最值得先认识的:Counter
Counter 几乎是这个模块里最适合入门的东西。
看例子:
from collections import Counterletters = ['a', 'b', 'a', 'c', 'b', 'a']result = Counter(letters)print(result)
输出结果通常类似:
Counter({'a': 3, 'b': 2, 'c': 1})
它在干什么?
它在自动统计每个元素出现了多少次。
你如果不用 Counter,也能自己写:
letters = ['a', 'b', 'a', 'c', 'b', 'a']count_dict = {}for item in letters:if item in count_dict: count_dict[item] += 1else: count_dict[item] = 1print(count_dict)
这当然没错。 但 Counter 一行就能做完,而且语义非常明确。
所以它特别适合:
词频统计 字符频率统计 成绩分布统计 投票结果统计 日志级别次数统计
只要你遇到“统计出现次数”这个需求,脑子里几乎就该先想到它。
十三、Counter 再看一个特别有感觉的例子
比如统计一句话里每个字符出现多少次:
from collections import Countertext = 'banana'result = Counter(text)print(result)
输出可能是:
Counter({'a': 3, 'n': 2, 'b': 1})
你会发现,这种需求如果自己手写当然可以,但 Counter 用起来会特别自然。
而且它还特别适合做数据分析入门时的小统计。
十四、第二个特别常见的:defaultdict
有时候你会写这种代码:
data = {}key = 'a'if key notin data: data[key] = 0data[key] += 1
或者你需要按组收集数据:
group = {}if key notin group: group[key] = []group[key].append(value)
这些写法都没错,但写多了会觉得有点啰嗦。
这时候 defaultdict 就会特别舒服。
比如:
from collections import defaultdictdata = defaultdict(int)data['a'] += 1data['a'] += 1data['b'] += 1print(data)
输出通常类似:
defaultdict(<class 'int'>, {'a':2, 'b': 1})
这里为什么能直接加 1?
因为:
defaultdict(int)
会让不存在的键默认值就是 int(),也就是 0。
所以你不需要每次都先写“如果不存在就设成 0”。 这会让计数、分组类代码干净很多。
十五、defaultdict 在分组场景里特别好用
比如你想按班级收集学生名单。
from collections import defaultdictstudents = [ ('一班', '张三'), ('二班', '李四'), ('一班', '王五'), ('二班', '赵六'), ('三班', '小明')]group = defaultdict(list)for class_name, student_name in students: group[class_name].append(student_name)print(group)
输出结果通常类似:
defaultdict(<class 'list'>, {'一班': ['张三', '王五'], '二班': ['李四', '赵六'], '三班': ['小明']})
这就特别有感觉了。
你不用每次手动判断字典里有没有这个键。 因为 defaultdict(list) 会让新键默认就是一个空列表。
这在数据分组时非常常见。
十六、第三个很实用的:deque
deque 你现在可以先把它理解成:
比普通列表更适合做队列操作的结构。
例如:
from collections import dequeq = deque([1, 2, 3])q.append(4)q.appendleft(0)print(q)
输出结果通常类似:
deque([0, 1, 2, 3, 4])
这里你会发现,它除了像列表一样能在右边加元素,还能很方便地在左边加元素:
appendleft()
同理,也可以从左边弹出:
popleft()
这在队列、任务调度、消息缓存这类场景里特别常见。
你现在不用马上把它用到多复杂,但至少要知道:
如果一个结构需要经常“左进左出”或者“两端都高频操作”,deque 往往比普通列表更合适。
十七、这三个模块该怎么建立整体感觉
你现在可以先这样分工记忆:
math负责更正式一点的数学计算
statistics负责对一组数字做基础统计
collections负责更顺手的数据结构工具
如果你把这三个模块的角色分清了,后面再遇到具体需求时,脑子里就不会一片空白。
比如:
“我要平方根” 想到 math
“我要平均值、中位数” 想到 statistics
“我要统计频次、自动分组” 想到 collections
这就够有用了。
十八、做一个小综合案例:统计成绩信息
下面这个例子很适合把三者串一下。
import statisticsfrom collections import Counterscores = [80, 90, 85, 90, 70, 85, 90]print('平均分:', statistics.mean(scores))print('中位数:', statistics.median(scores))print('众数:', statistics.mode(scores))score_count = Counter(scores)print('各分数出现次数:', score_count)
输出结果可能是:
平均分: 84.28571428571429中位数: 85众数: 90各分数出现次数: Counter({90: 3, 85: 2, 80: 1, 70: 1})
你看,这已经开始有“数据分析味道”了。
平均分用 statistics中位数用 statistics众数用 statistics频次统计用 Counter
这就是标准库真正好用的地方。 不是单点炫技,而是多个工具自然配合。
十九、再做一个 math 和 collections 的组合例子
比如统计一组圆的半径,并计算面积。
import mathfrom collections import Counterradii = [1, 2, 2, 3, 3, 3]areas = []for r in radii: area = math.pi * r * r areas.append(round(area, 2))print('面积列表:', areas)radius_count = Counter(radii)print('半径出现次数:', radius_count)
这个例子虽然简单,但也很能说明问题:
数学计算用 math计数统计用 Counter
一旦标准库意识建立起来,你就会越来越自然地这样组合模块,而不是所有事情都从零写。
二十、本章小练习
你可以做两个非常适合巩固的练习。
第一个练习:
准备一组成绩列表。 用 statistics 算出平均值、中位数、众数。 再用 Counter 统计每个分数出现了几次。
第二个练习:
准备一个半径列表。 用 math.pi 计算每个圆的面积。 再用 math.ceil() 和 math.floor() 看看面积向上取整和向下取整后的结果。
这两个练习,一个偏统计,一个偏数学计算,能把这一章的主线练得很扎实。
二十一、本章总结
这一章,我们把三个非常实用的标准库模块放在一起做了第一次系统认识。
math 适合做正式数学计算,常用的有 sqrt()、ceil()、floor()、pow()、pi。statistics 适合做基础统计,常用的有 mean()、median()、mode()。collections 提供了更好用的数据结构工具,其中最值得先掌握的是 Counter、defaultdict、deque。 它们的共同价值,不是为了显得高级,而是为了让代码更短、更清楚、更接近真实开发。 真正重要的不是一次记住全部函数,而是建立一种思路:遇到数学、统计、计数、分组、双端队列这些问题时,先想一想标准库里是不是已经有合适工具。
下一章我们继续往前走,进入这一阶段的收束内容:090|模块与标准库实战:写出更像“正式项目”的代码。
 10个月宝宝每天需要喝多少奶粉?