DuckDB 的 Python 包今天合并了一个大 PR:把底层绑定从 pybind11 换成了 nanobind。
听起来像是"换了个依赖",实际上改了 231 个文件,+5126 / -3891 行,拆成了 50 个 commit,作者是 DuckDB 团队成员 Evert Lammerts。
为什么换?
pybind11 是 C 和 Python 之间的"翻译官"——C 写的 DuckDB 内核要对 Python 暴露 API,全靠 pybind11 做中间层。这东西用了快十年,稳定性没得说,但它慢。编译慢、生成的 wheel 大、运行时的类型转换也有开销。
nanobind 是 pybind11 原作者 Wenzel Jakob 写的新一代替代品。同一个人的作品,但这次从零重写,解决的全是 pybind11 的遗留问题:
- 编译快 2-3 倍。DuckDB Python 的 CI 构建时间会有明显改善。
-
- 生成的二进制更小。对
pip install duckdb 的用户来说,wheel 下载更快。 -
- 运行时开销更低。Python↔C++ 之间的函数调用、类型转换,nanobind 都做了精简。
-
- 更好的类型安全。nanobind 在编译期就能捕获更多类型错误。
换绑定层不会给用户带来新功能,编译速度的提升用户也感知不到。但团队还是做了——231 个文件的重写。他们觉得 pybind11 的包袱值得扔掉。
具体什么时候发布还不确定,但代码已经在 main 分支了。下一个 DuckDB 版本的 Python 包,底层就是 nanobind。
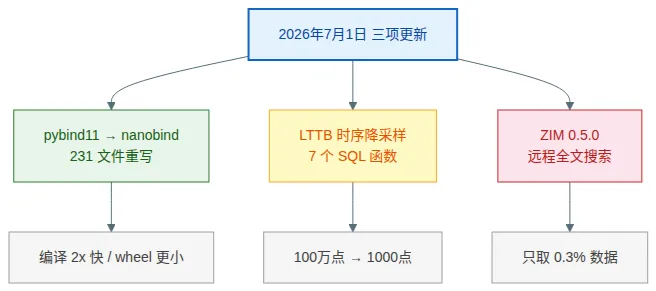
同一天,DuckDB 社区扩展目录也多了两个新面孔。
● ● ●
LTTB:时序数据的降采样算法
如果你做过时序数据的可视化,大概率用过 LTTB(Largest Triangle Three Buckets)。这是降采样领域的"标准答案"——把 100 万个数据点压缩到 1000 个,同时保留原始曲线的视觉特征。
以前你得在 Python 里用 tsdownsample 之类的库做这件事。现在可以在 SQL 里直接写了:
SELECT lttb(time, value, 1000) FROM sensor_data;
扩展提供了 7 个函数:lttb、largestTriangleThreeBuckets、lttb_sorted、lttb_indices、minmax_lttb、minmax_lttb_sorted、bucket_stats。降采样、看索引、查桶统计,一条 SQL 搞定。
仓库:github.com/reformovo/duckdb-lttb
● ● ●
ZIM 0.5.0:远程全文搜索
ZIM 格式你可能不熟,但一定用过它的产物——离线 Wikipedia、Kiwix 浏览器里的百科全书,都是 ZIM 文件。
DuckDB ZIM 扩展让你用 SQL 直接查这些离线档案。v0.5.0 的亮点是远程搜索:以前要搜索一个 2.2GB 的 ZIM 文件,得先下载整个 166MB 的 Xapian 全文索引;现在通过 HTTP 的 byte-range 请求,一次冷查询只取 ~0.3% 的数据。
SELECT zim_search('https://example.com/wiki.zim', 'DuckDB');
这背后是在 Xapian 上加了一层 RandomAccessReader,让搜索引擎可以按需读取远程索引而不是全部下载。对于归档类数据(百科全书、文档集合、离线知识库),这个优化把"能用"变成了"好用"。
仓库:github.com/teaguesterling/duckdb_zim
nanobind 的迁移,受益的是所有 Python 用户,虽然他们不会直接感知到。LTTB 扩展让时序降采样变成了一条 SQL 的事。ZIM 0.5.0 的远程搜索,用 0.3% 的数据回答了 100% 的查询——这是我最喜欢的那种优化。
三个 PR 都是同一天合并的。DuckDB 的下一个版本,值得等。
 10个月宝宝每天需要喝多少奶粉?