单细胞 Python 分析进阶:从单样本 pipeline 到多样本整合与批次矫正
单细胞 Python 分析系列第 5 篇上一篇我们详细介绍了 AnnData 数据结构,包括 adata.X、adata.obs、adata.var、layers、obsm、uns、obsp 等核心槽位。这一篇正式进入 Scanpy 的实战分析流程:单样本单细胞基础分析 pipeline、多样本读取与整合、批次效应矫正方法,以及 harmonypy / Harmony 完整整合流程。
很多同学从 Seurat 转到 Scanpy 时,最容易遇到 3 个问题:
本文就围绕这 3 个问题展开。
本文学习目标
读完这篇内容,你应该能够掌握:
第一部分:常见单细胞数据格式与读取方式
01 常见文件类型
单细胞数据下载后,常见格式主要有以下几类:
其中最常见的是:
barcodes.tsv.gzfeatures.tsv.gzmatrix.mtx.gz
也就是 10X mtx 标准格式。
有些 GEO 下载的数据文件名可能带有样本前缀,例如:
GSMxxxx_matrix.mtx.gzGSMxxxx_features.tsv.gzGSMxxxx_barcodes.tsv.gz
这种情况下,要么改成标准文件名,要么在读取时使用 prefix 参数。
02 读取 10X mtx 格式:sc.read_10x_mtx()
2.1 标准文件结构
标准 10X mtx 文件夹一般长这样:
sample1/├── barcodes.tsv.gz├── features.tsv.gz└── matrix.mtx.gz
读取代码:
import scanpy as scadata = sc.read_10x_mtx( ”sample1/”, var_names=”gene_symbols”, make_unique=True, cache=True)adata
2.2 sc.read_10x_mtx() 重要参数解释
sc.read_10x_mtx( path, var_names=”gene_symbols”, make_unique=True, cache=False, gex_only=True, prefix=None, compressed=True)
2.3 什么时候用 prefix?
如果文件名是:
GSM7429786_matrix.mtx.gzGSM7429786_features.tsv.gzGSM7429786_barcodes.tsv.gz
可以这样读:
adata = sc.read_10x_mtx( ”GSM7429786/”, var_names=”gene_symbols”, make_unique=True, prefix=”GSM7429786_”, compressed=True)
如果你已经把文件名改成标准名字:
matrix.mtx.gzfeatures.tsv.gzbarcodes.tsv.gz
就不需要 prefix。
03 读取 10X h5 文件:sc.read_10x_h5()
如果数据是 h5 格式:
filtered_feature_bc_matrix.h5
可以使用:
adata = sc.read_10x_h5(”filtered_feature_bc_matrix.h5”)adata.var_names_make_unique()adata
常见参数:
sc.read_10x_h5( filename, genome=None, gex_only=True)
大多数普通 scRNA-seq 数据直接写文件名即可。
04 读取 h5ad 文件:sc.read_h5ad()
.h5ad 是 AnnData 对象的保存格式。
读取:
adata = sc.read_h5ad(”adata.h5ad”)adata
保存:
adata.write_h5ad(”adata_processed.h5ad”)
.h5ad 的好处是可以保存完整 AnnData 对象,包括:
表达矩阵obs 细胞注释var 基因注释layersobsm 降维结果uns 分析结果obsp 邻接图
05 读取 txt / csv / tsv 表达矩阵
5.1 读取 txt 文件
adata = sc.read_text(”expression.txt”)
5.2 读取 csv 文件
adata = sc.read_csv(”expression.csv”)
5.3 读取 tsv 文件
Scanpy 中一般没有专门的 read_tsv() 函数。如果是制表符分隔文件,可以用:
adata = sc.read_csv( ”expression.tsv”, delimiter=”\t”)
也可以先用 pandas 读取,再转换成 AnnData:
import pandas as pdimport anndata as adexpr = pd.read_csv(”expression.tsv”, sep=”\t”, index_col=0)adata = ad.AnnData(expr)adata
这里要特别注意表达矩阵方向。
AnnData 需要:
如果你的矩阵是:
需要转置:
expr = expr.Tadata = ad.AnnData(expr)
第二部分:单样本单细胞基础分析 pipeline
下面以一个单样本 10X 数据为例,介绍完整 Scanpy 基础流程。
整体流程如下:
读取数据↓基因名去重↓基础质控↓计算线粒体比例↓质控可视化↓过滤低质量细胞和低表达基因↓保存原始 counts↓标准化和 log 转换↓高变基因筛选↓回归干扰因素、scale↓PCA 降维↓构建邻接图↓UMAP 可视化↓Leiden 聚类↓marker 基因分析↓保存 h5ad
06 环境准备
import scanpy as scimport pandas as pdimport numpy as npimport matplotlib.pyplot as pltimport ossc.settings.verbosity = 3sc.settings.set_figure_params(dpi=300, facecolor=”white”)sc.logging.print_versions()
函数解释
控制 Scanpy 输出信息的详细程度。
sc.settings.verbosity = 3
常见设置:
设置绘图参数。
sc.settings.set_figure_params( dpi=300, facecolor=”white”)
07 读取单样本数据
adata = sc.read_10x_mtx( ”/Users/aneszzz/Desktop/scpython/GSE294482_RAW/”, var_names=”gene_symbols”, cache=True)adata
如果是 h5 文件:
adata = sc.read_10x_h5(”filtered_feature_bc_matrix.h5”)
如果是 h5ad 文件:
adata = sc.read_h5ad(”adata.h5ad”)
08 基因名去重:adata.var_names_make_unique()
adata.var_names_make_unique()
作用
有些数据中可能存在重复 gene symbol。如果不处理,后续分析可能会报错或者产生 warning。
例如:
处理后可能变成:
建议读取数据后都运行一次。
09 将表达矩阵转换为整数类型
adata.X = adata.X.astype(”int32”)
作用
原始 UMI count 理论上是整数。如果读取后变成浮点型,可以转换为整数,方便后续使用 seurat_v3 等方法筛选高变基因。
注意:这一步只适合原始 counts 数据,不要对已经标准化或 log 转换后的矩阵做这个操作。
10 查看最高表达基因:sc.pl.highest_expr_genes()
sc.pl.highest_expr_genes( adata, n_top=20)
作用
查看表达量最高的基因,帮助判断数据中是否有异常高表达基因,例如:
参数解释
11 过滤低质量细胞和低表达基因
sc.pp.filter_cells(adata, min_genes=200)sc.pp.filter_genes(adata, min_cells=3)
11.1 sc.pp.filter_cells()
sc.pp.filter_cells( adata, min_counts=None, min_genes=None, max_counts=None, max_genes=None, inplace=True, copy=False)
参数解释
常用思路:
sc.pp.filter_cells(adata, min_genes=200)
表示保留至少检测到 200 个基因的细胞。
11.2 sc.pp.filter_genes()
sc.pp.filter_genes( adata, min_counts=None, min_cells=None, max_counts=None, max_cells=None, inplace=True, copy=False)
参数解释
常用写法:
sc.pp.filter_genes(adata, min_cells=3)
表示保留至少在 3 个细胞中表达的基因。
12 计算线粒体基因比例
12.1 标记线粒体基因
小鼠数据通常是:
adata.var[”mt”] = adata.var_names.str.startswith(”mt-”)
人类数据通常是:
adata.var[”mt”] = adata.var_names.str.startswith(”MT-”)
如果你不确定大小写,可以先查看:
也可以更稳妥地写:
adata.var[”mt”] = adata.var_names.str.upper().str.startswith(”MT-”)
12.2 计算 QC 指标
sc.pp.calculate_qc_metrics( adata, qc_vars=[”mt”], percent_top=None, log1p=False, inplace=True)
参数解释
运行后会在 adata.obs 中生成:
n_genes_by_countstotal_countstotal_counts_mtpct_counts_mt
其中:
13 质控可视化
13.1 小提琴图
sc.pl.violin( adata, [”n_genes_by_counts”, ”total_counts”, ”pct_counts_mt”], jitter=0.4, multi_panel=True)
参数解释:
13.2 散点图
sc.pl.scatter( adata, x=”total_counts”, y=”pct_counts_mt”)sc.pl.scatter( adata, x=”total_counts”, y=”n_genes_by_counts”)
常用判断:
14 根据 QC 指标过滤细胞
示例:
adata = adata[ (adata.obs.n_genes_by_counts < 2500) & (adata.obs.pct_counts_mt < 5) & (adata.obs.n_genes_by_counts > 200), :].copy()adata
参数和逻辑解释
adata.obs.n_genes_by_counts < 2500
去掉检测基因数过高的细胞,可能是 doublet。
adata.obs.pct_counts_mt < 5
去掉线粒体比例过高的细胞。
adata.obs.n_genes_by_counts > 200
去掉检测基因太少的低质量细胞。
注意:
过滤阈值不是固定的,要根据自己的数据分布调整。不同组织、平台、测序深度,阈值都可能不同。
15 保存原始 counts 到 layers
adata.layers[”counts”] = adata.X.copy()
为什么要保存?
后面会对 adata.X 进行标准化和 log 转换,如果不保存原始 counts,后面想回到原始矩阵就很麻烦。
推荐习惯:
adata.layers[”counts”] = adata.X.copy()
这样:
adata.X 后续可以放 log-normalized 数据adata.layers[”counts”] 保存原始 counts
16 数据归一化:sc.pp.normalize_total()
sc.pp.normalize_total( adata, target_sum=1e4)
作用
不同细胞的测序深度不同。normalize_total() 会让每个细胞归一化到相同总量。
例如:
表示每个细胞标准化后总表达量约为 10000。
重要参数解释
sc.pp.normalize_total( adata, target_sum=1e4, exclude_highly_expressed=False, max_fraction=0.05, key_added=None, layer=None, inplace=True)
17 log 转换:sc.pp.log1p()
作用
对表达矩阵做:
这样可以压缩极高表达值,让数据更适合后续 PCA 和可视化。
常用写法:
sc.pp.normalize_total(adata, target_sum=1e4)sc.pp.log1p(adata)adata.layers[”lognorm”] = adata.X.copy()
18 高变基因筛选:sc.pp.highly_variable_genes()
sc.pp.highly_variable_genes( adata, layer=”counts”, n_top_genes=3000, flavor=”seurat_v3”, subset=True)
作用
单细胞数据中基因数量很多,很多基因对细胞分群贡献不大。高变基因筛选的目的是选择在细胞之间变异度较高的基因,用于 PCA 和聚类。
常用参数解释
sc.pp.highly_variable_genes( adata, layer=None, n_top_genes=None, min_mean=0.0125, max_mean=3, min_disp=0.5, flavor=”seurat”, subset=False, batch_key=None, inplace=True)
flavor 怎么选?
如果使用:
flavor=”seurat_v3”layer=”counts”
通常要求输入是原始 counts。
结果保存在哪里?
运行后会在 adata.var 中增加:
highly_variablemeansvariancesvariances_norm
或者对于部分 flavor:
dispersionsdispersions_norm
19 回归干扰因素:sc.pp.regress_out()
sc.pp.regress_out( adata, [”total_counts”, ”pct_counts_mt”])
作用
回归掉某些技术因素对表达矩阵的影响,例如:
total_countspct_counts_mtcell cycle score
参数解释
sc.pp.regress_out( adata, keys, n_jobs=None, copy=False)
注意:
回归不是必须步骤。如果回归变量和真实生物差异高度相关,可能会去掉真实信号。初学者可以先不回归,或者只在明确需要时使用。
20 scale 标准化:sc.pp.scale()
sc.pp.scale( adata, max_value=10)
作用
对每个基因进行标准化:
这样不同基因在 PCA 中具有可比性。
参数解释
21 PCA 降维:sc.pp.pca()
sc.pp.pca( adata, n_comps=50, svd_solver=”arpack”)
作用
PCA 是后续 neighbors、UMAP、聚类的基础。它把高维基因表达矩阵压缩为较少的主成分。
参数解释
运行后结果保存到:
adata.obsm[”X_pca”]adata.varm[”PCs”]adata.uns[”pca”]
查看 PCA 方差贡献:
sc.pl.pca_variance_ratio( adata, n_pcs=50)
22 构建邻接图:sc.pp.neighbors()
sc.pp.neighbors( adata, n_neighbors=10, n_pcs=40)
作用
根据 PCA 空间中的距离,构建细胞之间的近邻图。后续 UMAP 和 Leiden 聚类都依赖这个图。
参数解释
sc.pp.neighbors( adata, n_neighbors=15, n_pcs=None, use_rep=None, metric=None, random_state=0, key_added=None)
运行后保存到:
adata.obsp[”distances”]adata.obsp[”connectivities”]adata.uns[”neighbors”]
23 Leiden 聚类:sc.tl.leiden()
sc.tl.leiden( adata, resolution=1.0, key_added=”leiden”)
作用
根据邻接图对细胞进行聚类。
参数解释
sc.tl.leiden( adata, resolution=1.0, random_state=0, key_added=”leiden”, flavor=”igraph”, n_iterations=2, directed=False)
聚类结果保存到:
24 UMAP 可视化:sc.tl.umap()
如果前面使用了 PAGA,也可以:
sc.tl.umap( adata, init_pos=”paga”)
参数解释
UMAP 坐标保存到:
画图:
sc.pl.umap( adata, color=[”leiden”, ”Cd14”, ”Nkg7”])
25 PAGA 简介
sc.tl.paga(adata)sc.pl.paga(adata)sc.tl.umap(adata, init_pos=”paga”)
作用
PAGA 可以帮助观察 cluster 之间的连接关系,也可以作为 UMAP 初始化方式。
初学者可以先了解:
Leiden:细胞聚类PAGA:cluster 之间的拓扑关系UMAP:二维可视化
26 marker 基因分析:sc.tl.rank_genes_groups()
26.1 找每个 cluster 的 marker
sc.tl.rank_genes_groups( adata, groupby=”leiden”, method=”wilcoxon”)sc.pl.rank_genes_groups( adata, n_genes=25, sharey=False)
参数解释
sc.tl.rank_genes_groups( adata, groupby, groups=None, reference=”rest”, method=”wilcoxon”, use_raw=None, layer=None, pts=False, key_added=None)
常用方法
推荐初学者优先使用:
26.2 提取 marker 结果
markers = sc.get.rank_genes_groups_df( adata, group=None)markers.head()
保存:
markers.to_csv(”markers_all_clusters.csv”, index=False)
26.3 指定 cluster 之间比较
例如比较 cluster 0 和 cluster 1:
sc.tl.rank_genes_groups( adata, groupby=”leiden”, groups=[”0”], reference=”1”, method=”wilcoxon”)sc.pl.rank_genes_groups( adata, groups=[”0”], n_genes=20)
27 marker 可视化
小提琴图
sc.pl.violin( adata, [”Cd14”, ”Nkg7”], groupby=”leiden”)
dotplot
sc.pl.dotplot( adata, [”Cd14”, ”Nkg7”, ”Npas2”, ”Aff3”], groupby=”leiden”)
stacked violin
sc.pl.stacked_violin( adata, [”Cd14”, ”Nkg7”, ”Npas2”, ”Aff3”], groupby=”leiden”)
28 保存单样本分析结果
adata.write_h5ad(”single_sample_processed.h5ad”)
或者:
adata.write(”single_sample_processed.h5ad”)
下次直接读取:
adata = sc.read_h5ad(”single_sample_processed.h5ad”)
第三部分:单样本完整 pipeline 代码
下面是一份完整的单样本基础分析模板。
import scanpy as scimport pandas as pdimport numpy as npimport matplotlib.pyplot as pltimport os# 1. 基础设置sc.settings.verbosity = 3sc.settings.set_figure_params(dpi=300, facecolor=”white”)# 2. 读取数据adata = sc.read_10x_mtx( ”/Users/aneszzz/Desktop/scpython/GSE294482_RAW/”, var_names=”gene_symbols”, make_unique=True, cache=True)# 3. 基因名去重adata.var_names_make_unique()# 4. 如果是原始 counts,可转为整数adata.X = adata.X.astype(”int32”)# 5. 查看高表达基因sc.pl.highest_expr_genes(adata, n_top=20)# 6. 初步过滤sc.pp.filter_cells(adata, min_genes=200)sc.pp.filter_genes(adata, min_cells=3)# 7. 计算线粒体比例# 小鼠 mt-;人类 MT-adata.var[”mt”] = adata.var_names.str.upper().str.startswith(”MT-”)sc.pp.calculate_qc_metrics( adata, qc_vars=[”mt”], percent_top=None, log1p=False, inplace=True)# 8. QC 可视化sc.pl.violin( adata, [”n_genes_by_counts”, ”total_counts”, ”pct_counts_mt”], jitter=0.4, multi_panel=True)sc.pl.scatter(adata, x=”total_counts”, y=”pct_counts_mt”)sc.pl.scatter(adata, x=”total_counts”, y=”n_genes_by_counts”)# 9. 根据 QC 过滤adata = adata[ (adata.obs.n_genes_by_counts > 200) & (adata.obs.n_genes_by_counts < 2500) & (adata.obs.pct_counts_mt < 5), :].copy()# 10. 保存原始 countsadata.layers[”counts”] = adata.X.copy()# 11. 标准化和 log 转换sc.pp.normalize_total(adata, target_sum=1e4)sc.pp.log1p(adata)adata.layers[”lognorm”] = adata.X.copy()# 12. 高变基因sc.pp.highly_variable_genes( adata, layer=”counts”, n_top_genes=3000, flavor=”seurat_v3”, subset=True)sc.pl.highly_variable_genes(adata)# 13. 回归和 scale# 如果不想回归,可跳过 regress_outsc.pp.regress_out( adata, [”total_counts”, ”pct_counts_mt”])sc.pp.scale( adata, max_value=10)# 14. PCAsc.pp.pca( adata, n_comps=50, svd_solver=”arpack”)sc.pl.pca_variance_ratio(adata, n_pcs=50)# 15. 邻接图sc.pp.neighbors( adata, n_neighbors=10, n_pcs=40)# 16. 聚类sc.tl.leiden( adata, resolution=0.7, key_added=”leiden”, random_state=0, flavor=”igraph”, n_iterations=2, directed=False)# 17. UMAPsc.tl.umap(adata)sc.pl.umap( adata, color=[”leiden”, ”total_counts”, ”n_genes_by_counts”, ”pct_counts_mt”])# 18. marker 基因sc.tl.rank_genes_groups( adata, groupby=”leiden”, method=”wilcoxon”)sc.pl.rank_genes_groups( adata, n_genes=25, sharey=False)markers = sc.get.rank_genes_groups_df( adata, group=None)markers.to_csv(”markers_all_clusters.csv”, index=False)# 19. 保存adata.write_h5ad(”single_sample_processed.h5ad”)
第四部分:多样本数据读取和整合
单样本分析熟悉之后,就会进入多样本分析。
多样本分析常见场景:
多个正常样本 + 多个疾病样本多个时间点样本多个处理组样本多个公开数据集多个测序批次
多样本分析的核心问题是:
既要保留真实生物差异,又要尽量减少技术批次效应。
29 多样本分析的基本思路
多样本 Scanpy 分析通常分为 5 步:
分别读取每个样本↓给每个样本添加 sample / group / batch 信息↓统一基因名并合并对象↓标准化、高变基因、PCA↓根据需要进行批次效应矫正↓使用矫正后的表示构建 neighbors、UMAP、聚类
30 多样本数据文件结构示例
假设有 4 个样本:
data/├── Ctrl1/│ ├── barcodes.tsv.gz│ ├── features.tsv.gz│ └── matrix.mtx.gz├── Ctrl2/│ ├── barcodes.tsv.gz│ ├── features.tsv.gz│ └── matrix.mtx.gz├── Treat1/│ ├── barcodes.tsv.gz│ ├── features.tsv.gz│ └── matrix.mtx.gz└── Treat2/ ├── barcodes.tsv.gz ├── features.tsv.gz └── matrix.mtx.gz
31 逐个读取样本并添加 metadata
import scanpy as scimport anndata as adfrom pathlib import Pathdata_dir = Path(”data”)sample_info = { ”Ctrl1”: {”path”: data_dir / ”Ctrl1”, ”group”: ”Control”, ”batch”: ”batch1”}, ”Ctrl2”: {”path”: data_dir / ”Ctrl2”, ”group”: ”Control”, ”batch”: ”batch1”}, ”Treat1”: {”path”: data_dir / ”Treat1”, ”group”: ”Treatment”, ”batch”: ”batch2”}, ”Treat2”: {”path”: data_dir / ”Treat2”, ”group”: ”Treatment”, ”batch”: ”batch2”},}adatas = {}for sample_id, info in sample_info.items(): adata_i = sc.read_10x_mtx( info[”path”], var_names=”gene_symbols”, make_unique=True, cache=True ) adata_i.var_names_make_unique() adata_i.obs[”sample”] = sample_id adata_i.obs[”group”] = info[”group”] adata_i.obs[”batch”] = info[”batch”]# 防止不同样本 barcode 重名 adata_i.obs_names = [f”{sample_id}_{bc}” for bc in adata_i.obs_names] adatas[sample_id] = adata_iadatas
32 多样本合并:ad.concat()
adata = ad.concat( adatas, label=”sample”, join=”inner”, merge=”same”, index_unique=”-”)adata.obs_names_make_unique()adata
参数解释
ad.concat( adatas, label=”sample”, keys=None, join=”inner”, merge=”same”, index_unique=”-”)
join="inner" 和 join="outer" 怎么选?
如果多个样本来自不同数据集或不同来源,建议先用:
也就是对 var_names 取交集,方便后续批次效应矫正和整合。
33 合并后检查样本信息
adata.obs[”sample”].value_counts()
查看分组:
adata.obs[”group”].value_counts()
查看批次:
adata.obs[”batch”].value_counts()
画图检查每个样本细胞数:
adata.obs[”sample”].value_counts().plot(kind=”bar”)
34 多样本 QC:建议按样本查看
多样本数据不建议只看整体 QC,最好按样本查看。
adata.var[”mt”] = adata.var_names.str.upper().str.startswith(”MT-”)sc.pp.calculate_qc_metrics( adata, qc_vars=[”mt”], percent_top=None, log1p=False, inplace=True)sc.pl.violin( adata, [”n_genes_by_counts”, ”total_counts”, ”pct_counts_mt”], groupby=”sample”, rotation=45, multi_panel=True)
不同样本测序深度可能不同,所以阈值可以:
如果某个样本整体质量明显较差,要谨慎决定是否保留。
35 多样本过滤
统一过滤示例:
adata = adata[ (adata.obs.n_genes_by_counts > 200) & (adata.obs.n_genes_by_counts < 6000) & (adata.obs.pct_counts_mt < 10), :].copy()sc.pp.filter_genes(adata, min_cells=3)
如果不同样本差异特别大,也可以先分样本过滤后再合并。
36 多样本标准化和高变基因
adata.layers[”counts”] = adata.X.copy()sc.pp.normalize_total( adata, target_sum=1e4)sc.pp.log1p(adata)adata.layers[”lognorm”] = adata.X.copy()
多样本筛选高变基因时,推荐使用 batch_key:
sc.pp.highly_variable_genes( adata, n_top_genes=3000, batch_key=”sample”, flavor=”seurat_v3”, layer=”counts”, subset=False)adata = adata[:, adata.var[”highly_variable”]].copy()
为什么用 batch_key?
如果不加 batch_key,高变基因可能被某一个样本或批次主导。加上 batch_key 后,会在每个样本/批次内分别筛选高变基因,再合并结果。
第五部分:批次效应是什么?
37 什么是批次效应?
批次效应是指由于非生物学因素导致的数据差异,例如:
不同测序批次不同实验人员不同建库时间不同测序平台不同组织消化强度不同数据来源
在 UMAP 上可能表现为:
同一种细胞类型按样本分开不同样本之间完全不混合cluster 主要由 sample 决定,而不是由 cell type 决定
38 批次效应和真实生物差异的区别
这是多样本整合中最关键的问题。
最危险的情况是:
Control 全部来自 batch1Disease 全部来自 batch2
这时 batch 和 group 完全混杂,任何算法都很难判断差异来自疾病还是批次。
39 什么时候需要批次矫正?
建议先做一个“不矫正版本”观察:
sc.pp.scale(adata, max_value=10)sc.pp.pca(adata)sc.pp.neighbors(adata, n_neighbors=15, n_pcs=40)sc.tl.umap(adata)sc.pl.umap(adata, color=[”sample”, ”group”])
如果 UMAP 中主要按 sample 分开,而不是按细胞类型分开,说明可能有明显批次效应。
如果样本之间混合良好,未必需要强行矫正。
第六部分:常见批次效应矫正方法
40 方法一:batch_key 高变基因筛选
sc.pp.highly_variable_genes( adata, n_top_genes=3000, batch_key=”sample”, flavor=”seurat_v3”, layer=”counts”)
特点
41 方法二:ComBat
sc.pp.combat( adata, key=”batch”)
特点
42 方法三:BBKNN
import scanpy.external as scesce.pp.bbknn( adata, batch_key=”batch”, n_pcs=40)
特点
sc.tl.umap(adata)sc.tl.leiden(adata)
43 方法四:Harmony / harmonypy
import scanpy.external as scesce.pp.harmony_integrate( adata, key=”batch”, basis=”X_pca”, adjusted_basis=”X_pca_harmony”)
特点
adata.obsm[”X_pca_harmony”]
后续 neighbors 要使用:
sc.pp.neighbors( adata, use_rep=”X_pca_harmony”)
Harmony 的推荐位置是:
normalize/log1p → HVG → scale → PCA → Harmony → neighbors → UMAP/Leiden
也就是说,Harmony 要放在 PCA 之后、neighbors 之前。
44 方法五:Scanorama
import scanpy.external as scesce.pp.scanorama_integrate( adata, key=”batch”, basis=”X_pca”, adjusted_basis=”X_scanorama”)
特点
45 方法六:MNN
import scanpy.external as scecorrected = sce.pp.mnn_correct( adata1, adata2, adata3)
特点
- 基于 mutual nearest neighbors;
- 不建议把 corrected expression 直接用于最终差异表达检验。
46 方法七:scVI
import scviscvi.model.SCVI.setup_anndata( adata, layer=”counts”, batch_key=”batch”)model = scvi.model.SCVI(adata)model.train()adata.obsm[”X_scVI”] = model.get_latent_representation()
后续:
sc.pp.neighbors( adata, use_rep=”X_scVI”)sc.tl.umap(adata)sc.tl.leiden(adata)
特点
47 批次矫正方法怎么选?
推荐初学者优先掌握:
其中 Harmony 最适合先上手。
48 批次矫正后的注意事项
批次矫正不是越强越好。
需要注意:
第七部分:使用 Harmony / harmonypy 的完整多样本 pipeline
下面给出一套完整代码,适合多个 10X 样本整合。
49 安装依赖
pip install scanpy harmonypy leidenalg igraph
或者:
conda install -c conda-forge scanpy harmonypy python-igraph leidenalg
50 Harmony 完整 pipeline:推荐版
import scanpy as scimport scanpy.external as sceimport anndata as adimport pandas as pdimport numpy as npfrom pathlib import Pathimport matplotlib.pyplot as plt# ------------------------------------------------------------# 1. 基础设置# ------------------------------------------------------------sc.settings.verbosity = 3sc.settings.set_figure_params(dpi=300, facecolor=”white”)# ------------------------------------------------------------# 2. 设置样本信息# ------------------------------------------------------------data_dir = Path(”data”)sample_info = { ”Ctrl1”: { ”path”: data_dir / ”Ctrl1”, ”group”: ”Control”, ”batch”: ”batch1” }, ”Ctrl2”: { ”path”: data_dir / ”Ctrl2”, ”group”: ”Control”, ”batch”: ”batch1” }, ”Treat1”: { ”path”: data_dir / ”Treat1”, ”group”: ”Treatment”, ”batch”: ”batch2” }, ”Treat2”: { ”path”: data_dir / ”Treat2”, ”group”: ”Treatment”, ”batch”: ”batch2” }}# ------------------------------------------------------------# 3. 逐个读取样本# ------------------------------------------------------------adatas = {}for sample_id, info in sample_info.items(): print(f”Reading {sample_id} ...”) adata_i = sc.read_10x_mtx( info[”path”], var_names=”gene_symbols”, make_unique=True, cache=True ) adata_i.var_names_make_unique()# 添加样本信息 adata_i.obs[”sample”] = sample_id adata_i.obs[”group”] = info[”group”] adata_i.obs[”batch”] = info[”batch”]# 防止 barcode 重名 adata_i.obs_names = [f”{sample_id}_{bc}” for bc in adata_i.obs_names]# 保存 adatas[sample_id] = adata_i# ------------------------------------------------------------# 4. 合并多个样本# ------------------------------------------------------------adata = ad.concat( adatas, label=”sample_from_concat”, join=”inner”, merge=”same”, index_unique=”-”)adata.obs_names_make_unique()print(adata)print(adata.obs[”sample”].value_counts())print(adata.obs[”group”].value_counts())print(adata.obs[”batch”].value_counts())# ------------------------------------------------------------# 5. 基础 QC# ------------------------------------------------------------# 人和小鼠均可用这种写法adata.var[”mt”] = adata.var_names.str.upper().str.startswith(”MT-”)sc.pp.calculate_qc_metrics( adata, qc_vars=[”mt”], percent_top=None, log1p=False, inplace=True)# QC 可视化sc.pl.violin( adata, [”n_genes_by_counts”, ”total_counts”, ”pct_counts_mt”], groupby=”sample”, rotation=45, multi_panel=True)sc.pl.scatter( adata, x=”total_counts”, y=”pct_counts_mt”, color=”sample”)sc.pl.scatter( adata, x=”total_counts”, y=”n_genes_by_counts”, color=”sample”)# ------------------------------------------------------------# 6. 过滤细胞和基因# ------------------------------------------------------------adata = adata[ (adata.obs.n_genes_by_counts > 200) & (adata.obs.n_genes_by_counts < 6000) & (adata.obs.pct_counts_mt < 10), :].copy()sc.pp.filter_genes( adata, min_cells=3)print(adata)# ------------------------------------------------------------# 7. 保存原始 counts# ------------------------------------------------------------adata.layers[”counts”] = adata.X.copy()# ------------------------------------------------------------# 8. 标准化和 log 转换# ------------------------------------------------------------sc.pp.normalize_total( adata, target_sum=1e4)sc.pp.log1p(adata)adata.layers[”lognorm”] = adata.X.copy()# 也可以保存一份 raw,方便后续画基因表达adata.raw = adata.copy()# ------------------------------------------------------------# 9. 多样本高变基因# ------------------------------------------------------------sc.pp.highly_variable_genes( adata, layer=”counts”, flavor=”seurat_v3”, n_top_genes=3000, batch_key=”sample”, subset=False)sc.pl.highly_variable_genes(adata)# 只保留高变基因用于 PCA 和整合adata = adata[:, adata.var[”highly_variable”]].copy()# ------------------------------------------------------------# 10. scale 和 PCA# ------------------------------------------------------------# 回归不是必须的,先保守使用 scale 即可sc.pp.scale( adata, max_value=10)sc.pp.pca( adata, n_comps=50, svd_solver=”arpack”)sc.pl.pca_variance_ratio( adata, n_pcs=50)# ------------------------------------------------------------# 11. 矫正前先看一次 UMAP# ------------------------------------------------------------sc.pp.neighbors( adata, n_neighbors=15, n_pcs=40)sc.tl.umap(adata)sc.pl.umap( adata, color=[”sample”, ”batch”, ”group”], wspace=0.4)# ------------------------------------------------------------# 12. Harmony 批次矫正# ------------------------------------------------------------sce.pp.harmony_integrate( adata, key=”batch”, basis=”X_pca”, adjusted_basis=”X_pca_harmony”, max_iter_harmony=20)# 检查是否生成adata.obsm[”X_pca_harmony”].shape# ------------------------------------------------------------# 13. 使用 Harmony 后的 PCA 构建邻接图# ------------------------------------------------------------sc.pp.neighbors( adata, n_neighbors=15, use_rep=”X_pca_harmony”)sc.tl.umap( adata, random_state=0)sc.tl.leiden( adata, resolution=0.7, key_added=”leiden_harmony”, random_state=0, flavor=”igraph”, n_iterations=2, directed=False)# ------------------------------------------------------------# 14. 可视化整合效果# ------------------------------------------------------------sc.pl.umap( adata, color=[”sample”, ”batch”, ”group”, ”leiden_harmony”], wspace=0.4)# 可以查看常见 markersc.pl.umap( adata, color=[”Cd3d”, ”Nkg7”, ”Lyz2”, ”Ms4a1”], use_raw=True, wspace=0.4)# ------------------------------------------------------------# 15. marker 基因分析# ------------------------------------------------------------# 注意:Harmony 只用于构建低维表示和聚类# marker 分析仍然建议使用表达矩阵,比如 raw 或 lognormsc.tl.rank_genes_groups( adata, groupby=”leiden_harmony”, method=”wilcoxon”, use_raw=True)sc.pl.rank_genes_groups( adata, n_genes=25, sharey=False)markers = sc.get.rank_genes_groups_df( adata, group=None)markers.to_csv( ”markers_leiden_harmony.csv”, index=False)# ------------------------------------------------------------# 16. 保存最终对象# ------------------------------------------------------------adata.write_h5ad( ”multi_sample_harmony_processed.h5ad”)
51 直接使用 harmonypy 的写法
上面使用的是 Scanpy 封装好的:
sce.pp.harmony_integrate()
如果想直接调用 harmonypy,可以这样写:
import harmonypy as hm# adata.obsm[”X_pca”] 是细胞 × PC# harmonypy 需要传入 PCA 矩阵和 metadataho = hm.run_harmony( adata.obsm[”X_pca”], adata.obs, vars_use=[”batch”])# ho.Z_corr 通常是 PC × cell,因此需要转置adata.obsm[”X_pca_harmony”] = ho.Z_corr.T# 后续使用 Harmony 矫正后的 PCAsc.pp.neighbors( adata, use_rep=”X_pca_harmony”, n_neighbors=15)sc.tl.umap(adata)sc.tl.leiden( adata, resolution=0.7, key_added=”leiden_harmony”)sc.pl.umap( adata, color=[”sample”, ”batch”, ”group”, ”leiden_harmony”])
52 Harmony 关键参数解释
在 scanpy.external.pp.harmony_integrate() 中:
sce.pp.harmony_integrate( adata, key=”batch”, basis=”X_pca”, adjusted_basis=”X_pca_harmony”, max_iter_harmony=20)
常用入门参数:
sce.pp.harmony_integrate( adata, key=”batch”, adjusted_basis=”X_pca_harmony”)
如果批次效应较强,可以尝试调大:
或者:
但不建议盲目过度矫正。
53 Harmony 整合前后如何判断效果?
至少看 4 张图:
sc.pl.umap( adata, color=[”sample”, ”batch”, ”group”, ”leiden_harmony”])
还要看 marker 基因:
sc.pl.umap( adata, color=[”Cd3d”, ”Nkg7”, ”Lyz2”, ”Ms4a1”], use_raw=True)
判断标准:
54 不建议做什么?
54.1 不建议矫正后直接做组间差异表达
Harmony 校正的是 PCA 低维空间,不是原始表达矩阵。因此 marker 和差异表达仍建议使用:
raw countslog-normalized expressionpseudo-bulk
而不是使用 Harmony 后的 PCA。
54.2 不建议把 group 当作 batch 直接矫正
如果你的研究目的是比较:
不要简单把 group 当作 batch 去 Harmony:
否则可能把真实疾病差异也去掉。
应该矫正的是:
而不是你的主要生物学分组。
54.3 不建议只看一张 UMAP 判断整合好坏
整合效果不能只看 UMAP。还要结合:
sample 混合情况batch 混合情况细胞类型 markercluster 合理性每个样本的细胞组成生物学分组是否仍有差异
第八部分:多样本分析推荐实践
55 推荐保留的 metadata
在多样本分析中,至少建议保留以下列:
samplegroupbatchdatasetconditionpatienttissuetimepoint
例如:
adata.obs[[”sample”, ”group”, ”batch”]].head()
后续所有可视化、分组统计、细胞比例分析、差异分析都会用到这些信息。
56 推荐保存多个中间文件
多样本分析比较耗时,建议保存关键中间结果。
adata.write_h5ad(”01_merged_raw_qc.h5ad”)adata.write_h5ad(”02_normalized_hvg_pca.h5ad”)adata.write_h5ad(”03_harmony_integrated.h5ad”)adata.write_h5ad(”04_final_cluster_marker.h5ad”)
这样后续不需要每次从头运行。
57 推荐流程总结
单样本流程
读取数据↓QC↓过滤↓normalize + log1p↓HVG↓PCA↓neighbors↓UMAP↓Leiden↓marker
多样本 Harmony 流程
读取每个样本↓添加 sample / group / batch↓合并 AnnData↓QC 和过滤↓保存 counts↓normalize + log1p↓batch-aware HVG↓scale + PCA↓Harmony↓neighbors(use_rep=”X_pca_harmony”)↓UMAP + Leiden↓marker + 注释
58 本篇小结
这一篇主要介绍了:
对于初学者来说,最推荐先掌握这条主线:
read_10x_mtx / read_10x_h5↓QC↓normalize_total + log1p↓highly_variable_genes↓pca↓harmony_integrate↓neighbors(use_rep=”X_pca_harmony”)↓umap + leiden↓rank_genes_groups
只要这条主线清楚,后续再学习细胞注释、细胞比例、差异分析、拟时序、细胞通讯和空间转录组都会更容易。
59 学习五问
如果你能回答这 5 个问题,说明你已经掌握了单样本和多样本整合的核心流程。
60 下期预告
下一篇可以继续进入:
包括:
marker 基因注释DotPlot / Violin / UMAP 辅助判断参考数据库注释SingleR / CellTypist / scType注释结果的整理和可视化
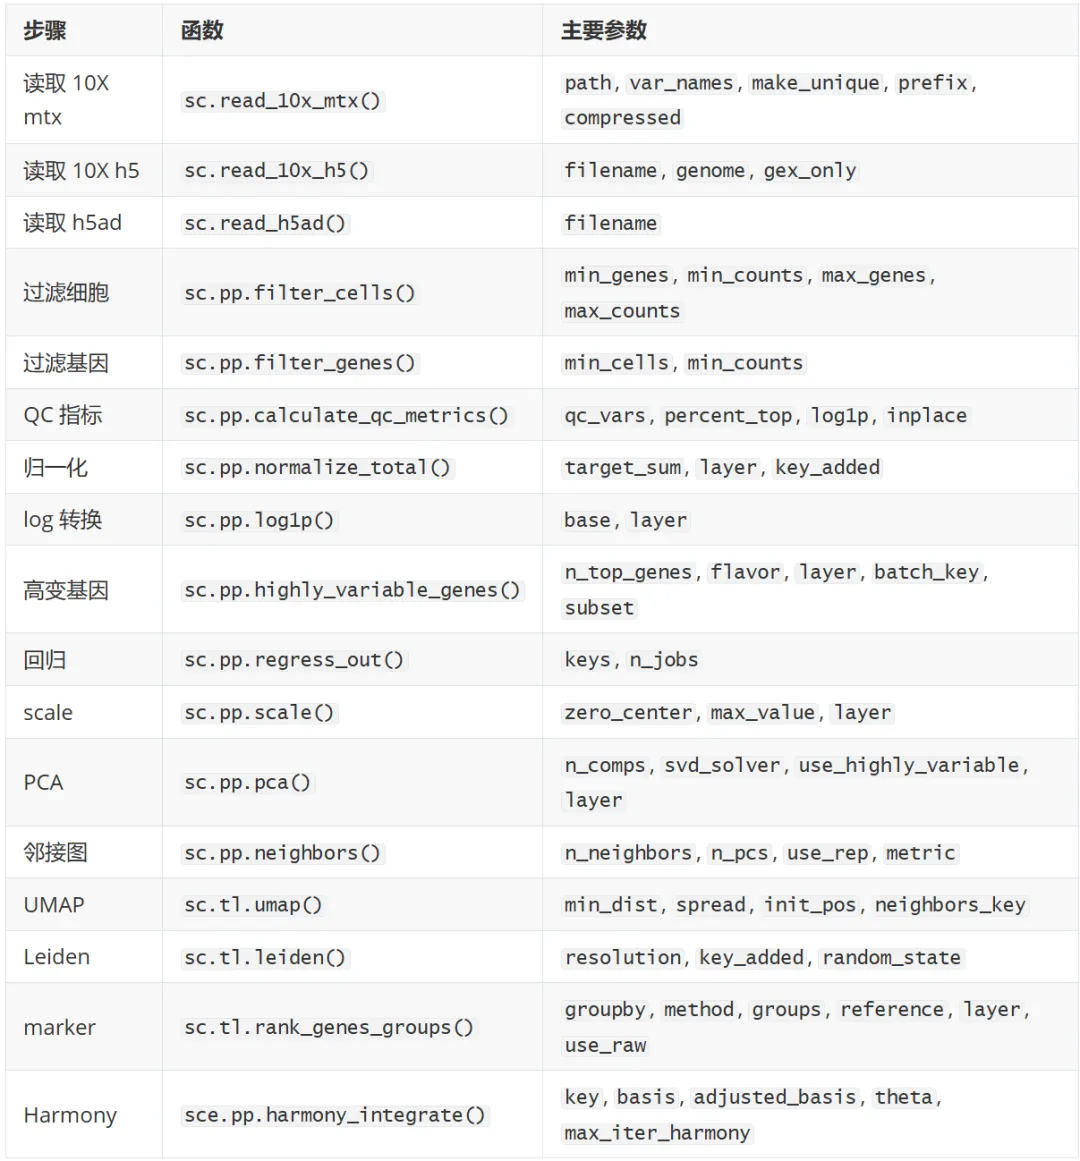
附录:常用函数速查表
参考资料
-
Scanpy read_10x_mtx 官方文档
Scanpy preprocessing and clustering 官方教程
Scanpy normalize_total 官方文档
Scanpy highly_variable_genes 官方文档
Scanpy neighbors 官方文档
Scanpy harmony_integrate 官方文档
harmonypy GitHub
scvi-tools 官方网站