Windows本地用python+spark读取hive表
- 2026-09-09 17:32:23
之前分享过在Windows本地用RDD或DataFrame处理远程hdfs文件的过程Windows本地用DataFrame读写hdfs,但一般情况下我们不会直接访问底层hdfs文件,而是读取hive表,并用spark引擎进行处理,针对这个应用场景,分享几个实现方法。
背景条件
spark:3.5.8版本,安装和启动服务的过程见:基于已有的Hadoop和Hive安装Spark
python:3.13.14版本
pyhive:0.7.0版本
pyspark:3.5.8版本
下面是4种方式和详细步骤。
一、spark thrift
类似于jdbc连接mysql或者hive的操作,用Python代码可以直连spark thrift服务,然后用游标执行代码。这种方式需要首先安装下面几个Python库:
pip install pyhive thrift sasl thrift-sasl
准备代码文件spark_read_hive_table.py,内容:
from pyhive import hiveconn = hive.Connection( host='hadoop-nn1', port=10000, username="hadoop", database="default")cursor = conn.cursor()sql = ''' select /*+MAPJOIN(h)*/ o.order_id , o.order_amt , o.user_id , u.username from ods.ods_trade_order_info o left join tmp.hot_key h on o.user_id = h.user_id left join ods.ods_trade_user_info u on o.user_id = u.id where h.user_id is NULL limit 109 '''cursor.execute(sql)for row in cursor:print(row)cursor.close()
执行结果:
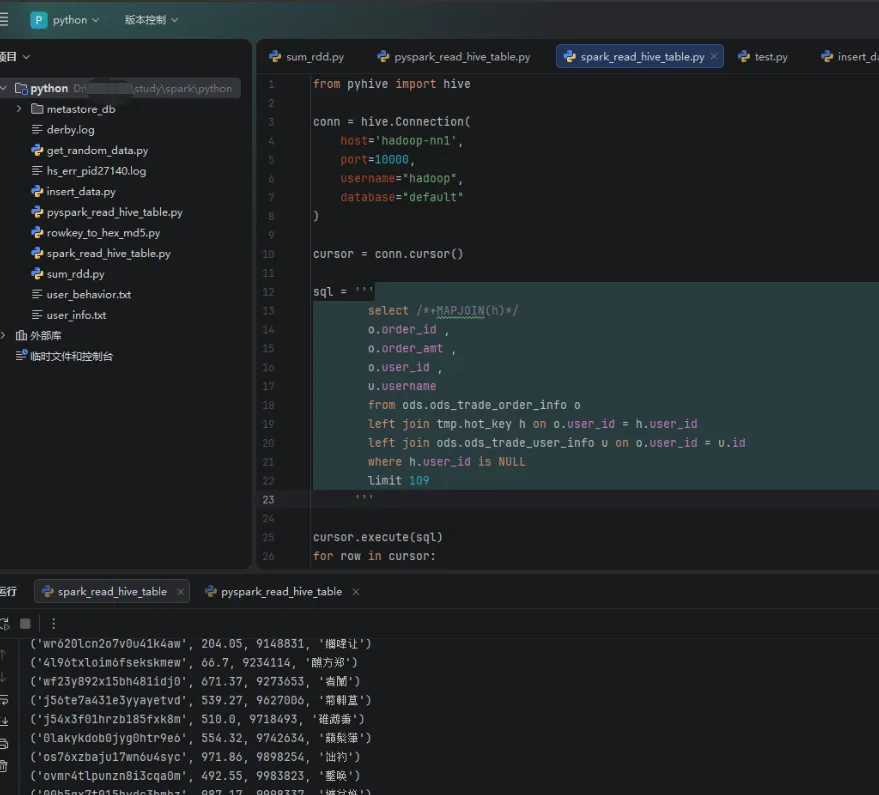
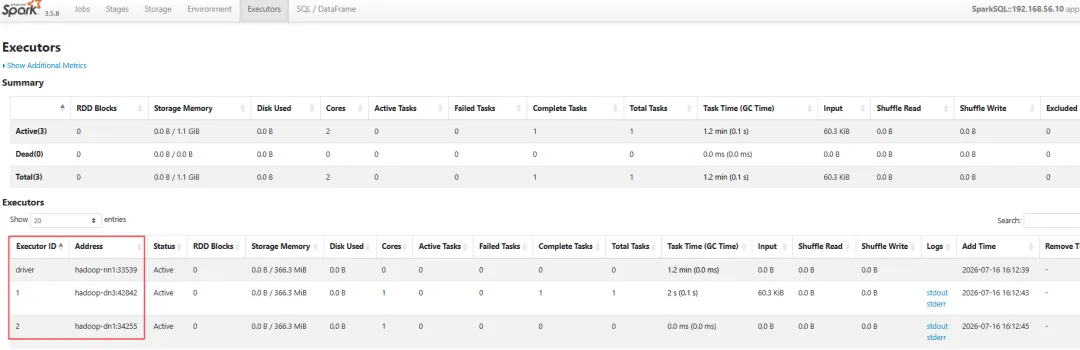
这种执行方式,不会产生一个单独的yarn application,而是在thrift的application里产生新的job,只要没有退出thrift服务,该application就会一直存在。

Driver和Executor资源完全使用yarn:
二、pyspark完全在宿主机本地执行
使用pyspark读取hive表,转换为DataFrame,然后执行sql。有一些前置工作需要完成。
宿主机本地下载pyspark 3.5.8版本
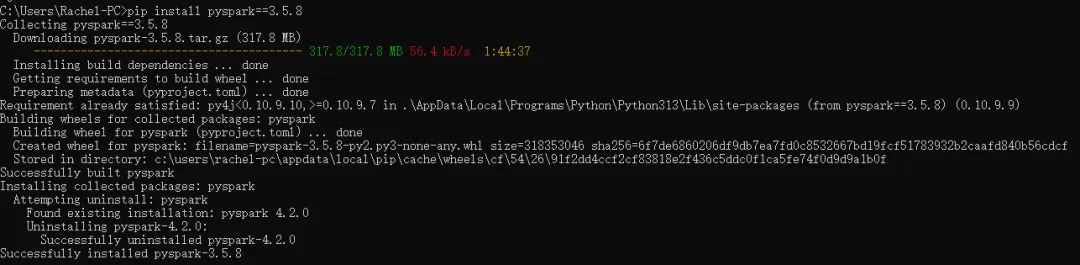
pip install pyspark==3.5.8
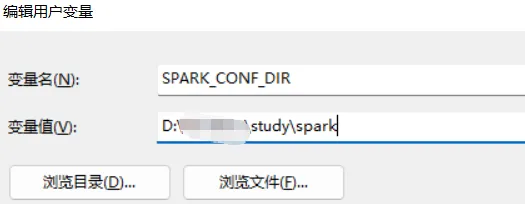
把集群$SPARK_HOME/conf目录下的hive-site.xml放在Windows本地,并把目录设置为环境变量SPARK_CONF_DIR
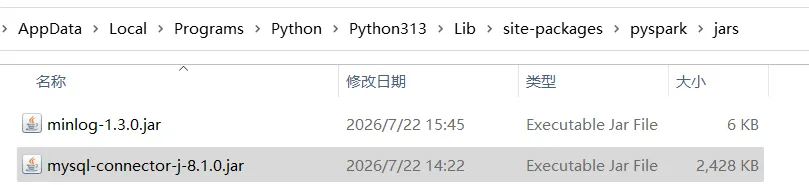
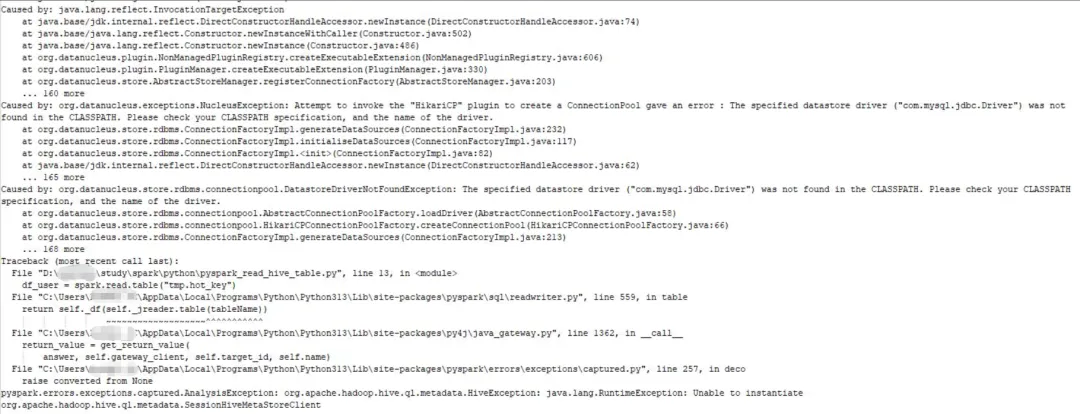
把集群$HIVE_HOEM/lib目录下的mysql-connector-j-8.1.0.jar复制到pyspark安装目录的jars目录,Windows上pyspark的安装目录一般是%PYTHON_HOME%\Lib\site-packages\pyspark
下载Windows版本的hadoop客户端工具,下载链接:https://github.com/cdarlint/winutils/tree/master/hadoop-3.3.6/bin,直接下载整个bin目录,下载到本地后,把所在目录设置为环境变量HADOOP_HOME,把%HADOOP_HOME%/bin加入到PATH环境变量
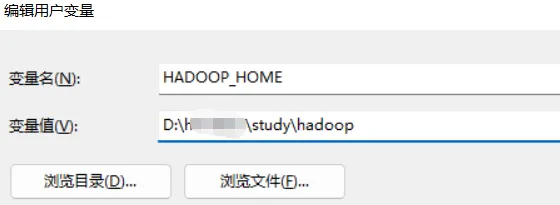
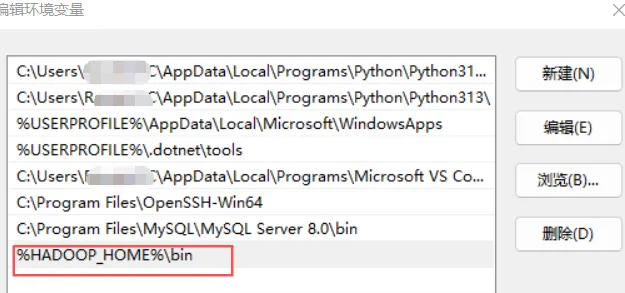
准备代码文件pyspark_read_hive_table.py,内容如下:
import osfrom pyspark.sql import SparkSessionspark = SparkSession.builder \ .appName("read_hive_tables") \ .master("local[2]") \ .enableHiveSupport() \ .getOrCreate()spark.read.table("ods.ods_trade_order_info").createOrReplaceTempView("order")spark.read.table("tmp.hot_key").createOrReplaceTempView("hot_key")spark.read.table("ods.ods_trade_user_info").createOrReplaceTempView("user")df_result = spark.sql(""" select /*+MAPJOIN(h)*/ o.order_id , o.order_amt , o.user_id , u.username from order o left join hot_key h on o.user_id = h.user_id left join user u on o.user_id = u.id where h.user_id is NULL limit 100""")df_result.show()spark.stop()
查看执行结果:
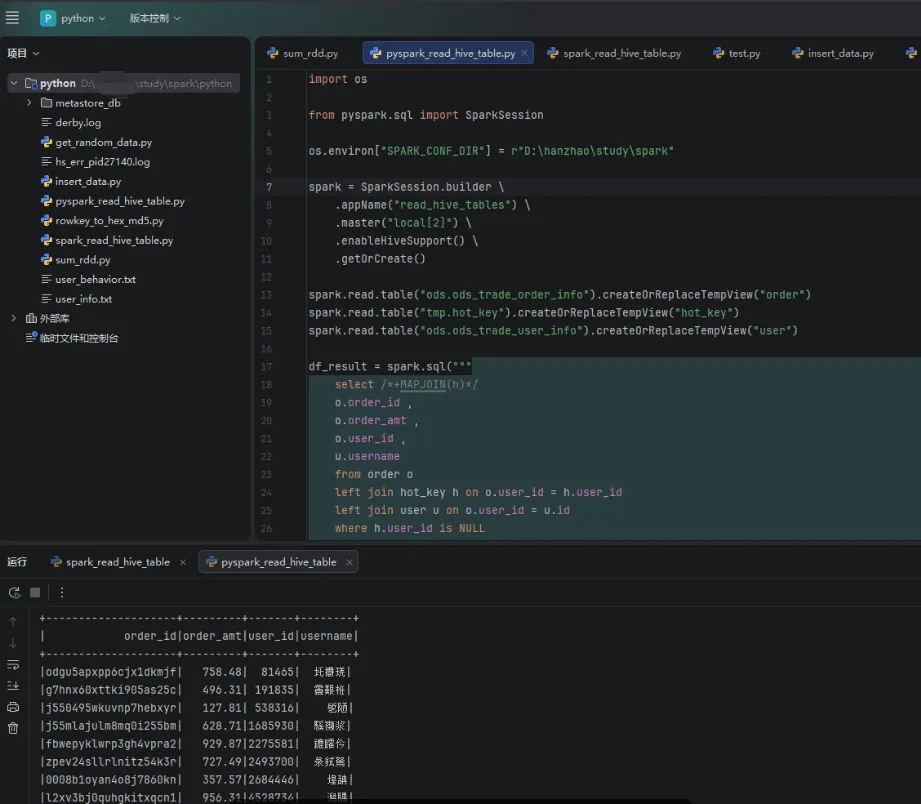
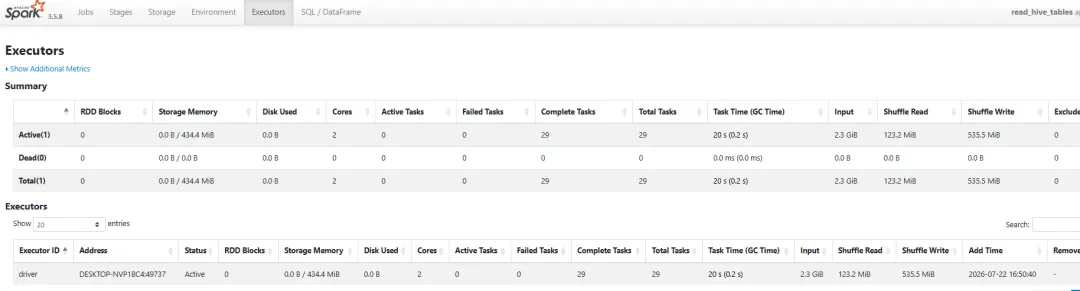
这种方式Driver和executor都在Windows机本地,计算资源也使用本机资源,所以不会在yarn上产生application,从sparkHistory服务可以看到APP ID是以local开头的编码,进入任务查看executors,可以发现只用到了一个节点,就是宿主机本身。

三、pyspark,Driver在本地,executor在yarn
这种方式和上一种类似,只是计算过程使用yarn来分配集群资源,准备代码文件pyspark_read_hive_table_yarn.py,内容如下:
import osfrom pyspark.sql import SparkSessionspark = SparkSession.builder \ .appName("pyspark_read_hive_tables_yarn") \ .config("spark.driver.host", "192.168.56.1") \ .enableHiveSupport() \ .getOrCreate()spark.read.table("ods.ods_trade_order_info").createOrReplaceTempView("order")spark.read.table("tmp.hot_key").createOrReplaceTempView("hot_key")spark.read.table("ods.ods_trade_user_info").createOrReplaceTempView("user")df_result = spark.sql(""" select /*+MAPJOIN(h)*/ o.order_id , o.order_amt , o.user_id , u.username from order o left join hot_key h on o.user_id = h.user_id left join user u on o.user_id = u.id where h.user_id is NULL limit 100""")df_result.show()spark.stop()
执行代码,查看结果:
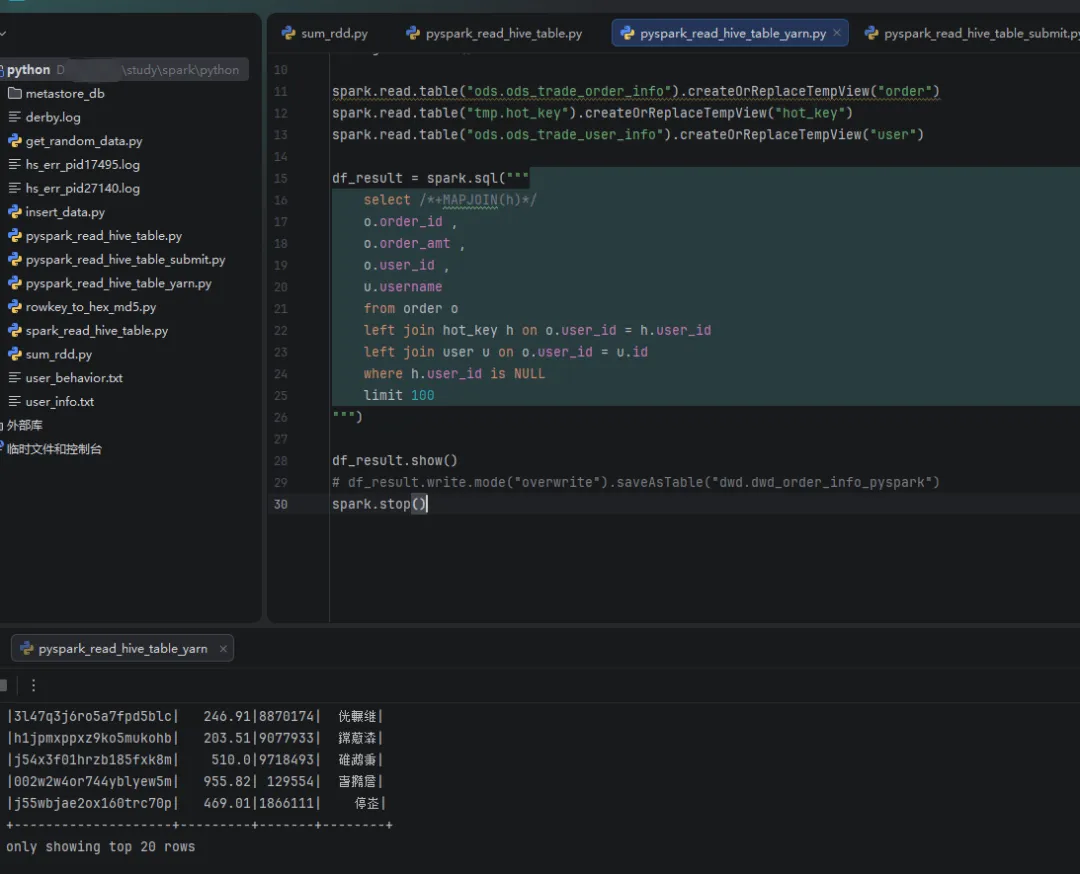
这种情况,会在yarn产生application,但Driver是宿主机,executor是yarn的NodeManager。

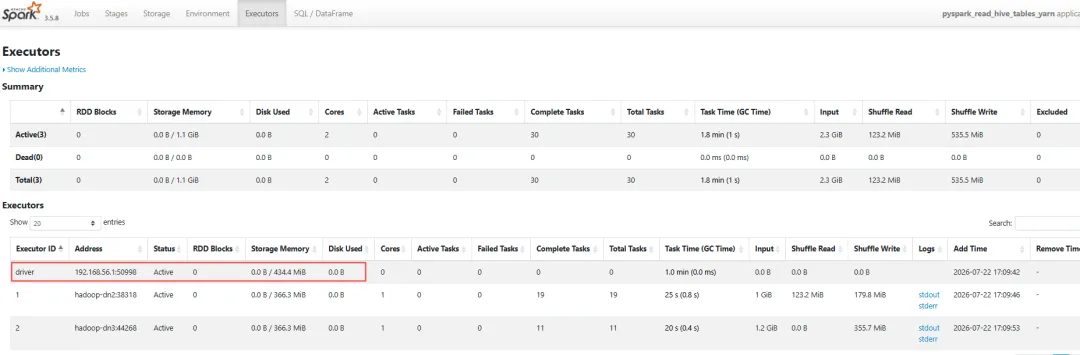
四、pyspark,完全在yarn执行
这种方式严格来说不是在Windows本地执行,因为要完全使用yarn,只能在集群提交代码。也需要做一些环境准备
在yarn集群的所有节点安装Python 3.13版本,同时不能影响Linux本身Python2的使用,具体步骤如下:
#安装编译环境sudo yum install -y gcc gcc-c++ make zlib-devel bzip2-devel openssl-devel ncurses-devel sqlite-devel readline-devel tk-devel gdbm-devel db4-devel libpcap-devel xz-devel libffi-devel#下载源码wget https://www.python.org/ftp/python/3.13.4/Python-3.13.4.tgztar -zxvf Python-3.13.4.tgzcd Python-3.13.4#编译配置+安装./configure --prefix=/home/hadoop/python313 --enable-sharedmake && make install#配置动态链接库echo"/home/hadoop/python313/lib" | sudo tee /etc/ld.so.conf.d/python313.confsudo ldconfig#配置用户环境变量export PYSPARK_PYTHON=/home/hadoop/python313/bin/python3 export PYSPARK_DRIVER_PYTHON=/home/hadoop/python313/bin/python3export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/home/hadoop/python313/libexport PATH=$PATH:$JAVA_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$ZK_HOME/bin:$HIVE_HOME/bin:$SPARK_HOME/bin:$SPARK_HOME/sbin:/home/hadoop/python313/bin
准备代码文件pyspark_read_hive_table_submit.py,内容如下:
from datetime import datetimefrom pyspark.sql import SparkSessionspark = SparkSession.builder \ .appName("pyspark_read_hive_table_submit") \ .enableHiveSupport() \ .getOrCreate()spark.read.table("ods.ods_trade_order_info").createOrReplaceTempView("order")df_result = spark.sql("select order_id,user_id,order_amt,create_time,pay_status from order limit 200")df_result.write.mode("overwrite").saveAsTable("ods.ods_trade_order_info_limit200")print(f"{datetime.now().strftime('%Y-%m-%d %H:%M:%S')} : 数据已插入ods.ods_trade_order_info_limit200表")spark.stop()
代码文件上传到spark的安装节点nn1
spark提交代码
spark-submit --master yarn --deploy-mode cluster /data/scripts/pyspark_read_hive_table_submit.py
执行完查看插入目标表的文件:
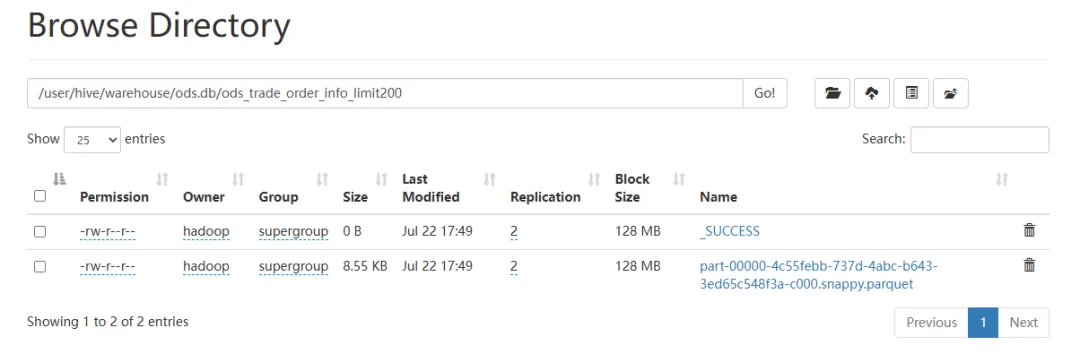
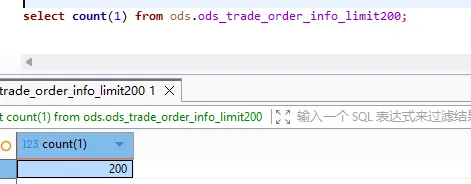
Driver和executor都是NodeManager:
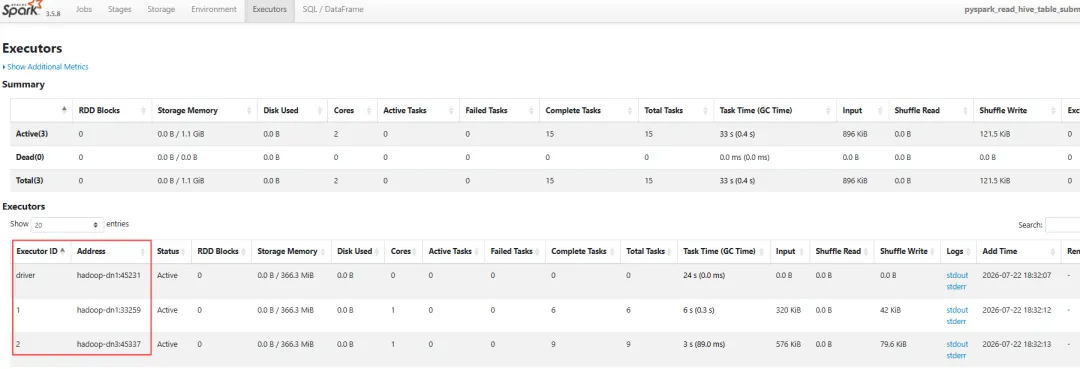
五、结论
上面介绍的4种用python+spark访问hive表的方法,其实可以分成两类:jdbc、pyspark,其中后者可以根据不同情况选择Driver和executor的执行位置。如果只是做一些简单的分析、查询,且数据量不大,可以选择pyspark的本地模式,如果数据量比较大,需要消耗比较多的计算资源,可以使用jdbc或pyspark+本地Driver+集群executor的方式,如果是每天要跑的脚本,就必须使用pyspark+完全集群的方式了。
六、问题说明
如果不配置Windows本地的SPARK_CONF_DIR,会报这个错误:

如果pyspark使用的4+版本,提交给yarn执行会报这个错误:
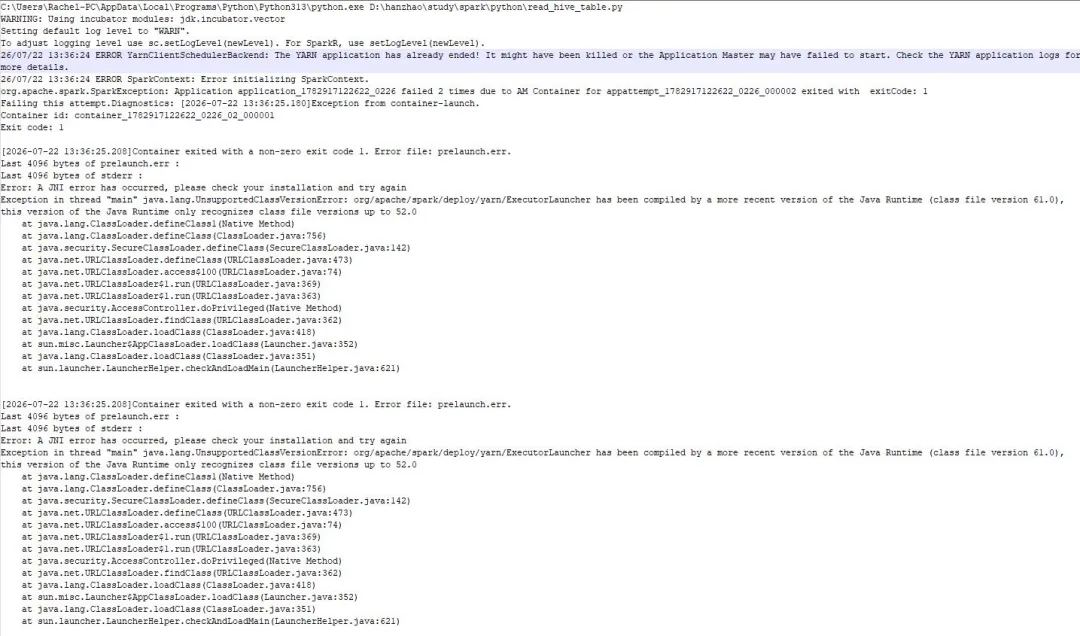
因为pyspark 4是基于jdk17编译的,但yarn集群的jdk版本是8,无法运行高版本的jdk代码,需要把pyspark降级,最好和机器上的spark同一版本。
mysql驱动如果没放在pyspark\jars目录,会报驱动错误:
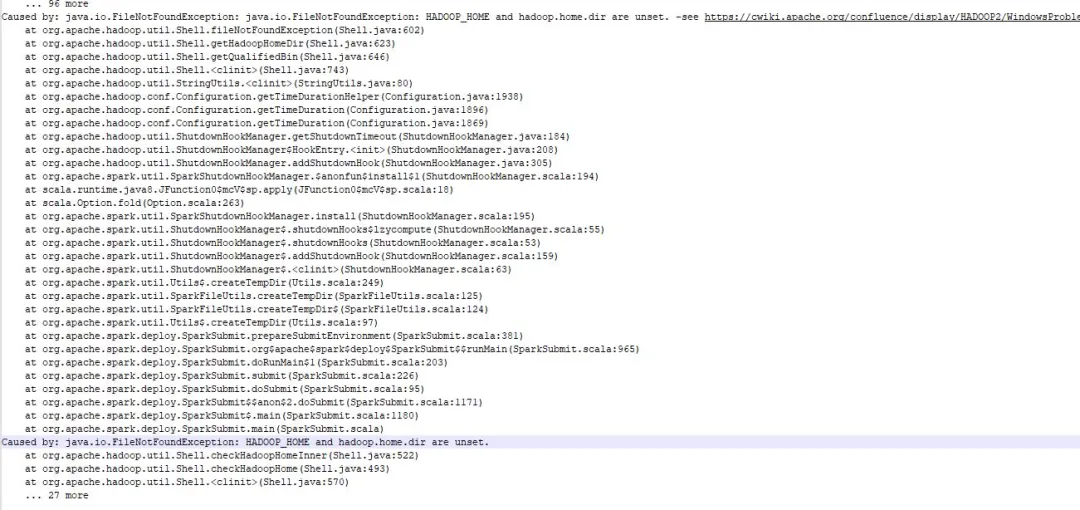
如果没有配置HADOOP_HOME环境变量,会报找不到文件错误:
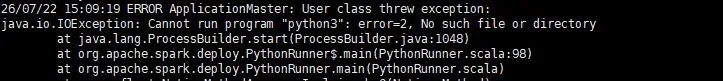
yarn集群没安装Python3的报错:
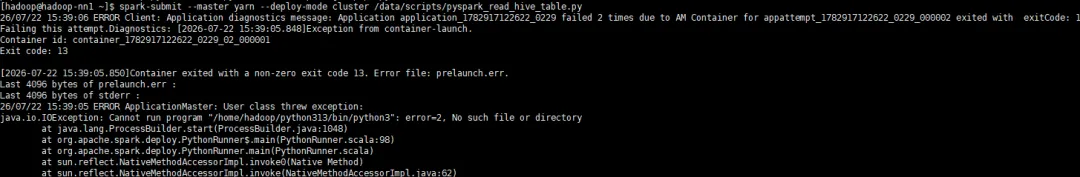
yarn没有在所有节点安装Python3,依然会报错:
本地Driver,远程executor的模式,如果没有显示配置"spark.driver.host"="192.168.56.1",会报executor联系不到Driver的错误:
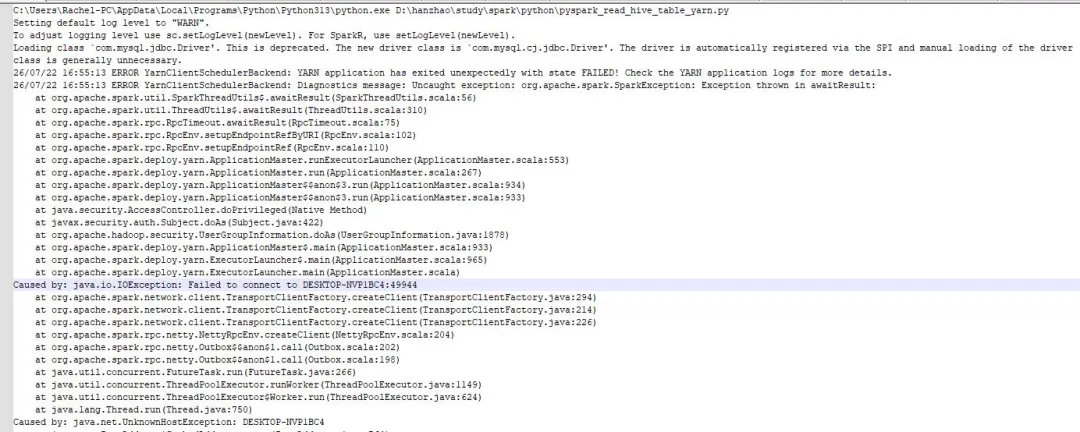
192.168.56.1是安装虚拟机时分配给宿主机的IP
完全在yarn执行代码,会需要更多的集群资源,sql复杂的话,可能会报这个错误:
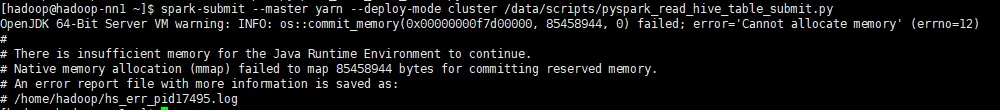
我这里只为了验证功能,所以减少了代码复杂度和数据量。
