数学建模三大高频模型Python实战:预测·优化·分类
数学建模竞赛中,有三类问题几乎每年必考:未来会怎样(预测)、怎样最好(优化)、属于哪一类(分类)。掌握这三类模型的Python实现,是备赛同学最直接的能力升级路径。
这篇文章不讲复杂理论,只讲「能跑通、能改参数、能直接用在比赛里」的代码实战。建议把代码复制到你的Jupyter Notebook里,边跑边理解。
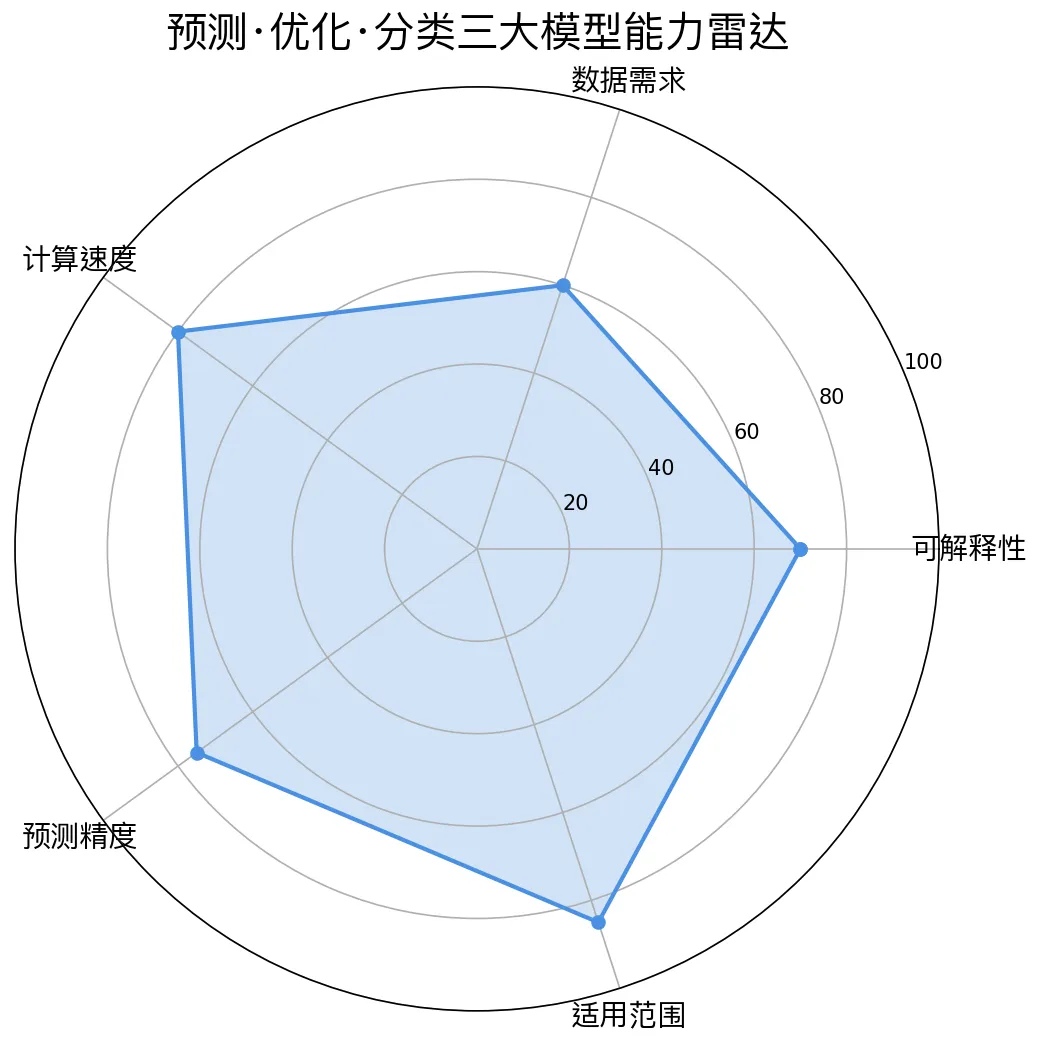
一、时间序列预测:ARIMA模型实战
预测类题目在国赛中非常常见,比如预测人口、销量、气温、股价、疫情发展趋势等。ARIMA模型是经典且稳健的选择,适合短期到中期预测。
什么时候用ARIMA?
模型思路简述
ARIMA(p,d,q) 包含三个部分:AR是自回归,用过去值预测当前值;I是差分,把非平稳序列变成平稳序列;MA是移动平均,用过去预测误差修正当前值。比赛中不必手动推参数,可以用AIC准则自动选择。
Python代码示例
import pandas as pd import numpy as np from statsmodels.tsa.arima.model import ARIMA import matplotlib.pyplot as plt # 构造示例数据:某城市过去60个月的客流量 dates = pd.date_range(start='2021-01', periods=60, freq='M') np.random.seed(42) values = np.cumsum(np.random.randn(60)) + 100 ts = pd.Series(values, index=dates) # 拟合ARIMA(1,1,1)模型 model = ARIMA(ts, order=(1, 1, 1)) result = model.fit() # 预测未来12个月 forecast = result.get_forecast(steps=12) forecast_mean = forecast.predicted_mean forecast_ci = forecast.conf_int() # 可视化 plt.figure(figsize=(10, 5)) plt.plot(ts, label='历史数据') plt.plot(forecast_mean.index, forecast_mean, label='预测值', color='red') plt.fill_between(forecast_ci.index, forecast_ci.iloc[:, 0], forecast_ci.iloc[:, 1], color='pink', alpha=0.3) plt.title('基于ARIMA的月度客流量预测') plt.legend() plt.show()
实战建议
- 用AIC或BIC自动选择(p,d,q)参数,不要拍脑袋定参数
替代方案
如果ARIMA效果一般,可以尝试指数平滑、Prophet、LSTM神经网络或XGBoost回归。建议在建模时至少对比两种方法,用均方误差或平均绝对误差作为评价标准。
二、线性规划与整数规划:资源分配的最优解
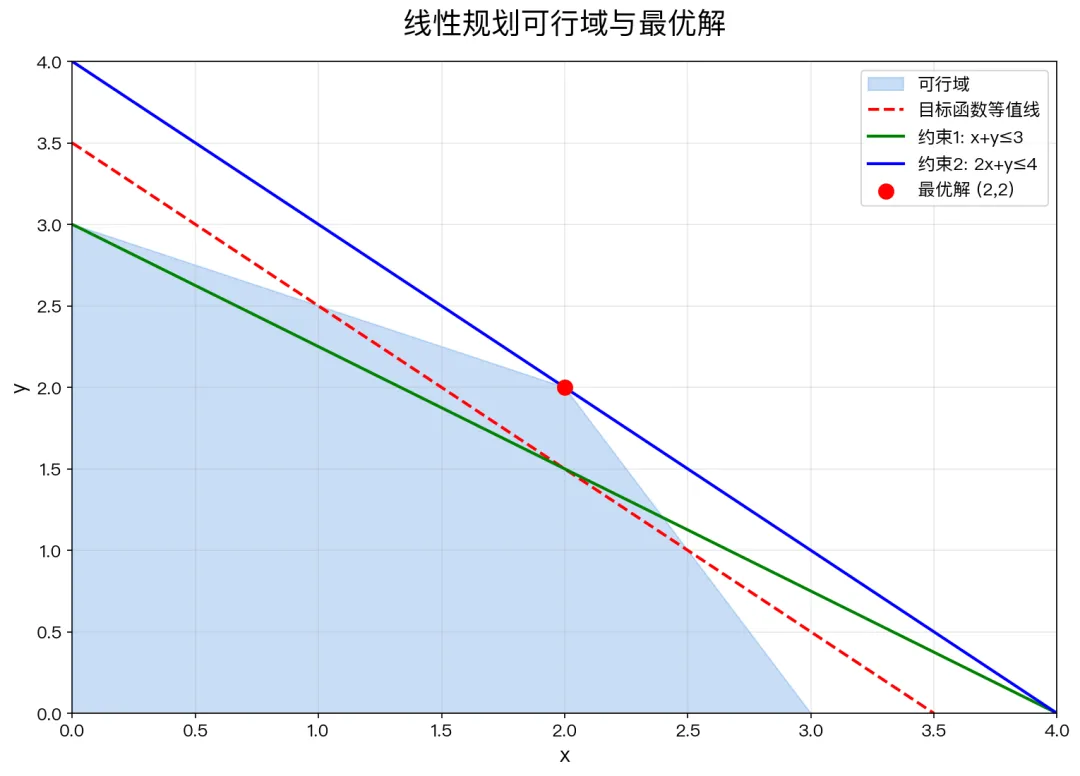
优化类题目几乎每年国赛都有,比如生产调度、物流配送、投资组合、人员排班、资源配置等。掌握线性规划和整数规划,可以解决大部分基础优化问题。
什么时候用线性规划?
模型思路简述
任何一个优化问题都可以抽象成三个要素:决策变量、目标函数、约束条件。线性规划要求这三个要素都是线性的。如果决策变量必须是整数(比如车辆数、人员数),那就是整数规划。PuLP是Python里非常友好的建模库,把数学语言直接翻译成代码即可。
Python代码示例:PuLP求解生产计划
import pulp # 定义问题:最大化利润 model = pulp.LpProblem('Production_Plan', pulp.LpMaximize) # 决策变量:产品A和B的产量 x = pulp.LpVariable('Product_A', lowBound=0, cat='Integer') y = pulp.LpVariable('Product_B', lowBound=0, cat='Integer') # 目标函数:利润 = 3*x + 5*y model += 3 * x + 5 * y # 约束条件 model += 2 * x + y <= 100 # 原材料1限制 model += x + 3 * y <= 150 # 原材料2限制 # 求解 model.solve() print('产品A产量:', pulp.value(x)) print('产品B产量:', pulp.value(y)) print('最大利润:', pulp.value(model.objective))
实战建议
- 把实际问题抽象成「目标函数 + 约束条件」是建模关键,动笔前先列清楚
- 如果问题规模小,整数规划可以直接求解;规模大时考虑启发式算法
- 结果要做敏感性分析,比如原材料上限变化对利润的影响
替代方案
对于非线性目标或复杂约束,可以尝试scipy.optimize.minimize、遗传算法、模拟退火或粒子群算法。选择标准不是模型多高级,而是能否稳定跑出合理结果。
三、机器学习分类:随机森林预测客户流失
分类问题在国赛中也很常见,比如信用评估、疾病诊断、客户流失预测、垃圾邮件识别、故障检测等。随机森林是一个鲁棒性强、调参友好的模型,非常适合作为基线模型。
什么时候用随机森林?
模型思路简述
随机森林是集成学习的代表。它先构造多棵决策树,每棵树用随机抽取的样本和特征训练,最后把多棵树的结果投票或平均。因为引入了随机性,模型不容易过拟合,对异常值也比较鲁棒。
Python代码示例
from sklearn.datasets import make_classification from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestClassifier from sklearn.metrics import accuracy_score, classification_report # 构造示例数据集 X, y = make_classification(n_samples=1000, n_features=10, random_state=42) X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42) # 训练随机森林模型 clf = RandomForestClassifier(n_estimators=100, random_state=42) clf.fit(X_train, y_train) # 预测与评估 y_pred = clf.predict(X_test) print('准确率:', accuracy_score(y_test, y_pred)) print(classification_report(y_test, y_pred)) # 特征重要性 importances = pd.Series(clf.feature_importances_) print('特征重要性:') print(importances.sort_values(ascending=False))
实战建议
- 比赛前准备好一套完整的数据预处理模板:缺失值填充、异常值处理、特征编码
- 不要只给一个准确率,要给出混淆矩阵、召回率、精确率等指标
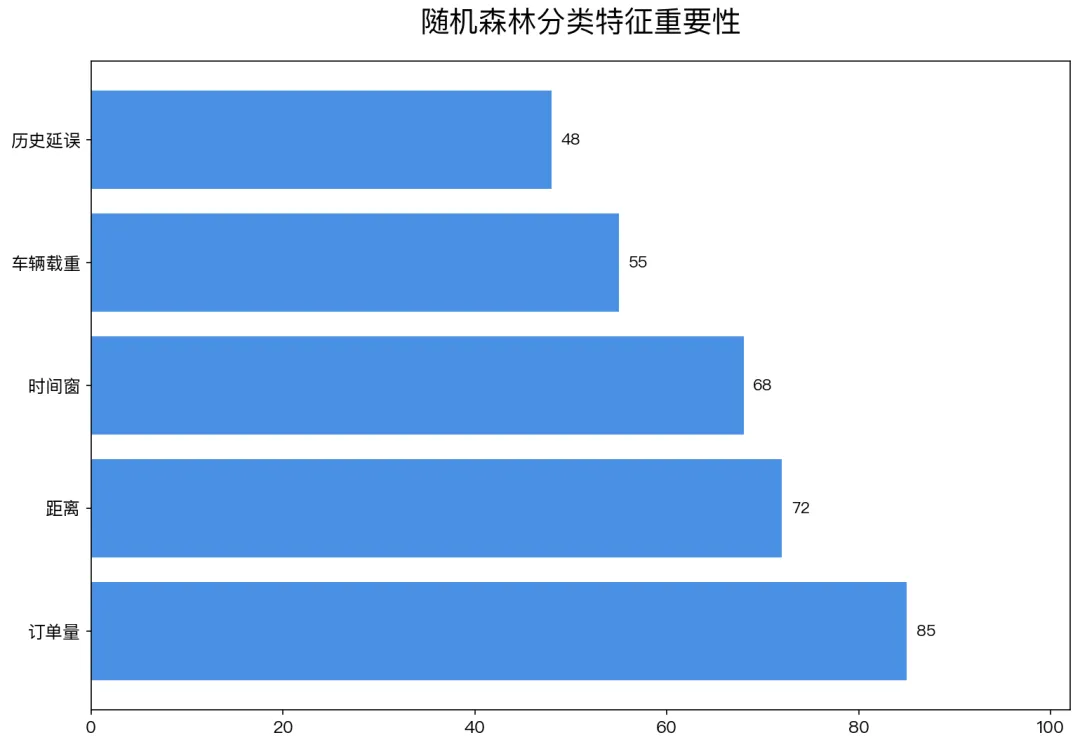
- 利用特征重要性做解释,让评委理解你的模型为什么有效
- 样本不平衡时,可以使用过采样、欠采样或调整类别权重
替代方案
如果随机森林表现不够理想,可以尝试XGBoost、LightGBM、支持向量机或神经网络。对于二分类问题,逻辑回归也是一个优秀的可解释基线模型。
四、三个模型的组合使用思路
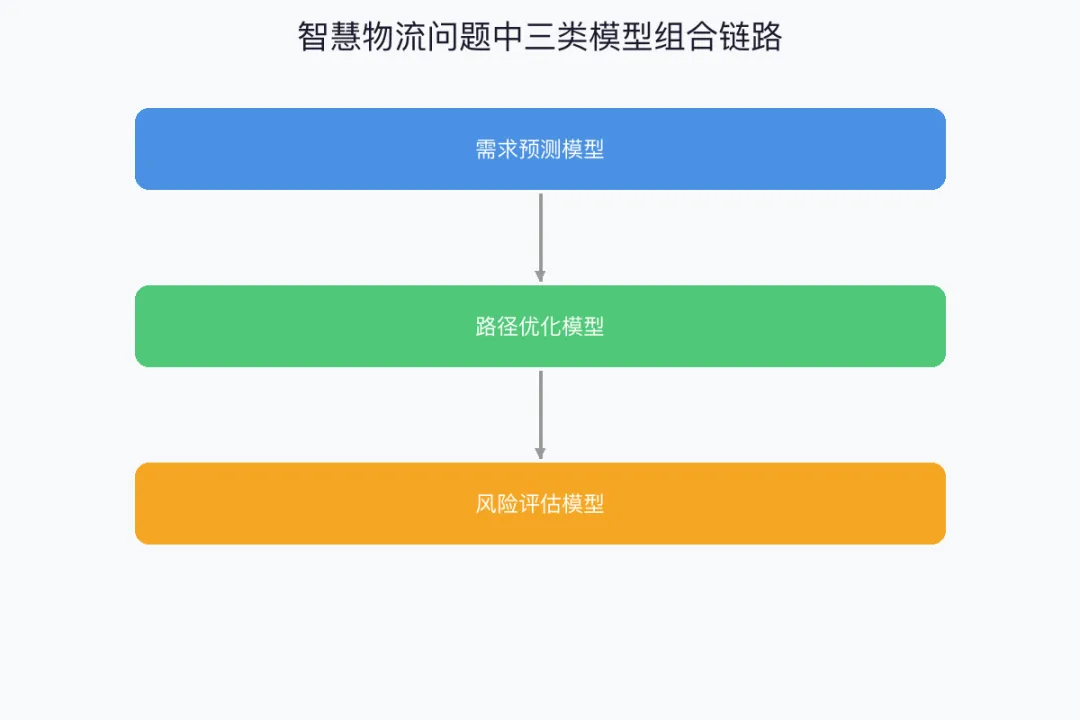
真实的国赛题目往往不是单一模型能解决的。比如一道智慧物流题,可能需要:
把这三类模型组合起来,就能形成一条完整的解题链路。这也是评委最喜欢看到的「系统工程思维」。
五、模型选择速查表
遇到新题目不知道用哪个模型?参考下面这张速查表:
记住,速查表只是起点。真正决定用哪个模型的,是数据特点、问题约束和你的团队熟悉度。
六、给你的即战力工具包
- 数据处理
- 可视化
- 预测:statsmodels、scikit-learn
- 优化
- 分类
建议你现在就把上面的三段代码分别跑一遍,然后尝试修改参数、替换数据。只有自己跑通过,比赛时才不会手忙脚乱。
数学建模不是背公式,而是把问题翻译成代码、让代码给出答案。这个夏天,让Python成为你的第二大脑。
