很多人刚学 Python 的时候,都有一种很自然的感觉:
代码能跑起来,就已经很不错了。
但学着学着,你会慢慢发现,能跑和跑得快,其实完全是两回事。
有的程序处理几十条数据时很顺畅,一旦数据量变成几万条,立刻就像卡住了一样。有的脚本平时执行没问题,可一旦要批量处理文件、请求接口、读写数据库,速度就明显慢下来。还有一些程序,明明逻辑不复杂,结果运行时间却长得离谱。
这时候你就会意识到,性能问题,不是高级程序员才会遇到的事,而是每个写程序的人迟早都要面对的问题。
这一章,我们不急着讲优化技巧,先把一个更关键的问题说清楚:
程序到底为什么会慢。
只有先知道慢在哪里,后面的优化才不会变成瞎折腾。
一、程序慢,不一定是 Python 慢
很多初学者一遇到程序运行慢,第一反应就是:
是不是 Python 本身就慢。
这句话不能说完全错,但也不完全对。
Python 确实不是以极致执行速度著称的语言。和 C、C++、Rust 这类更接近底层的语言相比,Python 在纯计算场景里通常会慢一些。但在实际开发中,很多程序慢,根本不是因为语言本身,而是因为代码写法、任务类型、资源使用方式出了问题。
换句话说,程序慢,往往不是你选错了语言,而是你还没有搞清楚瓶颈到底在哪。
比如下面这段代码:
total = 0for i in range(10000000): total += iprint(total)
这段代码运行起来可能会花一点时间,因为它做了大量重复计算。
但如果是下面这种情况:
import timefor i in range(5): print(f"正在处理第{i+1}个任务") time.sleep(2)
程序也会慢,但这次不是因为计算量大,而是因为它每次都在等。
所以你会发现,慢这件事,根源并不只有一种。
二、程序变慢,常见原因其实就那么几类
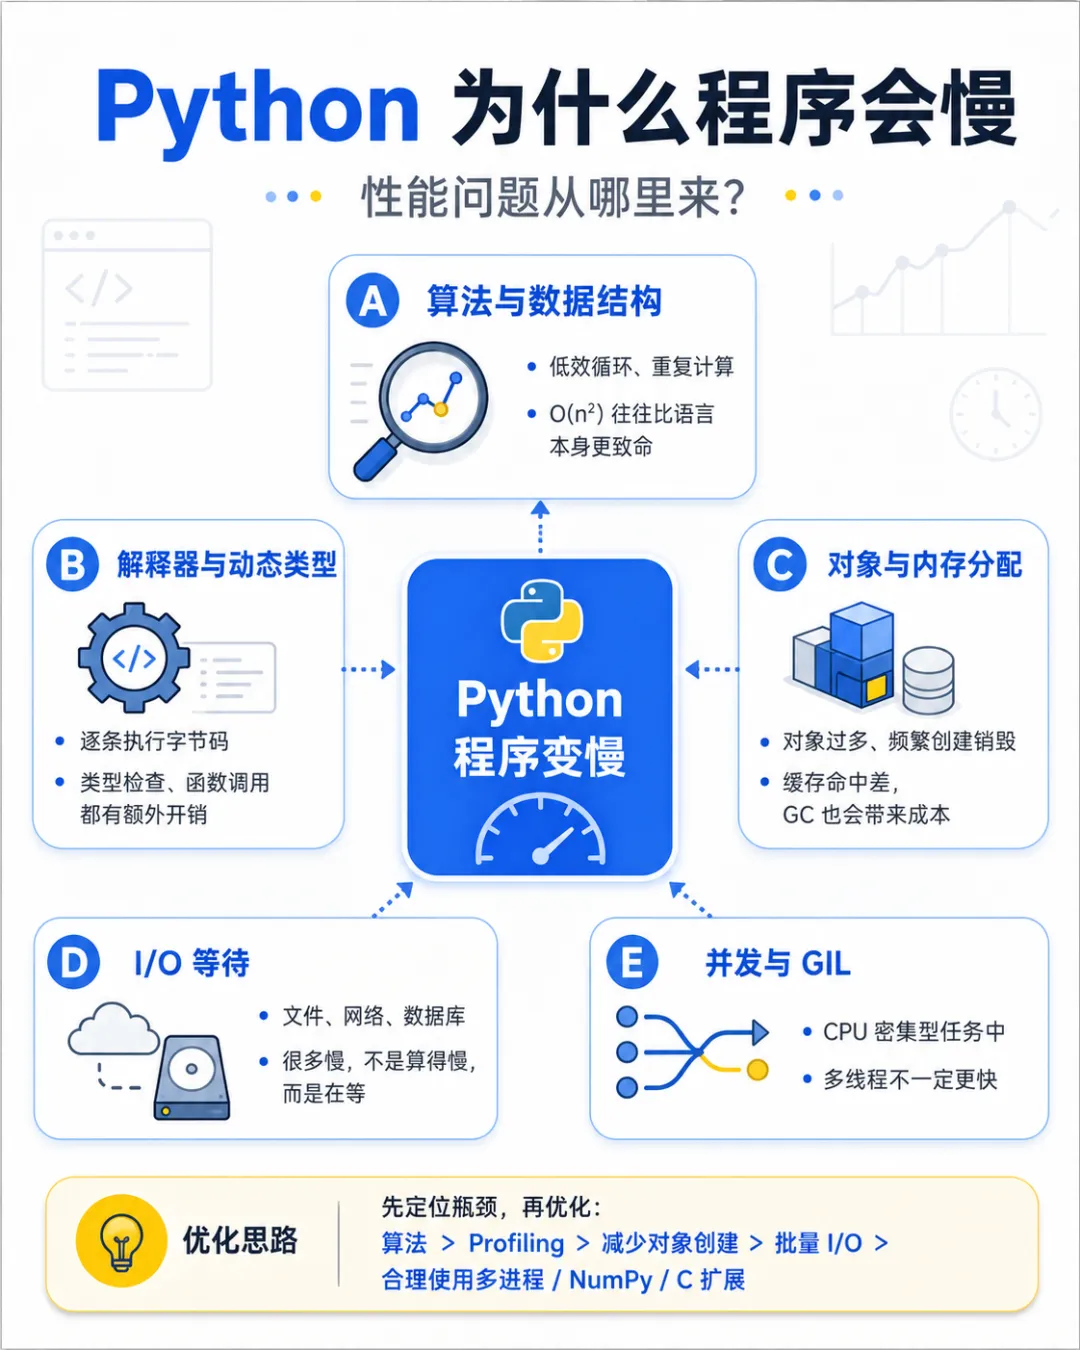
虽然性能问题看起来很复杂,但本质上,大多数程序变慢,都可以归到几个非常典型的来源。
第一类,计算太多。
这类问题很好理解。程序需要做大量数学运算、循环判断、数据处理,自然会花时间。尤其当你写了很多层嵌套循环,或者对大数据反复遍历时,速度就会明显下降。
第二类,等待太多。
程序有时候不是在忙,而是在等。比如等网络响应,等磁盘读取,等数据库返回结果,等外部接口处理完成。这种慢,不是 CPU 忙不过来,而是程序被卡在原地了。
第三类,数据结构没选对。
同样是查找一个元素,用列表和用集合,效率可能差很多。你以为只是换了个写法,实际上底层开销已经完全不一样了。
第四类,无效操作太多。
程序里有些代码,看起来写了很多,实际上做了大量重复劳动。比如在循环里频繁读文件、频繁拼接字符串、频繁发请求,这些都会让程序越来越慢。
第五类,资源竞争或使用不合理。
比如多个任务同时抢一个资源,或者程序明明可以并发处理,却非要一个一个排队执行,这都会造成性能浪费。
你看,性能问题并不神秘。说到底,就是程序把时间花错地方了。
三、先搞懂一个词:瓶颈
如果你只记住这一章一个词,我希望是瓶颈。
所谓瓶颈,就是整条执行流程里最慢的那一段。
可以把程序想象成一条流水线。前面每一步都很快,但只要中间某一步特别慢,整体速度就会被它拖住。哪怕其他地方再快,也没用。
举个生活里的例子。
你去食堂打饭,排队的人很多。盛饭阿姨一秒钟可以盛一份,打菜阿姨也很快,刷卡也只要一瞬间。但如果只有一个窗口负责打汤,而每个人打汤都要十秒钟,那整条队伍就会卡在打汤这里。
这个打汤窗口,就是瓶颈。
程序也是一样。
不是所有代码都值得优化,真正值得你下手的,是那个最拖后腿的地方。
很多人一上来就开始改变量名、换写法、删几行代码,以为自己在优化。其实如果没找到瓶颈,大概率只是心理安慰。
四、CPU 密集型和 I/O 密集型,是两种完全不同的慢
程序为什么慢,经常和任务类型直接相关。
最常见的两大类,就是 CPU 密集型和 I/O 密集型。
1. CPU 密集型
这类任务的特点是,程序一直在算。
比如大规模数学运算、图像处理、视频编码、复杂排序、加密解密、模型训练等,核心瓶颈通常在 CPU。
也就是说,程序慢,是因为计算本身很重,处理器一直在忙。
看一个简单例子:
count = 0for i in range(100000000): count += iprint(count)
这就是典型的 CPU 密集型任务。程序几乎没怎么等外部资源,就是在不停算。
2. I/O 密集型
I/O 指的是输入输出,常见包括读文件、写文件、访问网络、操作数据库等。
这类任务的特点是,程序的大量时间都花在等待外部设备或服务响应上。
比如:
import requestsfor i in range(5): response = requests.get("https://example.com") print(response.status_code)
这段代码真正耗时的,往往不是 Python 执行这几行语句,而是在等服务器返回数据。
所以,CPU 密集型和 I/O 密集型,虽然都表现为慢,但慢的原因完全不同。后面你学多线程、多进程、协程时,会发现它们的适用场景也正是围绕这个区别展开的。
五、很多程序慢,不是因为任务难,而是因为写法笨
这句话特别重要。
有些程序慢,并不是因为事情本来就复杂,而是因为代码写得不够合理。
比如,下面这个例子:
nums = list(range(100000))target = 99999for num in nums:if num == target: print("找到了")break
这段代码当然能跑,也能找到结果。但如果你只是要判断某个值是否存在,列表并不一定是最高效的结构。
换成集合时:
nums = set(range(100000))target = 99999if target in nums: print("找到了")
在很多场景下,集合查找会更快。
这就说明一个问题:
程序慢,有时候不是工作量太大,而是工具没选对。
再比如字符串拼接。
result = ""for i in range(10000): result += str(i)
这段代码在循环里反复拼接字符串,效率通常不高。更合理的写法,是先收集起来,再一次性拼接:
parts = []for i in range(10000): parts.append(str(i))result = "".join(parts)
你会发现,程序优化很多时候不是魔法,只是少走弯路。
六、重复做同一件事,是最常见的性能浪费
初学者写代码时,特别容易出现一种情况:
逻辑是对的,但做了太多没必要的重复操作。
比如,每次循环都打开一次文件:
for i in range(1000):with open("data.txt", "r", encoding="utf-8") as f: content = f.read()
如果文件内容没变,这种写法就很浪费。因为打开文件本身也是有成本的。
更合理的方式通常是:
with open("data.txt", "r", encoding="utf-8") as f: content = f.read()for i in range(1000):# 重复使用 contentpass
再比如,循环里频繁请求数据库,频繁访问网络接口,频繁创建对象,这些都会让程序慢下来。
很多性能问题,追到最后,不是因为你不会高级技术,而是因为你把本来一次就能做完的事,写成了一百次、一千次。
七、数据量一大,问题才会真正暴露出来
为什么很多人平时感觉不到性能问题?
因为数据太少了。
你拿 10 条数据测试,程序几乎怎么写都能跑。拿 100 条数据,差别也不明显。可一旦到了 1 万条、10 万条、100 万条,代码的好坏就会迅速拉开。
这就像走平路和爬山。
平地上背个小包,谁都觉得轻松。真到了长距离爬坡,你背的是棉花还是砖头,立刻就知道了。
程序也是一样。
小数据时,很多低效写法还能忍。一旦数据量上来,问题就会成倍放大。
所以,学习性能优化,本质上是在为以后处理更复杂、更真实的任务做准备。
八、不是所有慢都需要立刻优化
这里要提醒你一个很容易被忽略的点:
优化不是目的,解决问题才是目的。
很多人学到性能优化之后,会产生一种错觉,好像所有代码都必须尽可能快。其实不是。
如果一个脚本每天只跑一次,多花两秒并不会造成任何影响,那你花两个小时去优化它,可能反而不划算。
真正值得优化的情况通常有这些:
程序运行频率很高 数据量明显很大 用户正在等待结果 某段代码已经成为业务瓶颈 资源消耗明显过高
换句话说,不是看到慢就要激动,而是先判断这个慢是否真的影响了使用。
会优化很重要,但知道什么时候不用优化,同样重要。
九、判断程序慢,靠感觉不够,最好靠数据说话
很多人说,我觉得这段代码很慢。
问题是,觉得不等于事实。
有时候你以为是数据库慢,结果真正拖时间的是循环处理。有时候你以为是 Python 解释器慢,最后发现是网络请求超时。有时候你觉得优化成功了,实际上前后只差了零点几秒。
所以判断性能问题,不能只靠感觉,最好要有测量意识。
最简单的方式,就是记录时间。
import timestart = time.time()total = 0for i in range(10000000): total += iend = time.time()print("耗时:", end - start)
这样你就能知道,这段代码到底花了多少时间。
以后你还会学到更专业的性能分析工具,但在刚入门这个阶段,先养成一个习惯就够了:
别凭猜测优化,先找到真正耗时的地方。
十、一个直观案例:明明逻辑简单,为什么还是慢
假设你要处理一个文件夹里的 5000 个文本文件,统计每个文件里某个关键词出现的次数。
很多人可能会这样写:
import ostotal = 0for filename in os.listdir("texts"): path = os.path.join("texts", filename)with open(path, "r", encoding="utf-8") as f: content = f.read() total += content.count("Python")print(total)
这段代码逻辑没有问题,也挺清晰。
但如果文件很多,或者硬盘速度一般,程序可能就会慢下来。为什么?
因为这里的主要耗时,可能不是 count 统计,而是大量文件读取。也就是说,慢点不在计算,而在 I/O。
这就是为什么同样是慢,背后的原因完全可能不同。
有时候你面对的不是复杂算法问题,而是磁盘读写问题。再换个场景,可能是网络延迟问题。再换个场景,可能是数据库查询没建索引。
所以学性能,第一步不是背技巧,而是学会分类。
你得先知道,自己面对的到底是哪一种慢。
十一、性能优化的第一原则,不是提速,而是定位
很多人一提优化,马上想到多线程、多进程、异步、缓存、索引、分布式,看起来很厉害。
但你要记住,真正靠谱的优化顺序永远是:
先定位 再分析 最后才是优化
没有定位,优化就是乱打补丁。 没有分析,优化就是靠运气。 只有先找到瓶颈,后面的手段才有意义。
这也是为什么我们这一章只讲为什么会慢,而不急着讲怎么加速。
因为你连病因都没看明白,就急着开药,最后很可能药不对症。
十二、本章你一定要带走的几个结论
学到这里,你可以先把下面几个结论记住。
程序慢,不一定是 Python 语言的问题,很多时候是代码结构和任务类型的问题。
性能问题的来源,常见就是计算太多、等待太多、数据结构不合理、重复操作太多、资源使用方式不合理。
CPU 密集型和 I/O 密集型,是理解性能问题最重要的两个分类。
真正拖慢程序的地方,叫瓶颈。优化要盯住瓶颈,而不是哪里都改。
优化之前,先测量,别靠感觉判断。
不是所有慢都值得优化,要看它是否真的影响使用。
十三、动手练习:让你真正理解程序为什么慢
看完这一章,别急着往下翻。建议你自己动手做下面两个小实验。
第一个实验,写一个大循环做累加,感受 CPU 密集型任务的执行时间。
import timestart = time.time()total = 0for i in range(50000000): total += iprint(total)print("耗时:", time.time() - start)
第二个实验,写一个循环,每次 sleep 1 秒,感受等待型任务的慢。
import timestart = time.time()for i in range(5): print(f"执行第{i+1}次") time.sleep(1)print("耗时:", time.time() - start)
你会发现,这两个程序都慢,但慢的感觉并不一样。
前者是一直在忙。 后者是一直在等。
而这,正是后面学习并发编程的起点。
十四、写在最后
很多人一听性能优化,就觉得这是高手才研究的内容,离自己很远。
其实不是。
你写爬虫会遇到速度慢,做数据处理会遇到速度慢,批量操作文件会遇到速度慢,访问数据库也会遇到速度慢。只要程序开始处理真实任务,性能问题几乎一定会出现。
所以,性能优化并不是一门炫技课程,而是一种越来越实用的基本能力。
先别急着追求写出多快的程序。
更重要的是,你要先具备一种判断力:
程序为什么慢 慢在什么地方 到底值不值得优化
当你开始这样思考时,你就已经从单纯会写代码,慢慢走向真正会分析程序了。
 10个月宝宝每天需要喝多少奶粉?