《Python深度学习基于PyTorch(第2版)》—习题集第4集
【提要】:本习题集主要介绍PyTorch由跟跑到领跑背后的原因及PyTorch一些核心组件的应用等问题。
 一、简答题
习题1:请选取 PyTorch 发展历程中的 5 个关键里程碑事件,从技术演进、生态策略、治理模式三个维度,论述 PyTorch 是如何在深度学习框架竞争中后来居上,成为工业界与学术界主流框架的。
【参考答案】
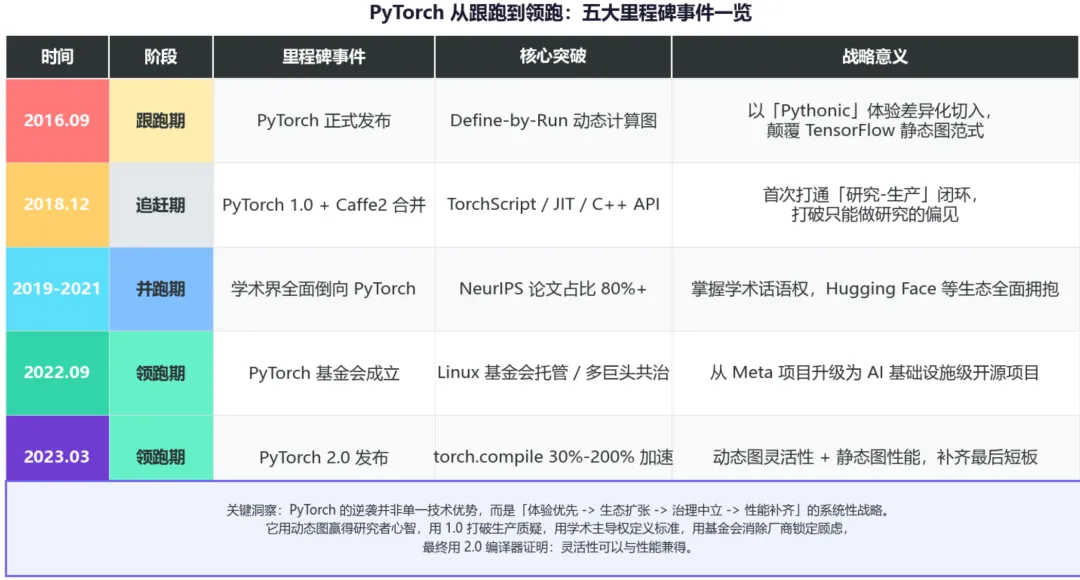
核心技术迭代示意图:
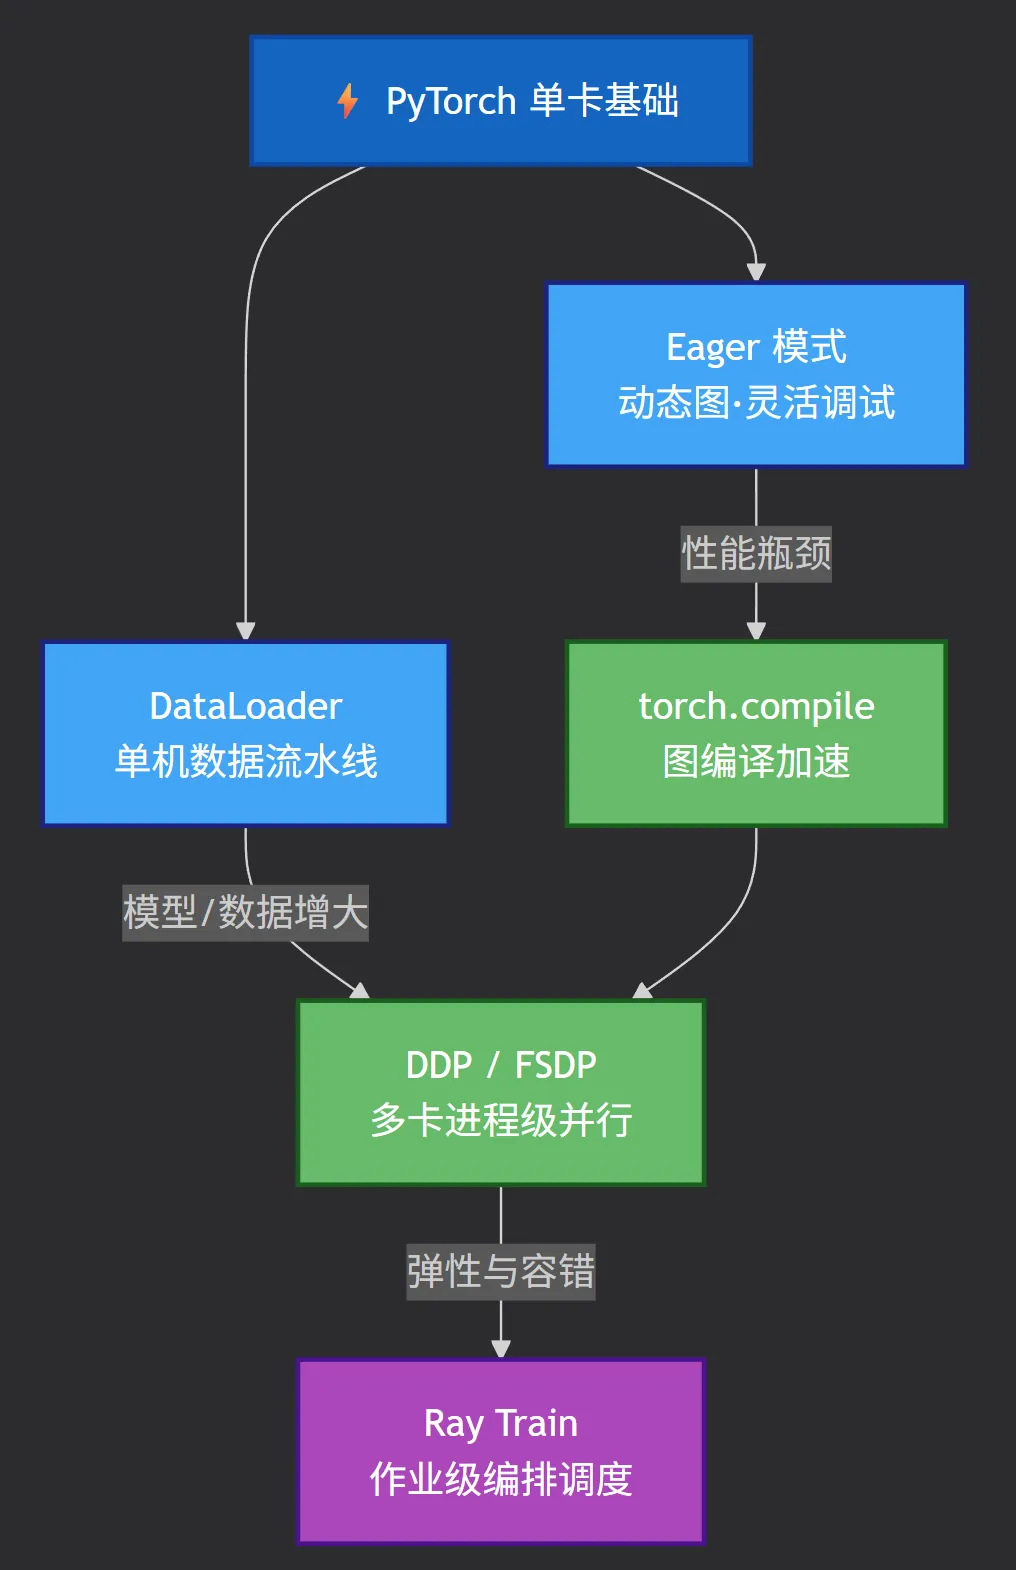
行业数据佐证(2024–2026)
1.NeurIPS/ICML/ICCV 顶会论文 75%+ 使用 PyTorch,TensorFlow 占比不足 5%;
2.Linux 基金会调研:全球 AI 训练框架市场 PyTorch 占有率 63%,断层第一;
3.全球开源大模型 Llama、Qwen、GLM、Mistral 均以 PyTorch 为主力框架,TensorFlow 仅少量传统 CV 遗留项目使用。
习题2:自定义数据集继承 torch.utils.data.Dataset,必须重写哪两个魔法方法?各自作用?
【答题思路】
一、必须重写的两个魔法方法:
1.__len__(self)
2.__getitem__(self, idx)
其中参数idx为int,样本索引(0 ~ len (dataset)-1)
二、各自作用 + 调用时机
1. __len__(self)
1.作用:返回数据集包含的总样本数量;
2.调用时机
o手动执行 len(自定义数据集实例) 时;
oDataLoader 内部自动调用,用于计算每个 epoch 的迭代总步数、划分批次、随机采样。
3.示例触发:train_dataset = MyDataset(); print(len(train_dataset))
2. __getitem__(self, idx)
1.作用:接收索引idx,读取对应单条样本,返回(数据,标签)或单条数据;是 DataLoader 加载单条数据的核心接口。
2.调用时机
o手动下标取值:train_dataset[0]、train_dataset[5];
oDataLoader 迭代训练时,后台多线程自动循环调用该方法读取每条样本,自动拼接成 batch 张量。
三、简单示例:
from torch.utils.data import Dataset, DataLoader
import numpy as np
#自定义数据集,继承基类Dataset
class MyDataset(Dataset):
def__init__(self):
#模拟数据:10个样本,每个是3维向量,标签是0/1
self.data= np.array([[i, i+1, i+2] for i in range(10)])
self.labels= np.array([i % 2 for i in range(10)])
def__len__(self):
returnlen(self.data)# 返回10
def__getitem__(self, idx):
returnself.data[idx], self.labels[idx]# 返回 (数据, 标签)
# 使用,自动触发这两个函数
dataset = MyDataset()
print(len(dataset))# 自动触发_len__,输出: 10
print(dataset[3])# 自动触发__getitem__,索引是3,输出: 请看运行结果
# DataLoader迭代时自动调用两个方法
train_loader = DataLoader(dataset, batch_size=2, shuffle=False)
for batch_x,batch_y in train_loader:
print("批次数据:",batch_x)
运行结果:
10
(array([3, 4, 5]), np.int64(1))
批次数据: tensor([[0, 1, 2],[1, 2, 3]])
批次数据: tensor([[2, 3, 4],[3, 4, 5]])
批次数据: tensor([[4, 5, 6],[5, 6, 7]])
批次数据: tensor([[6, 7, 8],[7, 8, 9]])
批次数据: tensor([[ 8,9, 10], [ 9, 10, 11]])
习题3:PyTorch中nn.Module是所有神经网络模块的基类。自定义一个简单的线性层模型时,必须在__init__和forward中分别完成什么工作?
【考察目的】 考察nn.Module子类化的基本规范。
【解题思路】
1.__init__中:调用super().__init__()初始化父类;定义子模块(层)和可训练参数(nn.Parameter)。
2.forward中:定义数据的前向传播计算逻辑,输入x经过各子模块得到输出。
3.两个方法的职责分离:__init__组装网络结构(一次性),forward定义数据流动(每次调用执行)。
4.注意:forward不应包含参数定义,所有可训练参数必须在__init__中注册。
简单示例:
class MyModel(nn.Module):
def__init__(self):
super().__init__()
self.fc1= nn.Linear(10, 5)
self.fc2= nn.Linear(5, 2)
defforward(self, x):
returnself.fc2(self.fc1(x))
习题4:当训练过程中loss出现NaN时,请列出至少4种可能的原因及对应的排查方法。
【考察目的】 考察训练异常排查能力,这是实际工作中高频问题。
【解题思路】
1.学习率过大导致梯度爆炸 → 排查:减小学习率,添加梯度裁剪(clip_grad_norm_)。
2.输入数据包含NaN或异常值 → 排查:在数据加载后添加assert not torch.isnan(x).any()检测。
3.softmax输入数值溢出(指数爆炸)→ 排查:检查logits是否有极大值,数据是否已标准化。
4.交叉熵中log(0)导致无穷 → 排查:添加数值稳定小常数ε或使用PyTorch内置稳定版本。
5.权重初始化不当导致激活饱和 → 排查:改用Xavier或He初始化。
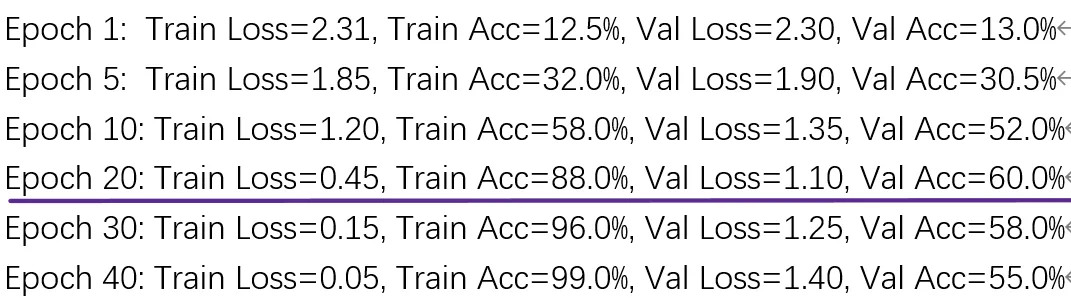
 :请分析以下训练日志,判断模型可能存在的问题,并给出改进建议。
考察目的: 通过训练日志诊断模型问题,培养对过拟合、欠拟合等问题的直觉判断能力。
解题思路:
问题诊断:
1.过拟合(Overfitting):
·Epoch 20后,Train Acc持续上升(88%->99%),Val Acc却下降(60%->55%)
·Train Loss持续下降(0.45->0.05),Val Loss上升(1.10->1.40)
·训练-验证差距不断扩大,是典型的过拟合
2.可能原因:
·模型复杂度过高(相对于数据量)
·缺乏正则化(Dropout、L2)
·训练时间过长(早停机制缺失)
·数据增强不足
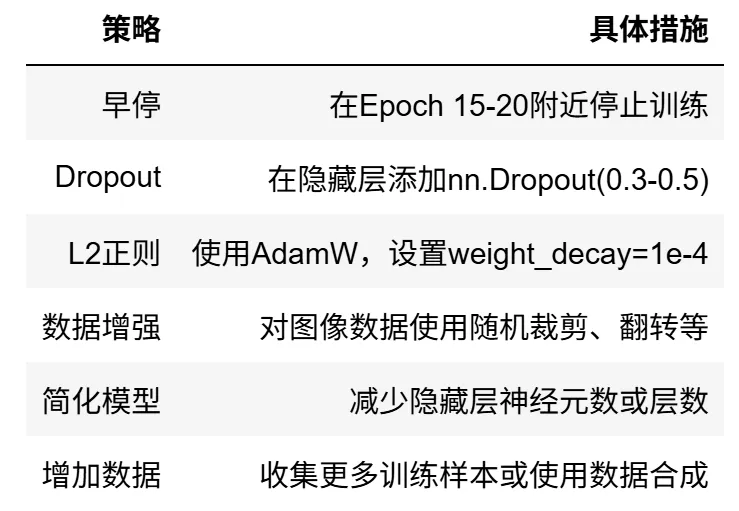
改进建议:
二、选择题
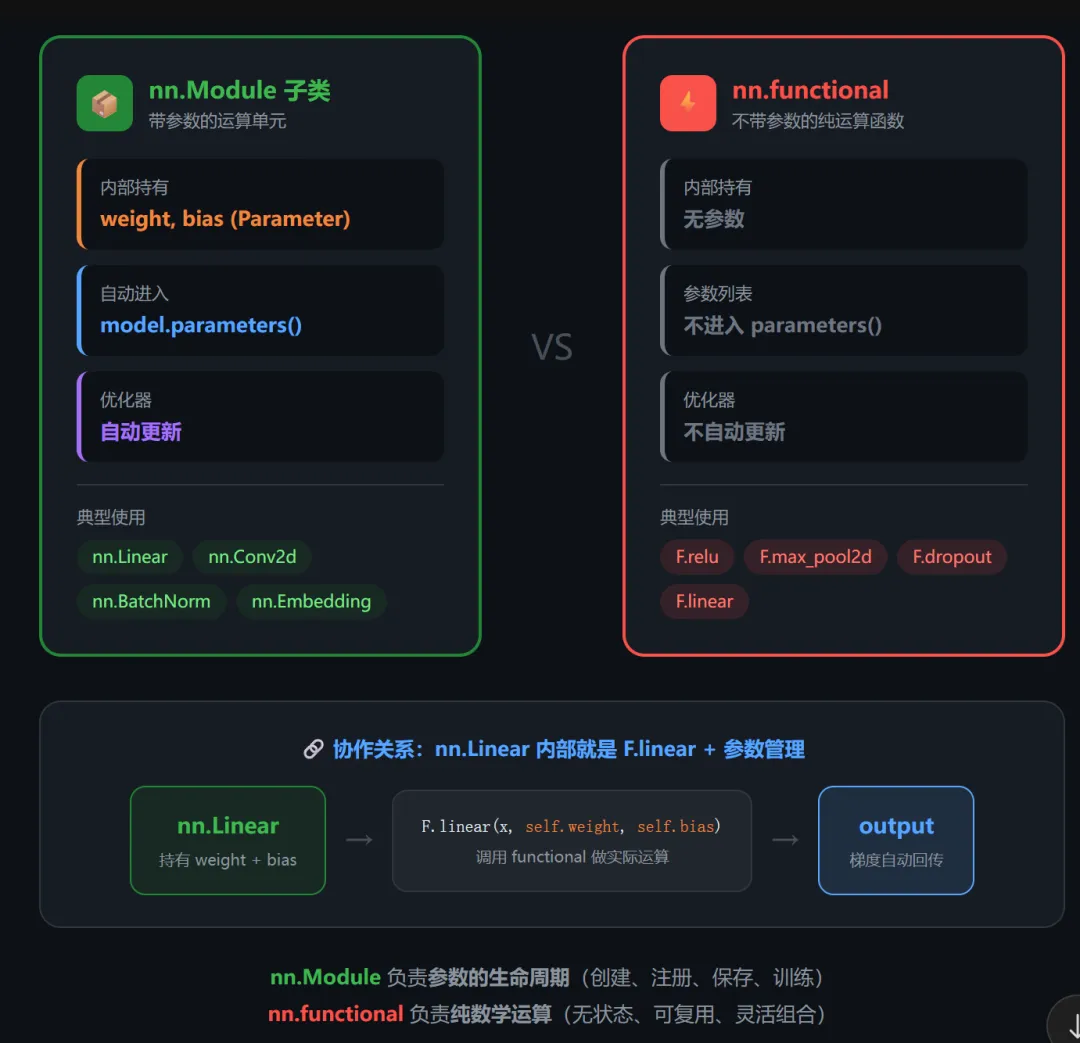
习题1:PyTorch 中nn.Module与nn.functional核心差异描述错误的是?
A. nn.Module 会自动注册可训练参数
B. nn.functional 是无参数纯计算函数
C. nn.Conv2d 属于 nn.Module,F.conv2d 属于 functional
D. F.relu 会自动加入模型参数列表参与优化
考察目的:厘清 PyTorch 两大网络工具区别
解题思路:nn.Module 子类(Linear/Conv)内置权重偏置;functional 仅做运算,无参数存储,不会进入模型参数列表,无法自动更新。
参考答案:D
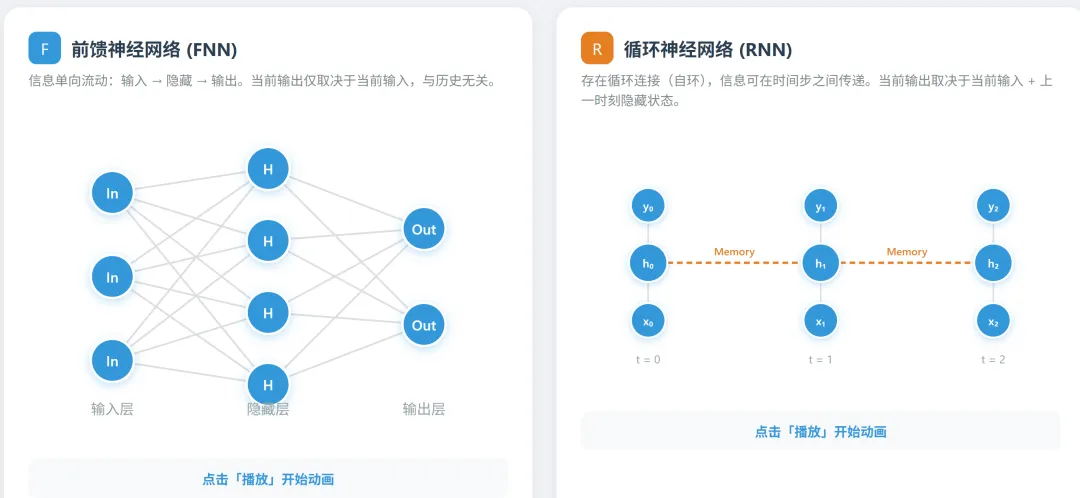
习题2:关于多层前馈神经网络,以下说法正确的是?
A. “前馈”意味着信号不能向后传播,即不存在反向传播
B. 输入层神经元和隐藏层神经元都是功能神经元
C. 隐藏层和输出层神经元包含激活函数,是功能神经元
D. 前馈神经网络中允许同层神经元之间存在连接
考察目的:“前馈”这一术语容易被初学者误解——它指的是网络拓扑结构,而非训练流程。
解题思路:选C。“前馈”仅指网络拓扑不存在环或回路,并不排斥训练时的误差反向传播。输入层仅接收输入,不进行函数处理,不是功能神经元。同层和跨层连接在前馈网络中均不存在。
拓展:前馈神经网络与循环神经网络的主要区别是什么?
资料获取途径
视频连接:
抖音账号:
84911487035
B站主页:
https://space.bilibili.com/391424656
微信公众号【含电子文档及相关代码等】:
大模型大智慧
 10个月宝宝每天需要喝多少奶粉?