Linux 文件系统观测工具(2)
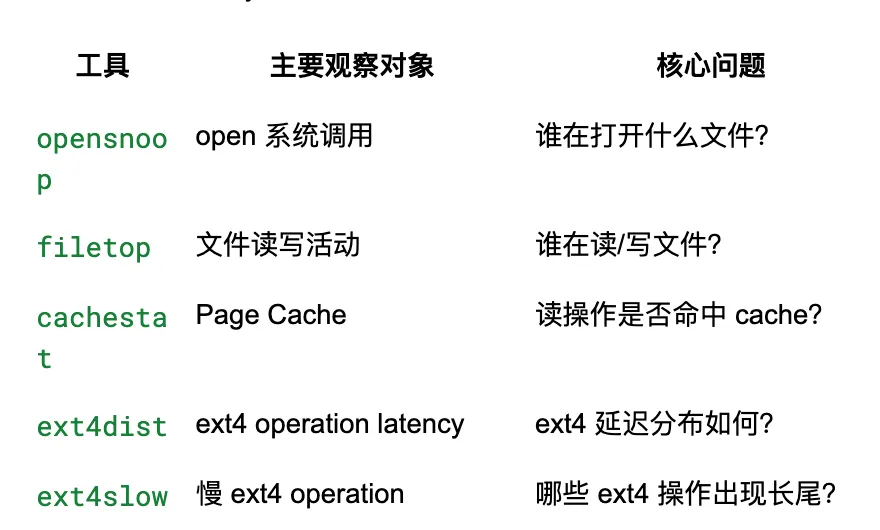
本文介绍几个非常实用的 BCC/eBPF 文件系统观测工具:
1.opensnoop
2.filetop
3.cachestat
4.ext4dist
5.ext4slow
1. opensnoop:谁在打开文件?
opensnoop 是一个非常适合排查文件访问行为的工具。
它主要跟踪 open() / openat() 等文件打开操作,可以回答:
到底是谁在访问哪些文件?
例如:
opensnoop
可能看到:
PIDCOMMFDERRPATH
1234nginx120/etc/nginx/nginx.conf
1234nginx130/var/log/nginx/access.log
5678python30/tmp/data
5678python-12/tmp/not_exist
这里最重要的指标并不是单纯的“open 次数”,而是:
1.1 Open rate
单位时间内发生多少次 open():
opens/sec
如果发现:
100 opens/sec
1000 opens/sec
10000 opens/sec
需要进一步判断。
大量 open() 可能意味着:
Application
├──open()
├──read()
├──close()
├──open()
├──read()
└──close()
应用可能在反复打开同一个文件。
例如:
while (1) {
fd= open("/tmp/config", O_RDONLY);
read(fd,...);
close(fd);
}
这种模式可能造成大量系统调用和文件系统元数据操作。

1.2 Open error
opensnoop 还可以观察打开失败。
例如:
ERR=2
通常对应:
ENOENT
即文件不存在。
如果应用不断:
open()
↓
ENOENT
↓
retry
↓
open()
↓
ENOENT
那么即使磁盘 I/O 很低,也可能产生大量 filesystem syscall。
因此:
opensnoop 更适合观察 filesystem activity,而不是磁盘吞吐。
2. filetop:哪些文件正在产生 I/O?
如果 opensnoop 解决的是:
谁打开了文件?
那么 filetop 更关注:
谁正在对文件进行读写?
运行:
filetop
典型输出类似:
PIDUIDREADSWRITESR_KbW_KbCOMM
123410001201051264nginx
56781000502001282048python
这里需要重点关注几个指标:
READS
WRITES
R_KB
W_KB
2.1 Reads / Writes
例如:
READS = 10000
WRITES = 20
说明这个进程产生了大量读操作。
但这里有一个非常重要的误区:
read 次数高,不代表磁盘读 I/O 高。
因为 Linux 有 Page Cache。
应用执行:
read()
↓
Page Cache hit
↓
直接返回
根本不需要访问磁盘。
所以:
filetop
↓
大量 READ
并不能直接推出:
Disk is busy
必须结合:
cachestat
iostat
一起看。
3. cachestat:Page Cache 到底工作得怎么样?
这是文件系统性能分析中非常重要的一个工具。
cachestat
它主要帮助观察:
文件访问有多少命中了 Page Cache,有多少需要真正从底层存储读取?
典型指标包括:
HITS
MISSES
Dirties
HITRATIO
核心概念是:
Fileread
│
▼
PageCache
/\
hitmiss
││
▼▼
memorydisk

3.1 Cache hit
如果应用读取:
read(file)
数据已经在 Page Cache:
Application
│
▼
Page Cache
│
▼
Application
这种情况下通常不会产生底层磁盘读取。
所以:
Cache Hit Ratio ↑
通常意味着 filesystem read workload 对 Page Cache 比较友好。
3.2 Cache miss
如果数据不在 Page Cache:
Application
│
▼
Page Cache miss
│
▼
Filesystem
│
▼
Block layer
│
▼
Disk / EBS / NVMe
这时候才可能产生真正的 block I/O。
因此一个非常重要的性能分析链条是:
filetop
│
│READS 很高
▼
cachestat
│
├──HIT 很高
│└──主要是 memory access
│
└──MISS 很高
└──进一步检查 block I/O
│
▼
iostat
3.3 Cache hit ratio
一个非常有价值的指标是:
hit ratio =
cachehits /
(cachehits + cache misses)
例如:
HITSMISSESHIT%
900001000090%
说明大约 90% 的文件读取可以从 Page Cache 满足。
如果突然变成:
HITSMISSESHIT%
500005000050%
那么需要进一步调查:
为什么 Page Cache miss 增加?
可能原因包括:
●working set 增大
●memory pressure
●新文件大量读取
●顺序扫描
●cache 被其他 workload 淘汰
●应用访问模式发生变化
所以:
cachestat 是连接“文件访问”和“真正磁盘 I/O”的重要桥梁。
4. ext4dist (xfs, zfs, btrfs, nfs)延迟分布
前面的工具主要观察:
Application
│
▼
Filesystem access
而 ext4dist 开始进入:
Filesystem implementation
它主要用于观察 ext4 文件系统相关操作的延迟分布。
例如:
ext4dist
可能得到类似:
operation = read
usecs: countdistribution
0-> 1: 100
2-> 3: 500
4-> 7: 1000
8-> 15: 3000
16-> 31: 500
32-> 63: 100
这里最重要的思想不是某一个平均值,而是:
Latency distribution
4.1 为什么 histogram 比 average 更重要?
假设有 1000 次 filesystem operation。
其中:
999 次 = 1 ms
1 次= 1 second
平均延迟:
≈ 2 ms
看起来并不严重。
但是应用可能正好遇到了那一次:
1 second
于是用户感觉:
“偶尔会卡一下。”
所以对于 filesystem latency:
Average
通常不如:
P50
P90
P95
P99
P99.9
或者 histogram 有价值。

4.2 ext4dist 能回答什么?
例如发现:
Most operations:
< 1ms
但同时:
1% operations:
> 100ms
那么问题就变成:
为什么 ext4 operation 出现长尾?
进一步可以结合:
ext4slow
定位具体慢操作。
因此:
ext4dist
│
│latency distribution
▼
发现 tail latency
│
▼
ext4slow
│
│找具体 slow operation
▼
进一步定位
5. ext4slow(xfs, zfs, btrfs, nfs):慢操作
ext4slow 可以理解成:
针对 ext4 的 slow operation tracer。
它非常适合排查:
偶发 filesystem latency
例如:
ext4 operation > threshold
然后记录:
PID
process
operation
latency
这样可以从:
“ext4 很慢”
进一步变成:
PID 1234
↓
nginx
↓
某个 ext4 operation
↓
latency = 150ms
这比单纯看到:
disk util = 80%
有价值得多。

6. 五个工具应该如何组合?
这几个工具其实不是互相独立的。
它们分别观察 filesystem 的不同层次:
可以把它们放到 Linux I/O stack 中理解:
Application
│
│open()
▼
opensnoop
│
▼
VFS/ Filesystem
│
┌────┴───────┐
││
▼▼
filetopcachestat
read/writecachehit/miss
│
▼
PageCache miss
│
▼
ext4
┌──────┴──────┐
││
▼▼
ext4distext4slow
latencyslowops
││
└──────┬──────┘
▼
BlockLayer
│
▼
NVMe/ EBS
7. 一个实际的排障流程
假设应用出现:
“文件访问偶尔很慢。”
不要一上来就:
iostat
可以按照下面的路径逐层观察。

Step 1:谁在访问文件?
opensnoop
发现:
python
nginx
java
大量访问某些文件。

Step 2:谁产生了大量 filesystem activity?
filetop
发现:
PID 1234
READS = 10000/s
这时候还不能判断磁盘有问题。

Step 3:检查 Page Cache
cachestat
发现:
HIT= 30%
MISS = 70%
说明大量 read 没有命中 Page Cache。
此时才值得继续调查:
memory pressure?
working set?
disk latency?
Step 4:观察 ext4 latency
ext4dist
发现:
Most operations < 1ms
but some operations > 100ms
说明 filesystem operation 存在明显的 tail latency。

Step 5:找具体慢操作
ext4slow
找到:
PID 1234
process = python
operation = ...
latency = 150ms
于是排查范围从:
“Linux filesystem 很慢”
缩小到:
某个进程
↓
某类 ext4 operation
↓
出现 150ms latency
这才是有效的性能分析。

最终形成一个非常实用的观测思维:
谁在访问 → 访问什么 → 访问多少 → 是否命中 Cache → ext4 是否变慢 → 哪个操作出现长尾。
这比单独查看 iostat 的磁盘吞吐、IOPS 和 utilization 更接近文件系统本身的性能问题。