来源:网络
框架示例
Scrapy 是一个用于抓取网站和提取结构化数据的应用程序框架,可用于各种有用的应用程序,如数据挖掘、信息处理或历史存档。
下面是一个爬虫的代码,它从网站http://quotes.toscrape.com 中抓取名言 ,遵循分页:
import scrapyclassQuotesSpider(scrapy.Spider): name = 'quotes' start_urls = ['http://quotes.toscrape.com/tag/humor/', ]defparse(self, response):for quote in response.css('div.quote'):yield {'author': quote.xpath('span/small/text()').get(),'text': quote.css('span.text::text').get(), } next_page = response.css('li.next a::attr("href")').get()if next_page isnotNone:yield response.follow(next_page, self.parse)
将其放入一个文本文件中,将其命名为类似名称 quotes_spider.py 并使用以下 runspider 命令运行:
scrapyrunspiderquotes_spider.py-oquotes.jl
完成后,您将在 quotes.jl 文件中获得 JSON 行格式的引号列表,其中包含文本和作者,如下所示:
{"author": "Jane Austen", "text": "\u201cThe person, be it gentleman or lady, who has not pleasure in a good novel, must be intolerably stupid.\u201d"}{"author": "Steve Martin", "text": "\u201cA day without sunshine is like, you know, night.\u201d"}{"author": "Garrison Keillor", "text": "\u201cAnyone who thinks sitting in church can make you a Christian must also think that sitting in a garage can make you a car.\u201d"}
蜘蛛中间件
Spider 中间件是 Scrapy 蜘蛛处理机制的钩子框架,可以在其中插入自定义功能来处理发送给Spider进行处理的响应以及处理从蜘蛛生成的请求和项目。
架构概览
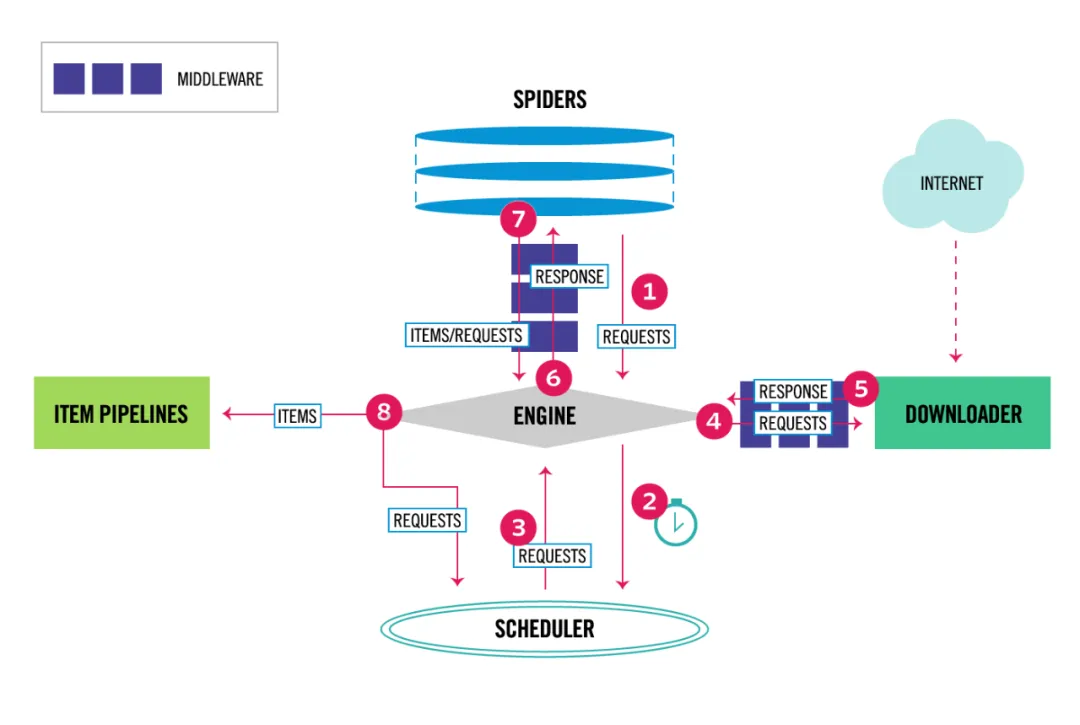
数据流:
执行流程: 1、该引擎获取从最初请求爬行蜘蛛。 2、该引擎安排在请求调度程序和要求下一个请求爬行。 3、该计划返回下一请求的引擎。 4、该引擎发送请求到 下载器,通过下载器中间件。 5、页面完成下载后,下载器生成一个响应(带有该页面)并将其发送到引擎,通过下载器中间件。 6、该引擎接收来自响应下载器并将其发送到所述 蜘蛛进行处理,通过蜘蛛中间件。 7、该蜘蛛处理响应并返回旗下的项目和新的要求(跟随)的引擎,通过蜘蛛中间件。 8、该引擎发送处理的项目,以项目管道,然后把处理的请求的调度,并要求今后可能请求爬行。 9、该过程重复(从第 1 步开始),直到不再有来自Scheduler 的请求 。
安装指南
Scrapy 需要 Python 3.6+,CPython 实现(默认)或 PyPy 7.2.0+ 实现。
安装 Scrapy
如果您使用的是Anaconda或Miniconda,则可以从conda- forge频道安装该软件包,该频道具有适用于 Linux、Windows 和 macOS 的最新软件包。
要使用 安装 Scrapy conda,请运行:
conda install -c conda-forge scrapy
或者,如果您已经熟悉 Python 包的安装,则可以使用以下命令从 PyPI 安装 Scrapy 及其依赖项:
pip install Scrapy
注意:Scrapy 是用纯 Python 编写的,并且依赖于一些关键的 Python 包
lxml,一个高效的 XML 和 HTML 解析器
parsel,一个写在 lxml 之上的 HTML/XML 数据提取库
w3lib,用于处理 URL 和网页编码的多用途助手
扭曲,一个异步网络框架
密码学和pyOpenSSL,处理各种网络级安全需求
核心API
爬虫API
Scrapy API 的主要入口点是Crawler 对象,通过from_crawler类方法传递给扩展。该对象提供对所有 Scrapy 核心组件的访问,它是扩展访问它们并将其功能挂钩到 Scrapy 的唯一方法。
设置 API
设置 Scrapy 中使用的默认设置优先级的键名和优先级的字典。
每个项目都定义了一个设置入口点,为其提供了一个用于标识的代码名称和一个整数优先级。在Settings类中设置和检索值时,较大的优先级比较小的优先级更高 。
蜘蛛加载器API
这个类负责检索和处理跨项目定义的蜘蛛类。
可以通过在SPIDER_LOADER_CLASS项目设置中指定它们的路径来使用自定义蜘蛛加载器 。他们必须完全实现scrapy.interfaces.ISpiderLoader接口以保证无错执行。
信号 API
将接收器的功能连接到信号。
信号可以是任何对象,尽管 Scrapy 带有一些预定义的信号,这些信号记录在信号 部分。
统计收集器 API
scrapy.statscollectors模块下有几个可用的统计收集器 ,它们都实现了StatsCollector 类定义的统计收集器 API (它们都继承自)。
—END—
更多参考:https://github.com/scrapy/scrapy
长按或扫描下方二维码,免费获取 Python公开课和大佬打包整理的几百G的学习资料,内容包含但不限于Python电子书、教程、项目接单、源码等等
▲扫描二维码-免费领取
推荐阅读
10 亿次嵌套循环性能对比,Python 表现最差
为什么我建议你用 Python 多进程?
Python 3.15 JIT真相:3-5倍加速是误传
你写的Python代码还是Pythonic代码?