RockyLinux 8 编译安装 CP2K-2026.2(GNU/OpenBLAS 版)比intel/mkl更稳定
- 2026-10-11 06:55:39
RockyLinux 8 编译安装 CP2K-2026.2(GNU/OpenBLAS 版)完整实战指南
本文由 LEEHPC 一粒海团队整理发布,原文首发于微信公众号「服务器与科学计算」
一句话总结: 在 RockyLinux 8 上用 GCC Toolset 14 + OpenMPI + OpenBLAS + FFTW 编译 CP2K-2026.2,依赖全部由官方 toolchain 自动安装,绕开 Intel MKL 在部分平台上的矩阵运算兼容性报错,编译产物 cp2k.popt / cp2k.psmp 位于 install/bin 下,可直接用于 CPU 集群生产环境。
核心结论:Intel 编译器加 MKL 编出来的 CP2K,在 AMD EPYC、新旧架构混搭、大规模对角化这些场景下可能报 not enough memory、out of memory、malloc failed,但查下来节点物理内存根本没耗尽——这类问题基本就是 MKL 兼容性导致的。换成 GCC 14 + OpenBLAS 组合能稳定绕开,多数常规 DFT、AIMD 任务性能体感差别不大。下面按系统准备、toolchain 编译、主程序编译、验证测试、Slurm 提交的顺序记录完整过程,附踩坑对照表和 FAQ。
测试环境操作系统:RockyLinux 8.x软件版本:CP2K-2026.2、GCC Toolset 14(gcc/gfortran 14)、OpenMPI(toolchain 自动编译)、OpenBLAS、FFTW硬件平台:CPU 集群环境(无 GPU,具体 CPU 型号未指定)本文由 LEEHPC 一粒海团队基于实际项目经验整理
本文涵盖
• 为什么弃用 Intel MKL 方案,改用 GNU + OpenBLAS • 编译方案的组件取舍(GPU、ELPA、DeepMD 等为什么全关) • 系统环境准备、toolchain 依赖编译、主程序编译的完整命令 • 编译产物说明、运行验证、Slurm 作业提交 • 常见报错对照表与 FAQ
1. 为什么这次用 GNU + OpenBLAS,而不是 Intel MKL?
先交代背景。部分 HPC 集群里,用 Intel 编译器(icc/icx/ifort/ifx)配合 Intel MKL 数学库编出来的 CP2K,实际计算时可能突然崩掉,报错长这样:
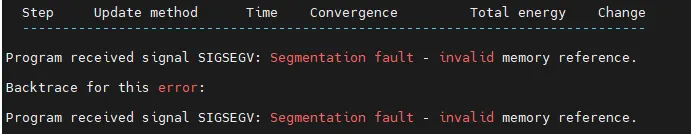
这类报错表面上看很像内存不足,常见的有:
• not enough memory• out of memory• malloc failed• 矩阵求解阶段异常中止 • 对角化或线性代数计算阶段崩溃
但真去查节点,物理内存往往根本没耗尽。排查下来,问题大概率出在 Intel MKL 在特定平台、特定矩阵运算或特定并行方式下的兼容性上。下面这些场景更容易踩中:
• AMD EPYC 平台; • Intel 新架构平台搭配旧版本 MKL; • 多节点 MPI 并行计算; • 大规模矩阵对角化; • 高并发调用 BLAS/LAPACK/ScaLAPACK; • OpenMP 线程数与 MPI 进程数配得不合理; • Intel oneAPI、MPI、MKL 版本组合互相不匹配。
所以这里选 GNU 编译器 + OpenBLAS + OpenMPI 这套组合,稳是第一位的。说句实话,MKL 单个库性能确实强,但出了问题定位成本太高,集群生产环境折腾不起。
2. 本次编译方案一览
这套组合定位很明确:CPU 集群、常规科学计算任务、追求稳定可复现。
3. 为什么把 GPU、ELPA、DeepMD 这些模块全关掉?
3.1 不编译 GPU 的原因
本文档面向 CPU 集群环境,不启用 CUDA/HIP/SYCL 等 GPU 后端。集群没有 GPU 节点、用户主要跑 CPU 队列的话,直接明确关掉:
--gpu-ver=no这么做能避免 toolchain 去检测 CUDA、cuBLAS、cuFFT、NCCL 等组件时冒出一堆额外问题。官方文档这块写得比较模糊,实测关掉之后干净利落。
3.2 不编译 ELPA 的原因
ELPA 是高性能本征值求解库,理论上能提升部分对角化场景的性能。但在 GNU 编译环境下,ELPA 某些版本组合容易碰上 Fortran 参数传递、接口兼容或编译器优化方面的问题。部分问题改源码或降优化级别能绕过,但为了计算稳定性和结果可靠性,这次直接不编译:
--with-elpa=no对多数常规 CP2K 计算来说,不启用 ELPA 对整体性能影响通常不大,这里不用太纠结。
3.3 不编译 DeepMD、LibTorch 和 GauXC 的原因
DeepMD 和 LibTorch 主要是机器学习势能相关功能用的;GauXC 更多服务于特定 GPU 加速泛函计算场景。如果集群主要跑常规 DFT、AIMD、QS、FIST、QMMM 这类任务,先不编译这些组件,编译复杂度能降不少:
--with-deepmd=no--with-libtorch=no--with-gauxc=no4. 编译前系统环境怎么准备?
4.1 启用 devel 仓库
RockyLinux 8 里,GCC Toolset 通常来自额外的软件仓库,先启用 devel 仓库:
dnf config-manager --set-enabled devel如果提示 config-manager 命令不存在,先装一下:
dnf install -y dnf-plugins-core4.2 安装 GCC Toolset 14
dnf install -y gcc-toolset-14*装完加载 GCC 14 环境:
source /opt/rh/gcc-toolset-14/enable验证三个编译器的版本:
gcc --versiong++ --versiongfortran --version正常输出类似:
gcc (GCC) 14.x.xGNU Fortran (GCC) 14.x.x注意:source /opt/rh/gcc-toolset-14/enable 只对当前 Shell 会话生效,退出终端就得重新加载。这点容易忘,后面跑 toolchain 前记得先 source。
4.3 安装基础依赖
常用编译工具和依赖包建议提前装齐:
dnf install -y \ wget curl git \ tar bzip2 gzip xz unzip \ make cmake ninja-build \ patch diffutils \ perl python3 python3-pip \ m4 autoconf automake libtool \ which file findutils \ hostname \ openssl-devel \ zlib-devel \ libffi-devel5. 怎么下载解压 CP2K-2026.2 源码?
mkdir -p /public/softwarescd /public/softwares从 CP2K 官方 GitHub Release 页面下载源码包:
wget https://github.com/cp2k/cp2k/releases/download/v2026.2/cp2k-2026.2.tar.bz2服务器连不上外网的话,也可以本地下载好再传上去。
tar -xjf cp2k-2026.2.tar.bz2cd /public/softwares/cp2k-2026.2确认目录结构:
ls应能看到:
arch benchmarks data exe src tests tools6. toolchain 依赖编译怎么做?
CP2K 官方提供了 tools/toolchain/install_cp2k_toolchain.sh,自动下载、编译、配置所有依赖库,省去手动逐个装 OpenMPI、OpenBLAS、ScaLAPACK、FFTW 的麻烦。
cd /public/softwares/cp2k-2026.2/tools/toolchain6.1 执行 toolchain 编译
本次编译命令如下:
./install_cp2k_toolchain.sh \ --install-all \ --gpu-ver=no \ --with-gcc=system \ --with-elpa=no \ --with-deepmd=no \ --with-libtorch=no \ --with-gauxc=no \ --with-openmpi=install \ -j 646.2 参数说明
--install-all | |
--gpu-ver=no | |
--with-gcc=system | |
--with-elpa=no | |
--with-deepmd=no | |
--with-libtorch=no | |
--with-gauxc=no | |
--with-openmpi=install | |
-j 64 |
想更明确地指定数学库,可以加:
--math-mode=openblas完整命令也可以写成:
./install_cp2k_toolchain.sh \ --install-all \ --math-mode=openblas \ --gpu-ver=no \ --with-gcc=system \ --with-elpa=no \ --with-deepmd=no \ --with-libtorch=no \ --with-gauxc=no \ --with-openmpi=install \ -j 646.3 并行编译线程数怎么定
-j 64 是编译时用 64 个并行任务,具体看 CPU 核心数和内存来调:
lscpunproc编译节点内存偏小的话,建议降下来:
-j 32或者:
-j 16这里坑过我一次:机器内存不大,-j 64 直接把编译进程干到 OOM,日志里就剩个 Killed。
6.4 安装包和跳过包检查
toolchain 执行过程中会列出哪些依赖库要装、哪些跳过:
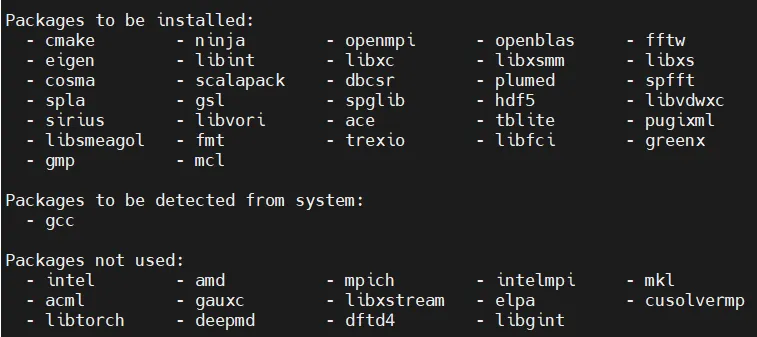
重点关注这几项:
• OpenMPI 是否为 install• OpenBLAS 是否为 install• ScaLAPACK 是否为 install• FFTW 是否为 install• ELPA 是否为 no• GPU/CUDA 相关组件是否为 no• DeepMD、LibTorch、GauXC 是否为 no
6.5 CPU 架构自动识别与异构集群处理
toolchain 会自动识别当前处理器架构,编译时加入优化参数,比如:
• -march=native• -mtune=native• AVX2 • AVX512 • Zen/Zen2/Zen3/Zen4 相关优化
识别过程长这样:

这里要注意:集群里不同计算节点 CPU 架构不一致的话,-march=native 编出来的二进制可能在老节点上直接跑不起来,报 Illegal instruction。异构集群建议指定更通用的目标 CPU:
./install_cp2k_toolchain.sh \ --install-all \ --math-mode=openblas \ --gpu-ver=no \ --with-gcc=system \ --with-elpa=no \ --with-deepmd=no \ --with-libtorch=no \ --with-gauxc=no \ --with-openmpi=install \ --target-cpu=generic \ -j 64所有节点 CPU 型号一致的话,用默认自动优化拿更好的性能就行。
6.6 toolchain 编译完成
toolchain 顺利结束后,终端会出现类似下面的提示,看到就说明依赖这一步过了:
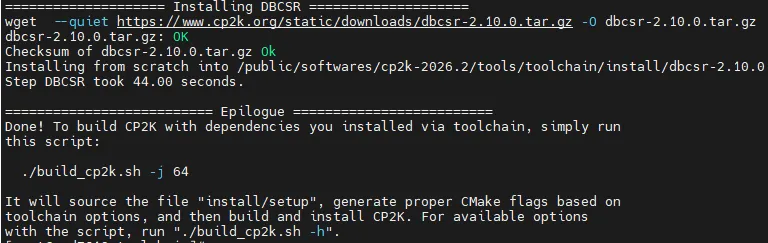
install/ 目录下,后续主程序编译和运行环境都依赖它。7. CP2K 主程序怎么编译?
toolchain 编完,接着编主程序。toolchain 目录下执行:
cd /public/softwares/cp2k-2026.2/tools/toolchain./build_cp2k.sh -j 64这个脚本会自动加载 toolchain 生成的环境,并调用 CP2K 编译系统。
编译成功后,可执行文件一般在:
/public/softwares/cp2k-2026.2/install/bin查看生成的文件:
ls -lh /public/softwares/cp2k-2026.2/install/bin常见可执行文件:
cp2k.popt | ||
cp2k.psmp | ||
cp2k.sopt | ||
cp2k.ssmp |
8. 运行环境怎么加载、怎么确认装好了?
跑 CP2K 前,先加载编译生成的环境变量:
source /public/softwares/cp2k-2026.2/install/cp2k_env不确定文件在哪,直接搜:
find /public/softwares/cp2k-2026.2 -name cp2k_env验证命令:
which cp2k.poptcp2k.popt --version能正常打出版本信息就说明环境加载对了,输出类似:
CP2K version 2026.29. 编译完怎么快速跑通一个测试?
准备一个 CP2K 输入文件,比如 test.inp,单节点 MPI 测试:
source /public/softwares/cp2k-2026.2/install/cp2k_envmpirun -np 64 cp2k.popt -i test.inp -o test.out正常结束时,输出文件末尾通常有:
PROGRAM ENDED AT或:
CP2K而且没有明显的 ERROR、ABORT、NaN、Segmentation fault 之类的字样。
10. Slurm 作业脚本怎么写?
以纯 MPI 方式提交 cp2k.popt 为例:
#!/bin/bash#SBATCH --job-name=cp2k_popt#SBATCH --partition=compute#SBATCH --nodes=1#SBATCH --ntasks-per-node=32#SBATCH --cpus-per-task=1#SBATCH --output=%x_%j.out#SBATCH --error=%x_%j.err# 加载 CP2K 环境(含 toolchain 编译的 OpenMPI/OpenBLAS 等库路径)source /public/softwares/cp2k-2026.2/install/cp2k_env# 纯 MPI 模式,每任务只留 1 个线程,避免和 MPI 进程抢核export OMP_NUM_THREADS=1INPUT=your_input.inpOUTPUT=your_output.outmpirun -np ${SLURM_NTASKS} cp2k.popt -i ${INPUT} -o ${OUTPUT}多节点跑的话,把 --nodes 和 --ntasks-per-node 按实际资源改一下,mpirun -np ${SLURM_NTASKS} 会自动用上 Slurm 分配的总任务数。
11. 踩坑记录
下面这些坑都是实际部署时遇到的,按报错现象、原因、解决办法整理成表:
No such command: config-manager | dnf install -y dnf-plugins-core | |
gfortran: command not found | source /opt/rh/gcc-toolset-14/enablednf install -y gcc-toolset-14-gcc-gfortran | |
build/ 或缓存目录,再重跑脚本 | ||
Illegal instruction | -march=native | --target-cpu=generic |
error while loading shared libraries: libxxx.so | LD_LIBRARY_PATH | source .../install/cp2k_env |
export CP2K_DATA_DIR=/public/softwares/cp2k-2026.2/dataBASIS_SET_FILE_NAME BASIS_MOLOPT、POTENTIAL_FILE_NAME GTH_POTENTIALS,或直接用绝对路径 |
补充一句:编译中途被 OOM 干掉(日志里只剩 Killed)的话,多半是 -j 并行数开太高,降到 -j 16 再试,用 dmesg | tail -n 50 确认。
12. 最终测试命令汇总
# 加载 GCC 14source /opt/rh/gcc-toolset-14/enable# 加载 CP2K 环境source /public/softwares/cp2k-2026.2/install/cp2k_env# 检查 MPIwhich mpirunmpirun --version# 检查 CP2Kwhich cp2k.poptcp2k.popt --version# 运行测试mpirun -np 64 cp2k.popt -i test.inp -o test.out正式提供给用户之前,建议把下面几项过一遍:
1. cp2k.popt --version正常;2. 简单输入文件可正常运行; 3. 常用计算类型测试通过; 4. Slurm 作业可正常提交; 5. 多节点 MPI 运行正常; 6. 无 MKL 相关动态库残留。
13. 常见问题(FAQ)
Q1:为什么不用 Intel MKL 编译 CP2K,非要换成 GNU + OpenBLAS?
简单说就是稳。Intel 编译器加 MKL 编出来的 CP2K,在 AMD EPYC 平台、Intel 新架构配旧版 MKL、多节点 MPI、大规模矩阵对角化这些场景下,可能报 not enough memory、malloc failed,但节点物理内存实际没满——定位下来是 MKL 兼容性问题。GNU + OpenBLAS 这套组合能稳定绕开,多数常规 DFT、AIMD 任务性能差距不大,集群生产环境更省心。
Q2:不编译 ELPA 对 CP2K 性能影响大吗?
对多数常规 CP2K 计算,影响通常不大。ELPA 主要优化本征值求解场景,理论上能提速,但 GNU 环境下某些版本组合有 Fortran 接口兼容问题,折腾起来不值。等需要大规模对角化的任务多起来,可以单独再测。
Q3:集群节点 CPU 型号不一致,编译时要注意什么?
关键一条:别用默认的 -march=native。toolchain 会自动按编译节点的 CPU 做优化,编出来的二进制在指令集较老的节点上会报 Illegal instruction。异构集群编译时加 --target-cpu=generic,所有节点一致就用默认自动优化拿性能。
Q4:cp2k.popt 和 cp2k.psmp 该怎么选?
纯 MPI 场景用 cp2k.popt,每任务 1 线程,配 OMP_NUM_THREADS=1,适合大规模并行。想减少 MPI 进程数、加大每进程线程数时用 cp2k.psmp。具体哪个快,跟体系规模和节点配置有关,建议两种都测一下。
Q5:运行时提示找不到动态库 libxxx.so 怎么办?
先 source .../install/cp2k_env 确认 LD_LIBRARY_PATH 是否带上了编译出的库目录,再用 ldd $(which cp2k.popt) | grep "not found" 精确定位缺哪个库。根据 LEEHPC 团队实测经验,这类问题九成是环境没加载或者加载顺序不对,很少是库真的没编出来。
关于 LEEHPC 一粒海
LEEHPC 一粒海专注于高性能计算、AI 服务器与科学计算软件编译优化,提供 GPU/CPU 服务器定制、Slurm 集群调度、InfiniBand 网络部署、Lustre/BeeGFS 并行存储,以及 VASP、LAMMPS、CP2K、QE、ABACUS、GROMACS 等科研软件的编译与性能调优服务。
更多技术文章,欢迎关注微信公众号「服务器与科学计算」官网:www.leehpc.cn
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 一个【资源清单】,解决了Python初学者的报错焦虑
- 5套Python智能体实战视频,从Ollama到飞书集成
- 35岁财务BP内卷严重,懂Python在一线薪资翻倍
- 整理了100个Python精选库,建议收藏!
- 学会python之后,真的很难再找到低薪的工作...
- 10个Python常见函数
- 我用 Python 把《反脆弱》模拟了 10 万次:稳定,才是最危险的
- Python每日知识点|Day13 异常捕获 try-exc
- 第348讲:Python的打包分发,和VBA的天然集成:EXE打包与无环境部署(给不懂编程的同事用)
- 使用 Python 和 OCR 整理发票