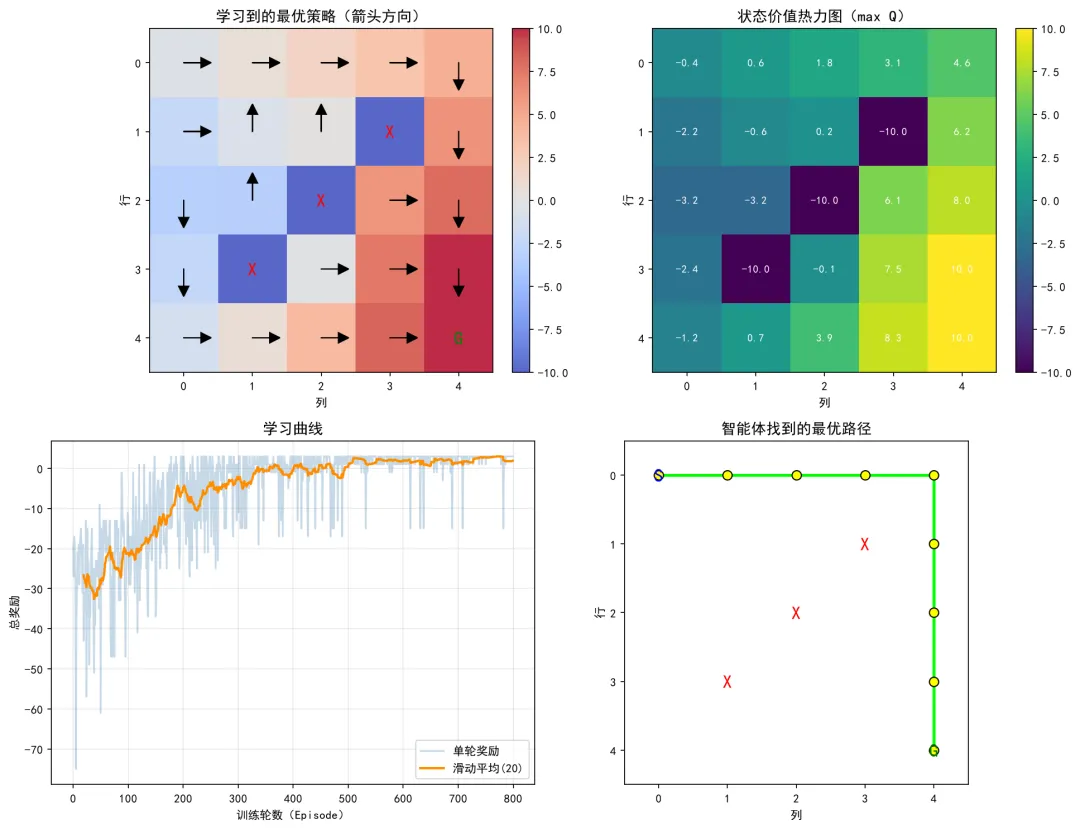
import numpy as npimport matplotlib.pyplot as pltplt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei', 'PingFang SC', 'Noto Sans CJK SC', 'DejaVu Sans']plt.rcParams['axes.unicode_minus'] = Falsenp.random.seed(42)class GridWorld: """5x5 网格世界环境""" def __init__(self, size=5, start=(0,0), goal=(4,4), traps=None, step_penalty=-1, goal_reward=10, trap_penalty=-10, out_of_bounds_penalty=-2): self.size = size self.start = start self.goal = goal self.traps = traps if traps else [] self.step_penalty = step_penalty self.goal_reward = goal_reward self.trap_penalty = trap_penalty self.out_of_bounds_penalty = out_of_bounds_penalty self.num_states = size * size self.num_actions = 4 self.agent_pos = start # 动作: 0上 1下 2左 3右 self.action_moves = [(-1, 0), (1, 0), (0, -1), (0, 1)] def reset(self): """重置智能体到起点""" self.agent_pos = self.start return self.state_index(self.agent_pos) def state_index(self, pos): """将 (row, col) 转换为状态索引""" return pos[0] * self.size + pos[1] def index_to_pos(self, index): """将状态索引转换回 (row, col)""" return (index // self.size, index % self.size) def is_terminal(self, state): """判断是否为终止状态(终点或陷阱)""" pos = self.index_to_pos(state) return pos == self.goal or pos in self.traps def step(self, action): """执行动作,返回下一状态、奖励、是否终止""" row, col = self.agent_pos dr, dc = self.action_moves[action] new_row, new_col = row + dr, col + dc # 检查是否出界 if not (0 <= new_row < self.size and 0 <= new_col < self.size): self.agent_pos = (row, col) # 保持原地 return self.state_index(self.agent_pos), self.out_of_bounds_penalty, False self.agent_pos = (new_row, new_col) next_state = self.state_index(self.agent_pos) # 判断奖励与终止 if self.agent_pos == self.goal: return next_state, self.goal_reward, True elif self.agent_pos in self.traps: return next_state, self.trap_penalty, True else: return next_state, self.step_penalty, Falsedef get_optimal_path(env, q_table): """根据学习到的 Q 表,从起点出发走最优路径""" path = [] state = env.reset() path.append(env.index_to_pos(state)) for _ in range(env.num_states): if env.is_terminal(state): break action = np.argmax(q_table[state]) row, col = env.index_to_pos(state) dr, dc = env.action_moves[action] new_pos = (row + dr, col + dc) # 防止走出边界 if not (0 <= new_pos[0] < env.size and 0 <= new_pos[1] < env.size): break state = env.state_index(new_pos) path.append(new_pos) if env.is_terminal(state): break return pathdef moving_average(data, window=20): """计算滑动平均""" if len(data) < window: return np.array(data) return np.convolve(data, np.ones(window)/window, mode='valid')def plot_results(env, q_table, rewards_history): fig, axes = plt.subplots(2, 2, figsize=(13, 10)) # 计算状态价值 V(s) = max_a Q(s,a) values = np.max(q_table, axis=1).reshape(env.size, env.size) values[env.goal] = env.goal_reward for trap in env.traps: values[trap] = env.trap_penalty # --- 1. 学习到的最优策略 --- ax = axes[0, 0] im = ax.imshow(values, cmap='coolwarm', origin='upper', alpha=0.85) ax.set_title('学习到的最优策略(箭头方向)', fontsize=13) for r in range(env.size): for c in range(env.size): state = env.state_index((r, c)) if (r, c) == env.goal: ax.text(c, r, 'G', ha='center', va='center', fontsize=16, fontweight='bold', color='green') elif (r, c) in env.traps: ax.text(c, r, 'X', ha='center', va='center', fontsize=16, fontweight='bold', color='red') else: action = np.argmax(q_table[state]) dr, dc = env.action_moves[action] ax.arrow(c, r, dc*0.4, dr*0.4, head_width=0.15, head_length=0.15, fc='black', ec='black', length_includes_head=True) ax.set_xticks(np.arange(env.size)) ax.set_yticks(np.arange(env.size)) ax.set_xticklabels([str(i) for i in range(env.size)]) ax.set_yticklabels([str(i) for i in range(env.size)]) ax.set_xlabel('列') ax.set_ylabel('行') plt.colorbar(im, ax=ax, fraction=0.046, pad=0.04) # --- 2. 状态价值热力图 --- ax = axes[0, 1] im2 = ax.imshow(values, cmap='viridis', origin='upper') ax.set_title('状态价值热力图(max Q)', fontsize=13) for r in range(env.size): for c in range(env.size): ax.text(c, r, f'{values[r, c]:.1f}', ha='center', va='center', color='white', fontsize=9) ax.set_xticks(np.arange(env.size)) ax.set_yticks(np.arange(env.size)) ax.set_xticklabels([str(i) for i in range(env.size)]) ax.set_yticklabels([str(i) for i in range(env.size)]) ax.set_xlabel('列') ax.set_ylabel('行') plt.colorbar(im2, ax=ax, fraction=0.046, pad=0.04) # --- 3. 学习曲线 --- ax = axes[1, 0] ax.plot(rewards_history, alpha=0.3, color='steelblue', label='单轮奖励') window = 20 if len(rewards_history) >= window: smoothed = moving_average(rewards_history, window) ax.plot(range(window-1, len(rewards_history)), smoothed, color='darkorange', linewidth=2, label='滑动平均(20)') ax.set_xlabel('训练轮数(Episode)') ax.set_ylabel('总奖励') ax.set_title('学习曲线', fontsize=13) ax.legend() ax.grid(alpha=0.3) # --- 4. 最优路径 --- ax = axes[1, 1] ax.imshow(np.zeros((env.size, env.size)), cmap='Greys', origin='upper', alpha=0.1) ax.set_title('智能体找到的最优路径', fontsize=13) for trap in env.traps: ax.text(trap[1], trap[0], 'X', ha='center', va='center', fontsize=16, fontweight='bold', color='red') ax.text(env.goal[1], env.goal[0], 'G', ha='center', va='center', fontsize=16, fontweight='bold', color='green') ax.text(env.start[1], env.start[0], 'S', ha='center', va='center', fontsize=16, fontweight='bold', color='blue') path = get_optimal_path(env, q_table) if path: rows = [p[0] for p in path] cols = [p[1] for p in path] ax.plot(cols, rows, 'o-', color='lime', linewidth=2.5, markersize=8, markerfacecolor='yellow', markeredgecolor='black') ax.set_xticks(np.arange(env.size)) ax.set_yticks(np.arange(env.size)) ax.set_xticklabels([str(i) for i in range(env.size)]) ax.set_yticklabels([str(i) for i in range(env.size)]) ax.set_xlabel('列') ax.set_ylabel('行') plt.tight_layout() plt.savefig('reward_punishment_qlearning.png', dpi=150, bbox_inches='tight') plt.show()if __name__ == '__main__': # 创建环境 env = GridWorld( size=5, start=(0, 0), goal=(4, 4), traps=[(1, 3), (3, 1), (2, 2)], step_penalty=-1, goal_reward=10, trap_penalty=-10, out_of_bounds_penalty=-2 ) # 初始化 Q 表 q_table = np.zeros((env.num_states, env.num_actions)) # 超参数 epsilon = 1.0 # 初始探索率 epsilon_min = 0.01 # 最小探索率 epsilon_decay = 0.995 # 探索率衰减 alpha = 0.1 # 学习率 gamma = 0.9 # 折扣因子 episodes = 800 # 训练轮数 max_steps = 100 # 每轮最大步数 rewards_history = [] print("开始训练 Q-learning 智能体...") for episode in range(episodes): state = env.reset() total_reward = 0 for step in range(max_steps): # ε-贪心策略选择动作 if np.random.rand() < epsilon: action = np.random.randint(env.num_actions) else: action = np.argmax(q_table[state]) # 执行动作 next_state, reward, done = env.step(action) # Q-learning 核心更新 if done: best_next = 0 else: best_next = np.max(q_table[next_state]) q_table[state, action] += alpha * (reward + gamma * best_next - q_table[state, action]) state = next_state total_reward += reward if done: break rewards_history.append(total_reward) epsilon = max(epsilon_min, epsilon * epsilon_decay) if (episode + 1) % 100 == 0: avg_reward = np.mean(rewards_history[-100:]) print(f"Episode {episode+1}/{episodes}, 平均奖励: {avg_reward:.2f}") plot_results(env, q_table, rewards_history)
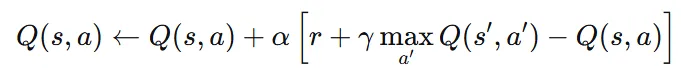
 10个月宝宝每天需要喝多少奶粉?