【Python特征工程系列】Eli5随机打乱特征评估模型性能重要性分析(案例+源码)
- 2026-09-10 17:57:18
这是我的第478篇原创文章。
『数据杂坛』以Python语言为核心,垂直于数据科学领域,专注于(可戳👉)Python程序设计|数据分析|特征工程|机器学习分类|机器学习回归|深度学习分类|深度学习回归|单变量时序预测|多变量时序预测|语音识别|图像识别|自然语音处理|大语言模型|软件设计开发等技术栈交流学习,涵盖数据挖掘、计算机视觉、自然语言处理等应用领域。(文末有惊喜福利)
· Eli5 库通过 Permutation Importance 方法,随机打乱特征值来评估每个特征对模型性能的实际贡献
· 心脏疾病数据集 13 个特征中,cp(胸痛类型)、ca(主要血管数)、thal(地中海贫血类型)为最关键特征
· 随机森林分类模型经网格搜索优化后测试集准确率达 85%,完整代码可复现
Eli5 是一个用于解释机器学习模型的 Python 库,旨在通过可视化和简洁的方式帮助理解模型的决策过程。特别是对于黑箱模型(如随机森林、梯度提升机、神经网络等),Eli5 提供了多种方法来解释和展示模型的内部机制。
Eli5 的主要功能包含:特征重要性评估、模型解释、文本和图像解释等。其中 Permutation Importance 方法是评估特征重要性的核心工具——它通过随机打乱特征值来评估每个特征对模型性能的贡献,可以用于任何监督学习模型。
与传统 feature_importances_ 不同,Permutation Importance 直接反映特征对模型性能(如准确率)的影响。它的工作原理是:逐一打乱每个特征的值,然后观察模型性能下降的程度。性能下降越多,说明该特征越重要。
本案例使用经典心脏疾病预测数据集,包含 297 条样本、13 个特征和 1 个二分类目标变量。特征涵盖年龄(age)、性别(sex)、胸痛类型(cp)、静息血压(trestbps)、血清胆固醇(chol)、空腹血糖(fbs)、静息心电图(restecg)、最大心率(thalach)、运动诱发心绞痛(exang)、ST 段压低(oldpeak)、ST 斜率(slope)、主要血管染色数量(ca)和地中海贫血类型(thal)。
建模流程:采用 随机森林分类器 作为基模型,通过 GridSearchCV 网格搜索优化超参数(n_estimators、max_depth、min_samples_split、min_samples_leaf),5 折交叉验证选择最优模型,最终在测试集上评估并使用 Eli5 进行特征重要性分析。
最优参数:n_estimators=100, max_depth=5, min_samples_split=5, min_samples_leaf=1
交叉验证准确率:83.49% | 测试集准确率:85.00%
通过对训练集执行 Permutation Importance 分析(基于准确率评分),各特征对模型性能的贡献度如下:
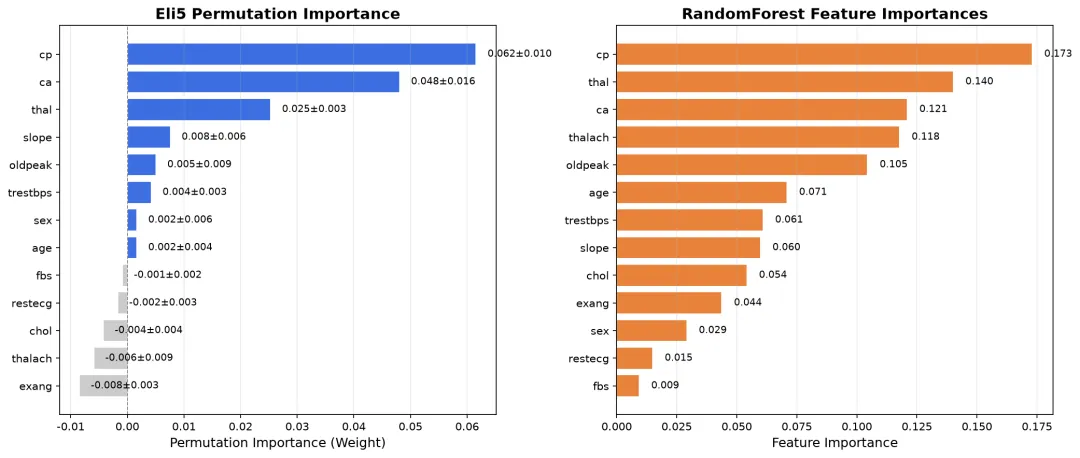
1. cp(胸痛类型):weight = 0.0616 ± 0.0102 — 最重要的预测因子,不同类型胸痛与心脏疾病高度相关
2. ca(主要血管染色数量):weight = 0.0481 ± 0.0164 — 血管病变程度的直接指标
3. thal(地中海贫血类型):weight = 0.0253 ± 0.0027 — 反映血红蛋白异常程度
4. slope(ST 段斜率):weight = 0.0076 ± 0.0056
5. oldpeak(ST 段压低值):weight = 0.0051 ± 0.0086
其余特征(trestbps, sex, age, fbs, restecg, chol, thalach, exang)权重接近零或为负值,表明打乱这些特征对模型性能影响甚微甚至有轻微正向波动。
值得注意的是,Permutation Importance 的结果与 feature_importances_ 存在差异。例如 thalach(最大心率) 在 feature_importances_ 中排名第四(0.1178),但在 Permutation Importance 中权重为负——说明该特征在训练时的分裂贡献并不能直接等同于对模型预测性能的影响。
随机森林由多棵决策树组成,观察单棵决策树的分裂路径可以直观理解模型的决策逻辑。以下以第一棵决策树(max_depth=5)为例:
根节点首先根据 ca ≤ 0.5(主要血管数)进行分裂:
→ 左子树(ca ≤ 0.5):进一步按 thal 分裂,再结合 exang、thalach 等判断
→ 右子树(ca > 0.5):按 cp 分裂,结合 chol、slope 等特征
最终,每个叶节点给出类别预测和概率。树的层次结构清晰展示了各特征对预测结果的逐级影响。
feature_importances_:反映特征在模型训练过程中的分裂贡献(基尼不纯度减少),关注的是特征在构建模型时的作用
Permutation Importance:通过打乱特征值并观察模型性能变化来评估,直接反映特征对模型预测能力的影响
在特征选择和模型优化中,Permutation Importance 更适合实际应用,因为它直接衡量特征对模型性能的贡献。当需要通过特征筛选提升模型性能时,可结合 Permutation Importance 排名进行递归特征消除。
完整代码可运行,关键步骤如下:
# 训练随机森林 + 网格搜索
grid_search = GridSearchCV(RandomForestClassifier(random_state=42),
param_grid, cv=5, scoring='accuracy')
grid_search.fit(X_train, y_train)
# Permutation Importance 分析
from eli5.sklearn import PermutationImportance
perm = PermutationImportance(best_model, scoring='accuracy')
perm.fit(X_train, y_train)
print(eli5.format_as_dataframe(
eli5.explain_weights(perm, feature_names=feature_names)))
作者简介:
读研期间发表6篇SCI数据算法相关论文,目前在某研究院从事数据算法相关研究工作,结合自身科研实践经历不定期持续分享关于Python、数据分析、特征工程、机器学习、深度学习、人工智能系列基础知识与案例。
致力于只做原创,以最简单的方式理解和学习,关注我一起交流成长。
1、关注下方公众号,点击“领资料”即可免费领取电子资料书籍。
2、文章底部点击喜欢作者即可联系作者获取相关数据集和源码。
3、数据算法方向论文指导或就业指导,点击“联系我”添加作者微信直接交流。
4、有商务合作相关意向,点击“联系我”添加作者微信直接交流。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- linux升级openssh至最新10.5p1版本
- 当算力吃掉一切可计算的逻辑,Linux和人类的关系还剩什么?
- Python|【tensorflow】基于改进粒子群算法优化LSTM的短期电力负荷预测研究
- Panel:一个用纯 Python 搞定数据分析可视化、交互式工具、和小型 Web 应用
- 第一个发现在这个网站学习Python的真是天才!!
- cocotb 使用指南——用 Python 验证你的 RTL
- 把函数当快递寄出去?Python里这波操作我服了
- Python新手分享|随手跑通一段螺旋代码,太治愈了!
- 我自己常用的Python数据分析函数与方法,给初学者的建议!
- 【python3.10.1】python3.10.1setup小白一站式安装设置教程